

示例场景:本文是一个综合示例,用来说明这类项目如何开展。它并非描述某一家具名客户,文中数字仅作示例。
背景
2024 年 1 月,我们与一家区域零售集团开始接触。该集团的电商平台在平时每天处理约 40,000 笔订单,大促期间可增至 200,000 笔以上。后端运行在 Oracle Database 19c 上,本地部署于两个托管机房。数据库约有 50TB 交易数据:订单、库存、客户记录、履约历史,以及合规要求保留的七年审计日志。
问题并不在于现有系统出了故障,而在于它越来越难以为继。过去三年,Oracle 许可费用上涨了 34%,一部分源于 Oracle 激进的审计做法,一部分源于数据量的真实增长。托管机房服务器的硬件更新已经逾期,既要为本地环境更新硬件,又要投入产品研发路线图,资本支出上无法兼顾。迁移上云是正确的战略决策。
真正让这个项目变得困难的硬性约束是:旺季窗口(9 月至次年 1 月)内不能有任何停机。项目于 2024 年 2 月启动,要求在当年 9 月之前完成生产切换。也就是说,我们大约有七个月时间,在没有维护窗口的情况下迁移一套 50TB 的在线生产数据库。
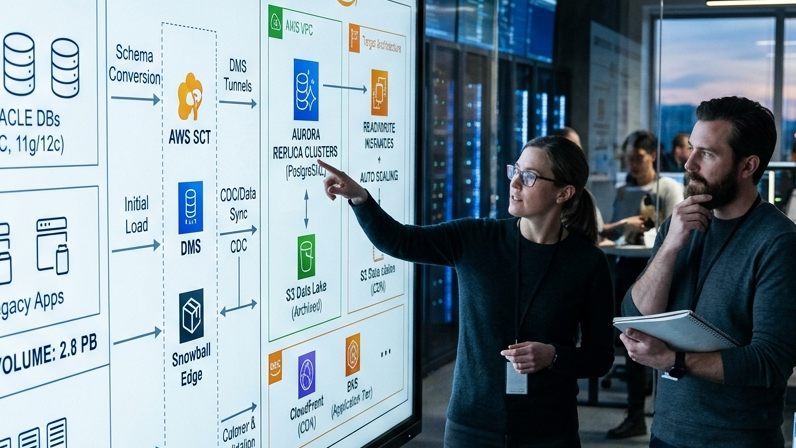
为什么选择 Aurora,以及为什么 Schema 问题并不简单
目标平台在我们介入之前就已确定:客户的 CTO 对 Aurora PostgreSQL、Aurora MySQL 和 RDS Oracle(可保留 Oracle 方言)做了评估,综合成本、性能和长期可维护性,选定了 Aurora PostgreSQL。我们认同这一结论,但其影响不小:从 Oracle 迁移到 PostgreSQL 不是简单的 lift-and-shift,而是一次数据库移植,需要处理 Oracle 特有的语法、数据类型,以及无法直接转换的过程逻辑。
客户的 Oracle 数据库包含 847 个存储过程、130 个数据库触发器和 23 个包,这些业务逻辑是 11 年开发积累下来的,体量相当可观。项目第一阶段是对整个过程层做全面审计,找出需要重写的 Oracle 特有写法。AWS Schema Conversion Tool(SCT)让我们有了一个不错的起点:约 60% 的存储过程由它自动转换,无需人工干预。其余 40% 需要不同程度的手工重写,从细微的语法调整,到 Oracle 与 PostgreSQL 执行模型存在根本差异时的逻辑重构。
最常见的转换难点包括:Oracle 的 DECODE 函数(改为 CASE 表达式);Oracle 序列与 PostgreSQL 序列(语法不同,语义兼容);Oracle 隐式的 TO_DATE 转换行为(PostgreSQL 对日期格式字符串要求更严格);以及若干使用 Oracle CONNECT BY 层级查询语法的存储过程(改为 PostgreSQL 的递归 CTE)。我们使用 Orafce 来缩小重写范围,它是一个实现 Oracle 兼容函数的 PostgreSQL 扩展。它不能省掉这项工作,但对常见写法确实能明显减少工作量。
迁移策略:双写与影子读取
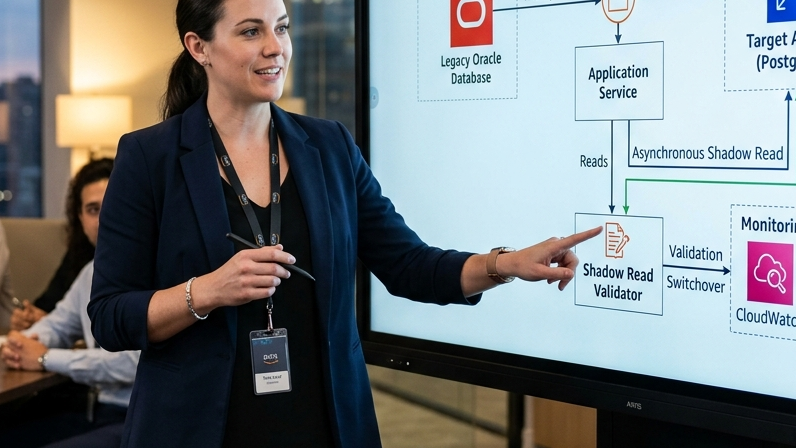
在没有维护窗口的情况下迁移 50TB 数据库,需要一套策略,让两个数据库同时保持一致,而流量继续进入源系统。我们采用双写加影子读取验证的方式,持续复制层基于 AWS Database Migration Service(DMS)构建。
架构如下。DMS 配置为持续复制模式,将 Oracle 的变更近实时地复制到 Aurora PostgreSQL:正常负载下延迟通常为 2-5 秒,流量高峰期延迟扩大到 15-20 秒。迁移期间,应用只向 Oracle 写入,也只从 Oracle 读取。同时,一个影子服务接收所有写操作的副本,并在 Aurora PostgreSQL 上回放,让我们可以验证两个数据库是否收敛到相同状态。
影子读取部分在技术上更有意思。我们构建了一个验证服务,定期从两个数据库中抽样记录:每小时 50,000 条,按哈希选取以保证在数据集中均匀分布,然后逐字段比对。差异会连同完整上下文一起记录:记录标识、字段名、Oracle 中的值、Aurora 中的值,以及两个系统中各自最近一次修改的时间戳。这让我们在迁移期间持续掌握数据完整性,也发现了开发环境中没有出现的 Schema 转换问题。
影子读取期间,我们发现了十一类差异。大多数影响很小:Oracle 默认数值类型与 PostgreSQL 的精度行为不同造成的数值精度差异、时间戳时区处理差异,以及历史数据中 NULL 与空字符串的处理差异。有两类影响较大:一个日期运算存储过程在夏令时边界的极端情况下,两个系统的行为不一致;一个触发器在处理重复键冲突时有 Oracle 特有的行为,我们在 PostgreSQL 版本中没有完全复现。两者都在并行运行期间被发现并修正,尚未对生产数据构成任何损坏风险。
分阶段推进:切换前的四个阶段
我们没有把迁移当作一次性事件,而是分成四个阶段,每个阶段都设有明确的放行/不放行标准。
第 1 阶段,Schema 与静态数据(第 1-4 周):迁移数据库 Schema、参考数据表,以及不会被频繁修改的历史归档数据。这一步建立了 Aurora 环境,并让我们在不影响生产的前提下,用真实数据量验证 Schema 转换。这一阶段使用 DMS 的首次全量加载,50TB 数据集用了 11 天完成。DMS 处理这个数据量没有困难,但我们遇到了 IAM 权限和 VPC 路由配置问题,排查花了大约两天。用过 DMS 的人对此不会意外,但值得在计划中预留时间。
第 2 阶段,持续复制与影子验证(第 5-14 周):启用 DMS 持续复制和影子读取验证服务。这一阶段持续了十周,比原计划更长,因为我们根据差异数据对 Schema 转换做了多轮改进。进入第 3 阶段的放行标准是:连续 72 小时的监控窗口内差异为零。我们在第 14 周达到了这一标准。
第 3 阶段,应用层准备(第 15-22 周):改造应用的连接层以支持双数据库连接,实现功能开关,使读流量可以先于写流量切到 Aurora,并在模拟峰值流量下完成 Aurora 环境的压力测试。从性能角度看,Aurora 不能直接替代 Oracle:两者的查询优化路径不同,若干在 Oracle 上表现良好的查询,在 Aurora 上需要增加索引或重构查询。这项工作在第 3 阶段完成,此时还没有任何生产流量接入 Aurora,压力测试使用的是生产数据克隆。
第 4 阶段,切换(第 24 周,在一个周末内完成):实际切换分步执行。首先,所有读流量通过第 3 阶段构建的功能开关切到 Aurora,写入仍然留在 Oracle,我们在真实读流量下监控 4 小时后才继续。随后,在订单量处于每日最低点的周日凌晨 2 点,我们停止应用,等 DMS 把最后的复制延迟清零,将 Aurora 提升为主库,更新应用配置使其写入 Aurora,再重启应用。总停机时间为 8 分钟。切换后的 14 天内,Oracle 继续保留作为回滚选项,并通过从 Aurora 到 Oracle 的单向复制使其保持最新。
Aurora 上的性能调优
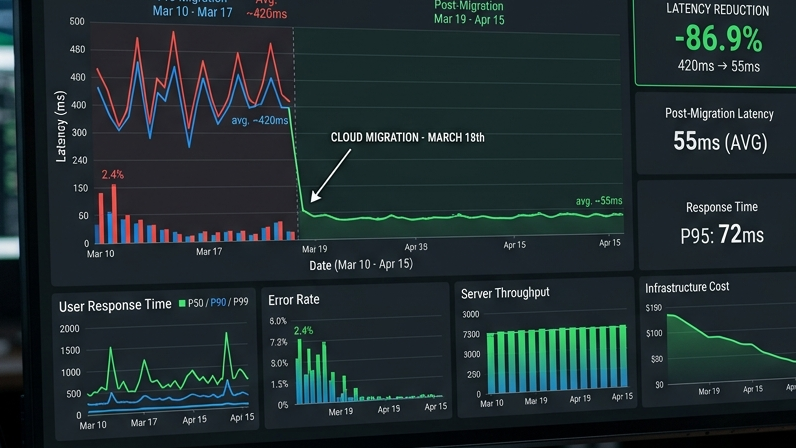
性能表现分为两个阶段。第一阶段是切换刚完成时,情况令人担忧:若干高流量查询在 Aurora 上比在 Oracle 上慢 40-60%。第二阶段是调优两周之后,结果比我们最初预计的更好。
最慢的查询是一个订单搜索,应用经常使用一组特定的过滤参数组合来调用它,这在 Aurora 的查询优化器上生成了较差的执行计划。该查询在 Oracle 上的执行计划用到了一个索引组合,而 Aurora 的规划器没有选择它。我们增加了一个复合索引,并将嵌套子查询改写为 CTE,使 Aurora 上的执行时间比 Oracle 基线低 12%。另外 8 个查询也出现了类似情况,每个都要分析执行计划、增加索引或改写查询,并在负载下验证。
Aurora 的连接池行为也需要调整。Oracle 环境使用的连接池连接生命周期很长。运行在 PostgreSQL 上的 Aurora 对连接数更敏感,连接生命周期较短、连接池积极回收时表现更好。调整 RDS Proxy 设置并修改应用的连接池配置后,与连接相关的性能问题消失了。
切换 60 天后测得的最终性能指标:平均查询响应时间比 Oracle 基线改善了 18%。p99 查询响应时间(最慢的 1% 查询)改善了 31%,主要原因是 Aurora 的 I/O 架构处理波动大的负载比 Oracle 环境使用的机械硬盘存储更稳定。另外两个可用区中的只读副本带来了 Oracle 方案所没有的冗余。
没有用上、但幸好准备了的回滚方案
任何这种规模的迁移,如果没有可信的回滚方案,就不具备上生产的条件。第 4 阶段切换能否放行,取决于回滚方案是否经过测试,而不只是写成文档。
回滚方案有三个部分。第一,切换后的 14 天内,Oracle 保持可用且数据最新,通过从 Aurora 的单向复制维护。如需回滚,流程是:停止应用向 Aurora 写入,等单向复制追平,将应用连接配置切回 Oracle,然后重启。预计回滚时间为 15 分钟,外加复制延迟清零所需的时间。我们在预发布环境中把这套流程测试了两次,然后才进行生产切换。
第二,我们保留了第 4 阶段切换前一刻的数据库快照。如果基于复制的回滚因任何原因失败,这是“最后手段”。从快照恢复 50TB 要慢得多,我们估计需要 4-6 小时,但这个选项是存在的。
第三,第 3 阶段构建的应用功能开关在切换后继续保留。如果某些应用功能在生产中出现问题,且仅限于特定的查询路径,我们可以只把这些路径的读取切回 Oracle,而无需整体回滚。这是最精细的选项,专门用来应对“部分成功”的情形,即切换大体正常,但某一块需要更多时间。
回滚方案最终没有启用。这并不说明回滚方案本身的质量,而是说明为期 14 周的影子验证达到了什么效果。到切换时,我们对数据一致性已有很高的把握,因为我们一直在持续度量。
成果与经验总结
切换六个月后的数字如下:Oracle 许可费用已取消(约每年 $1.2M),托管机房硬件费用已取消(约每年 $380K),Aurora 在当前规模下的运行成本约每年 $420K。年度净节省约 $1.16M。迁移项目成本(含 GTEMAS 服务费用、AWS 迁移抵扣额度和内部工时)约 $680K。投资回收期约 7 个月。
除成本之外,基础设施的灵活性也有明显提升。客户现在可以根据流量情况上下调整 Aurora 的读容量,不再需要等待硬件采购周期。他们的 2024 年旺季运行在 Aurora 上,没有出现事故,最高单日处理了 215,000 笔订单,创下新纪录,p99 查询延迟低于其 Oracle 基线在平时运行时的水平。
这些经验对做过同等规模迁移的人来说并不意外,但仍值得重申,因为项目往往在这些方面投入不足。影子验证不是可有可无的额外开销,它是在转换错误演变成生产事故之前发现它们的机制。Oracle 过程层需要的手工重写工作量,明显超出 SCT 的估算。目标平台上的性能调优需要生产规模的压力测试数据,而不是开发环境的估算。回滚方案需要经过测试,而不只是写成文档。
如果贵组织正在评估大规模数据库迁移,尤其是从 Oracle 迁移到 PostgreSQL 或 Aurora,那么规划、验证和调优工作决定项目成败。GTEMAS 可以帮助您从一开始就切实地界定工作范围。