

2025 年 10 月
示例情景:本文是一个综合性的示例,用来说明这类项目是如何开展的。它并非描述某个具名客户,文中数字仅作示意。
这个情景中的问题
我不会掩饰:2024 年初启动这个项目时,我以为六个月就能完成。FHIR 门面层和肿瘤学数据流水线从 2024 年年中开始分阶段上线;社会照护集成是最难的一块,直到最近几个月才开始见效。现在是 2025 年末,整个网络的整体运转才刚刚进入状态。
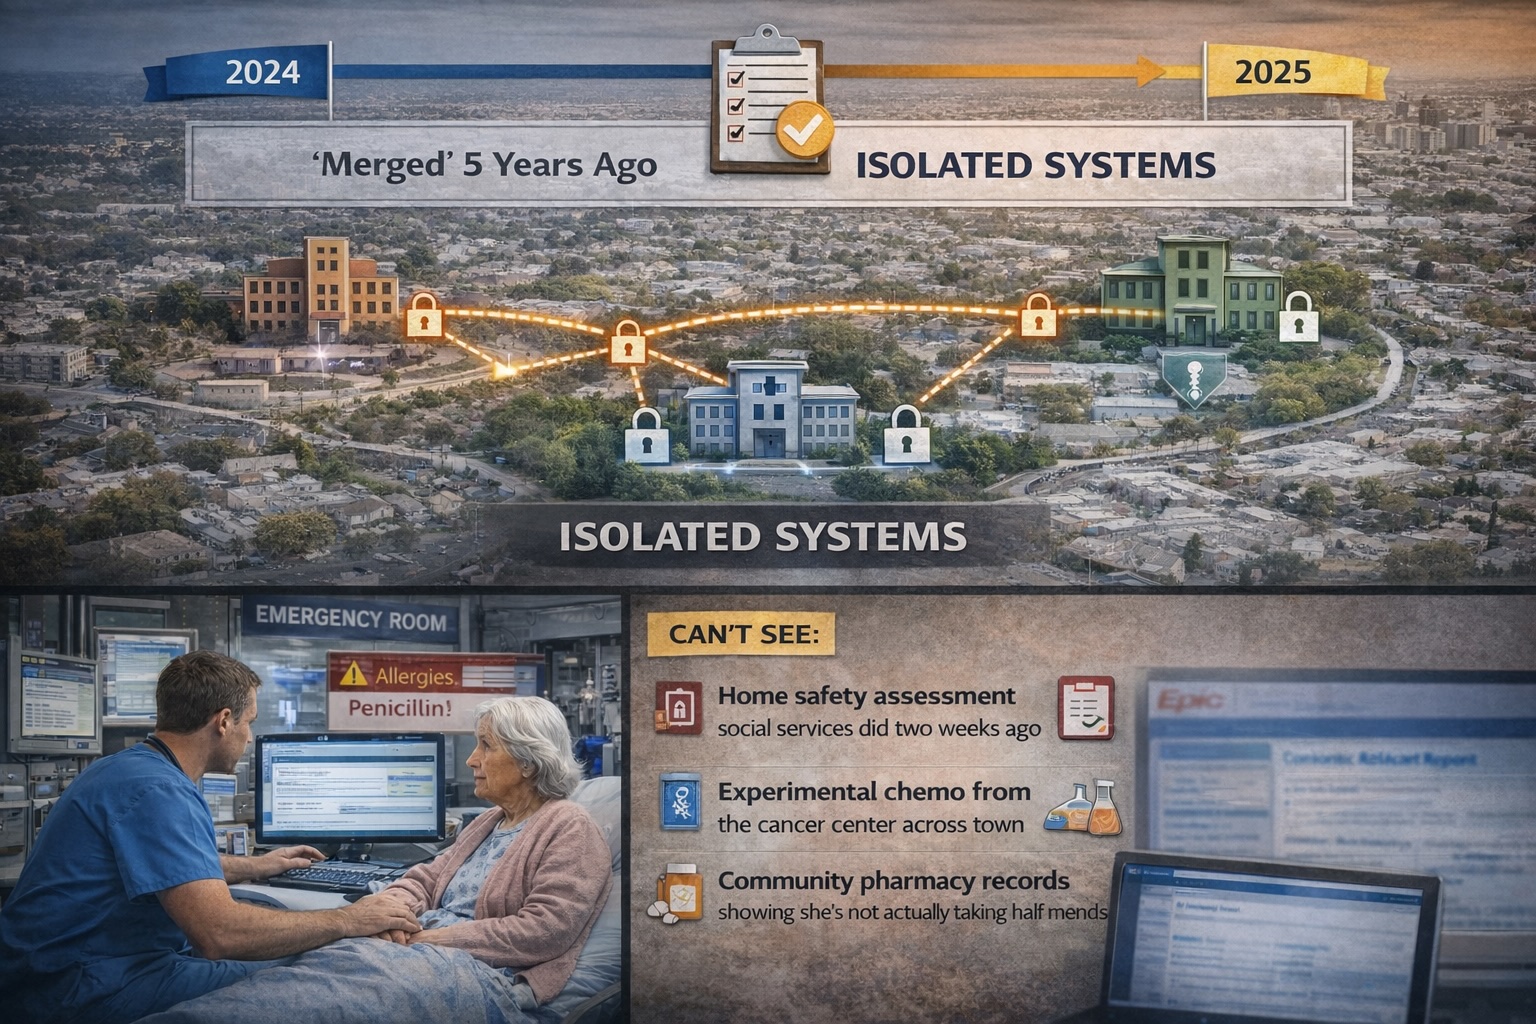
这个情景中的医疗网络由三家医院集团组成,服务约 350 万人。纸面上,它们五年前就“合并”了。实际情况呢?各家的系统仍然完全孤立。
这意味着什么:一位老年患者摔倒后被送进急诊。医生能在本院系统里看到她对青霉素过敏,很好。他们看不到的是:
- 社会服务机构两周前做的居家安全评估
- 她正在城另一头的癌症中心接受试验性化疗
- 社区药房的记录显示,她其实有一半的药没有在吃
这不是理论上的情形。在合并后的医疗网络中,这样的缺口很常见,病历不共享时,患者可能因此受到伤害。
为什么原有架构行不通
他们已经有集成基础设施:一个每天处理数百万条 HL7 v2 消息的接口引擎。问题在于,它全是点对点连接和推送式消息。
可以这样理解:如果有人三个月前给您发了一封重要邮件,却被垃圾邮件过滤器拦下了,那条信息对您来说就不存在。他们的系统就是这样运作的。
真正头疼的是接入社会照护部门。他们所谓“现代”的集成,是一条把 CSV 文件转换成 HL7 消息的自建 VPN 隧道,三名开发人员花了两个月才搭起来。而我们要接入 200 家基层医疗诊所。您自己算算。
研究团队的处境更糟。他们需要具体的数据点(肿瘤大小、生物标志物数值),但所有内容都锁在 PDF 病理报告里。有人真的在手工把数据抄进电子表格。
我们实际搭建了什么
门面策略(或者说:如何不必替换所有系统)
大家问的第一个问题是:“你们把旧系统全拆了吗?”
没有。绝对没有。那样要花数千万美元,而且耗时数年。
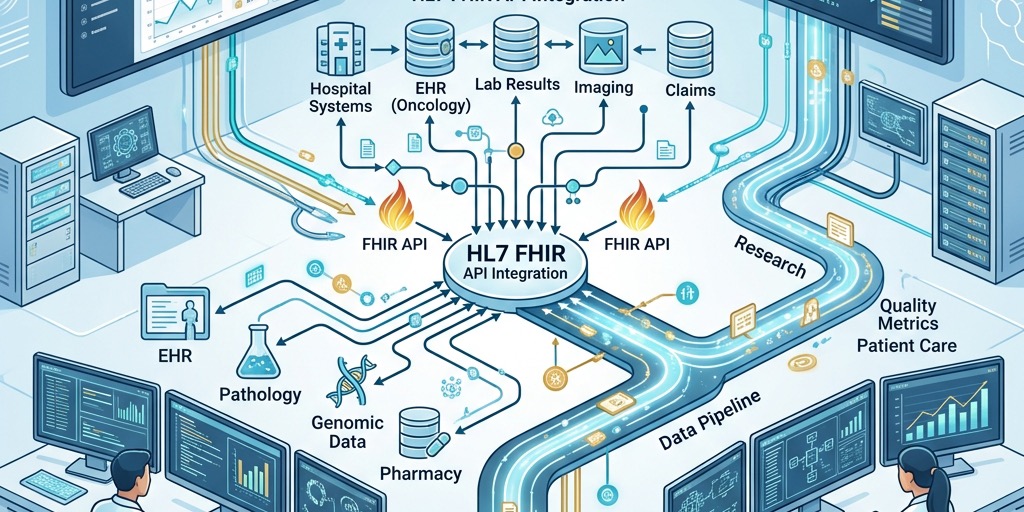
我们搭建的是所谓的 FHIR 门面层。可以把它看作架在旧数据库之上的翻译器。遗留系统原地不动,但现在有人发起现代 API 调用(比如 GET /Patient/12345)时,门面层会把它翻译成旧系统所需的、晦涩难懂的 SQL 查询或 HL7 查找。
这对简单数据效果很好。至于复杂的肿瘤学数据?我们需要更重的方案。
肿瘤学流水线(事情开始复杂的地方)
病理报告以 PDF、XML 文件的形式送来,有时甚至是扫描图像。我们搭建了一条流水线:
- 摄取:报告经由 Kafka 流进入
- 解析:ETL 服务拆解 PDF 和 XML
- FHIR 映射:转换为规范的 FHIR 资源(Patient、Observation、Specimen)
- 匿名化:在开放给研究人员之前,剔除可识别个人身份的信息
这样列出来看着很清爽。现实呢?光是搞清楚怎样从 PDF 中可靠地提取肿瘤尺寸,我们就花了三个月,因为每位病理医生的报告格式都不一样。
身份识别难题
在共享任何临床数据之前,我们必须先解决“这个人是谁?”的问题。
A 医院认识“Martha J. Jones”(ID:111)。社会服务机构认识“Martha Jones”(ID:999)。癌症中心认识“M. Jones”(ID:ABC-7734)。
我们实现了 Master Patient Index(主患者索引),基于 FHIR 的 Patient 资源和 $match 操作。现在查询某位患者时,系统会找到“黄金记录”,并把三个身份关联起来。
第一次在生产数据上运行时,我们发现了约 8,000 条重复的患者记录。有些人在整个网络里有四个不同的 ID。
我们真正创新的地方:社会照护集成
这是最难的部分,坦白说,也是我对我们的工作最自豪的地方。
医院系统使用 SNOMED-CT、LOINC 这样的标准化医学编码。而社会照护记录呢?是“患者行走困难”“购物需要帮助”这样的自由文本备注。
我们以我在别处没见过的方式使用了 FHIR 的 CarePlan 和 Consent 资源:
CarePlan:社工制定的支持计划,会直接显示在医院出院护士的屏幕上。不是作为 PDF 附件,而是作为结构化的、可据以行动的数据。
Consent:这一项至关重要。我们构建了细粒度的同意控制,使患者可以授权向医院共享其 HIV 状态,却不向养老院管理人员共享。
对于自由文本的问题,我们把所有内容送进 NLP 引擎,把“行走困难”映射到表示行动障碍的标准 SNOMED 编码。于是,当医生搜索行动问题时,社会照护记录也会出现,尽管它们最初只是纯文本。
安全(或者说:我们如何避免制造一场数据泄露噩梦)
跨机构开放 API 会让安全人员紧张。这很合理。
我们使用了 SMART on FHIR,它基本上是把授权委托给 OAuth 2.0。实际流程是这样的:
医生在 Epic 系统里点击“查看社区记录”。这会在 iframe 中启动我们的应用,并传入上下文(哪位用户、哪位患者)。我们的授权服务器检查其凭据和权限。如果身份合法,就会发放一个访问令牌,范围严格限定在其所需之内,比如只读访问 Observation,别的都不行。
测试中有过一次险情:某个令牌没有正常过期。这个问题很快修复了。
实际发生了什么变化
自 2024 年年中 FHIR 门面层上线以来:
重复的化验减少了 30%,因为急诊医生终于能看到专科中心的近期结果。这是实打实的成本节约,也让患者少受罪。没有人愿意被扎两次针。
出院规划从四天缩短到一天半。原来,医院出院团队能立刻看到社会照护计划时,就不必连着三天互相打电话找人了。
用药错误下降了 18%。我们把医院处方和社区药房配药记录汇总到一个 MedicationStatement 视图里。
研究团队把队列组建时间从四个月缩短到两周。他们现在真的在发表论文了,而不是把所有时间都花在整理数据上。
我们学到了什么(走了弯路才学到)
不要映射所有内容。我们起初试图把每个遗留数据库的每个字段都转换成 FHIR。三个月过去,几乎没有进展。我们果断调转方向:只映射对您的具体用例在临床上至关重要的内容,其余的可以等到第二版。
严格校验。早期,不良数据不断让我们的应用崩溃。我们在 API 网关上实施了严格校验。如果某个系统发来的 Patient 资源没有出生日期(在我们的 Profile 中是必填项),我们就会拒收,并返回详细的错误信息。各系统很快就把数据质量整顿好了。
文化问题比技术问题更难。社工不想再多一个登录、再多一个系统。我们用 iframe 把 FHIR 查看器直接嵌入他们现有的个案管理工具。他们甚至不知道自己在用“新技术”,它就在熟悉的界面里直接可用。
接下来
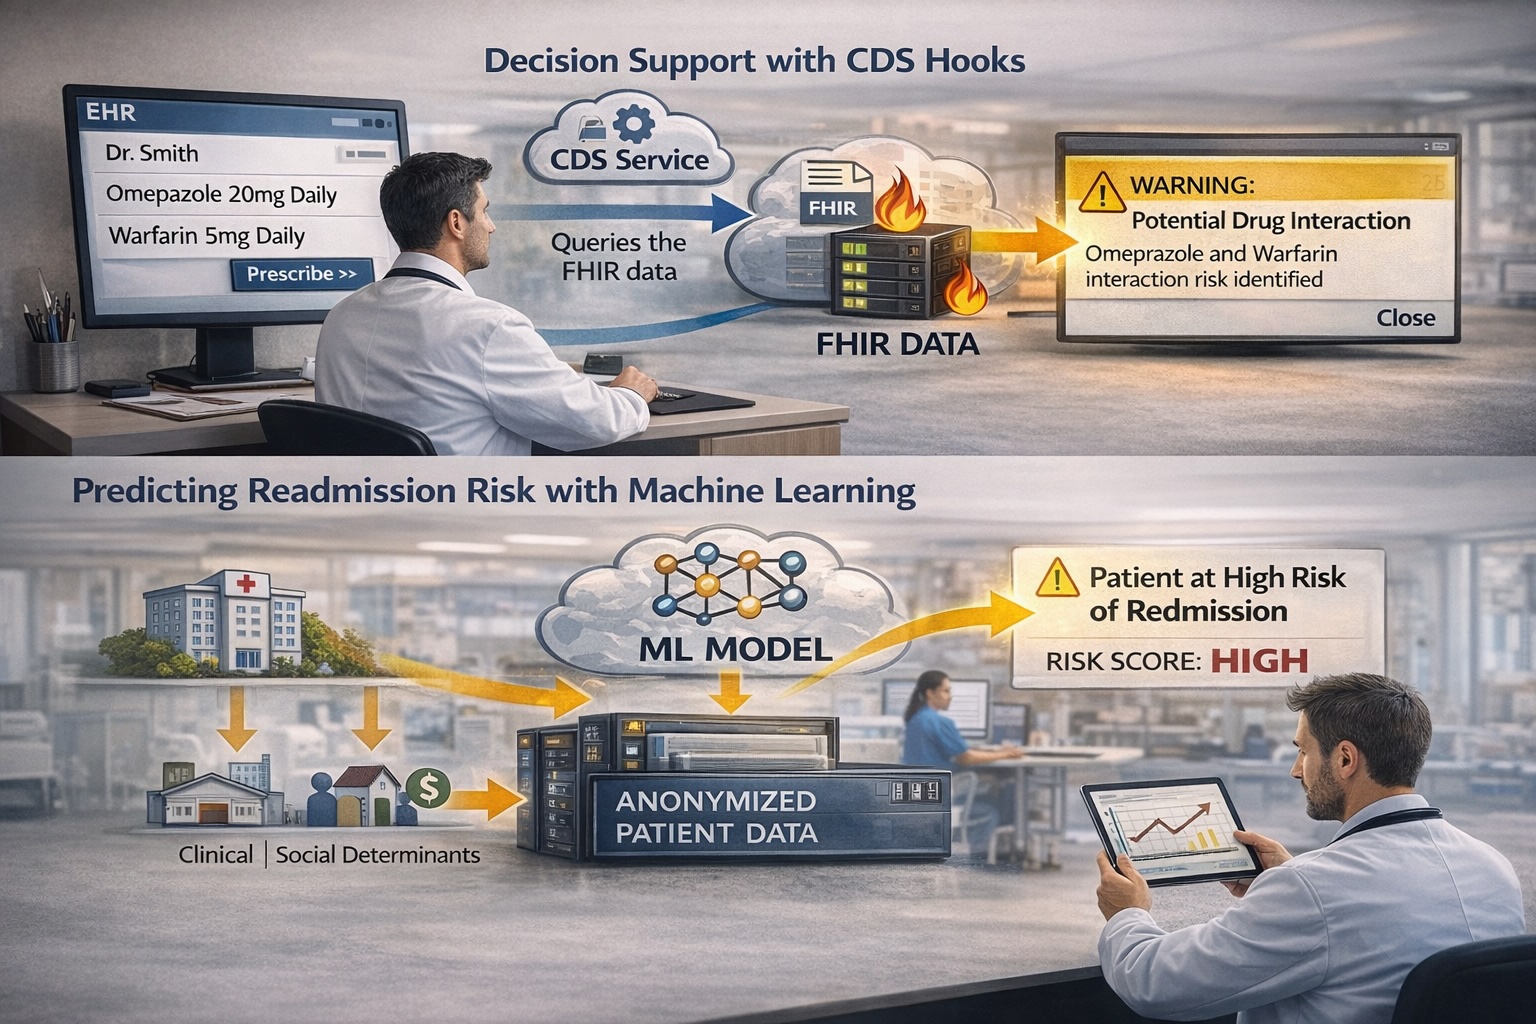
基础打好之后,我们正在转向决策支持,实施 CDS Hooks。医生开药时,服务会检查 FHIR 数据中的禁忌症,并可以实时弹出警告。
我们还在用匿名化数据训练 ML 模型来预测再入院风险,把临床数据和社会决定因素数据结合起来。当所有数据各自孤立时,这是不可能做到的。
如果您正在考虑做类似的项目:预算的时间要比您想的更多,尽早争取临床人员的支持,并且请不要试图在第一版里解决所有问题。
如果您面临类似的挑战,我很乐意具体聊聊。我们犯过的错误,您不必再犯一遍。
想探讨您的互操作性挑战?欢迎联系我们。