

2025年10月
例示シナリオ:この記事は、この種のプロジェクトがどのように進められるかを示すために書いた、複数の要素を組み合わせた例です。実名の顧客を描いたものではなく、数値も例示です。
このシナリオにおける問題
正直に言うと、2024年の初めにこのプロジェクトを始めたときは、半年で終わると考えていました。FHIRファサードとがん領域のパイプラインは2024年半ばから段階的に稼働しましたが、最も難しかった社会ケアの連携は、効果が出始めたのがここ数か月です。いまは2025年の終わり近くで、ネットワーク全体としてようやく軌道に乗ってきたところです。
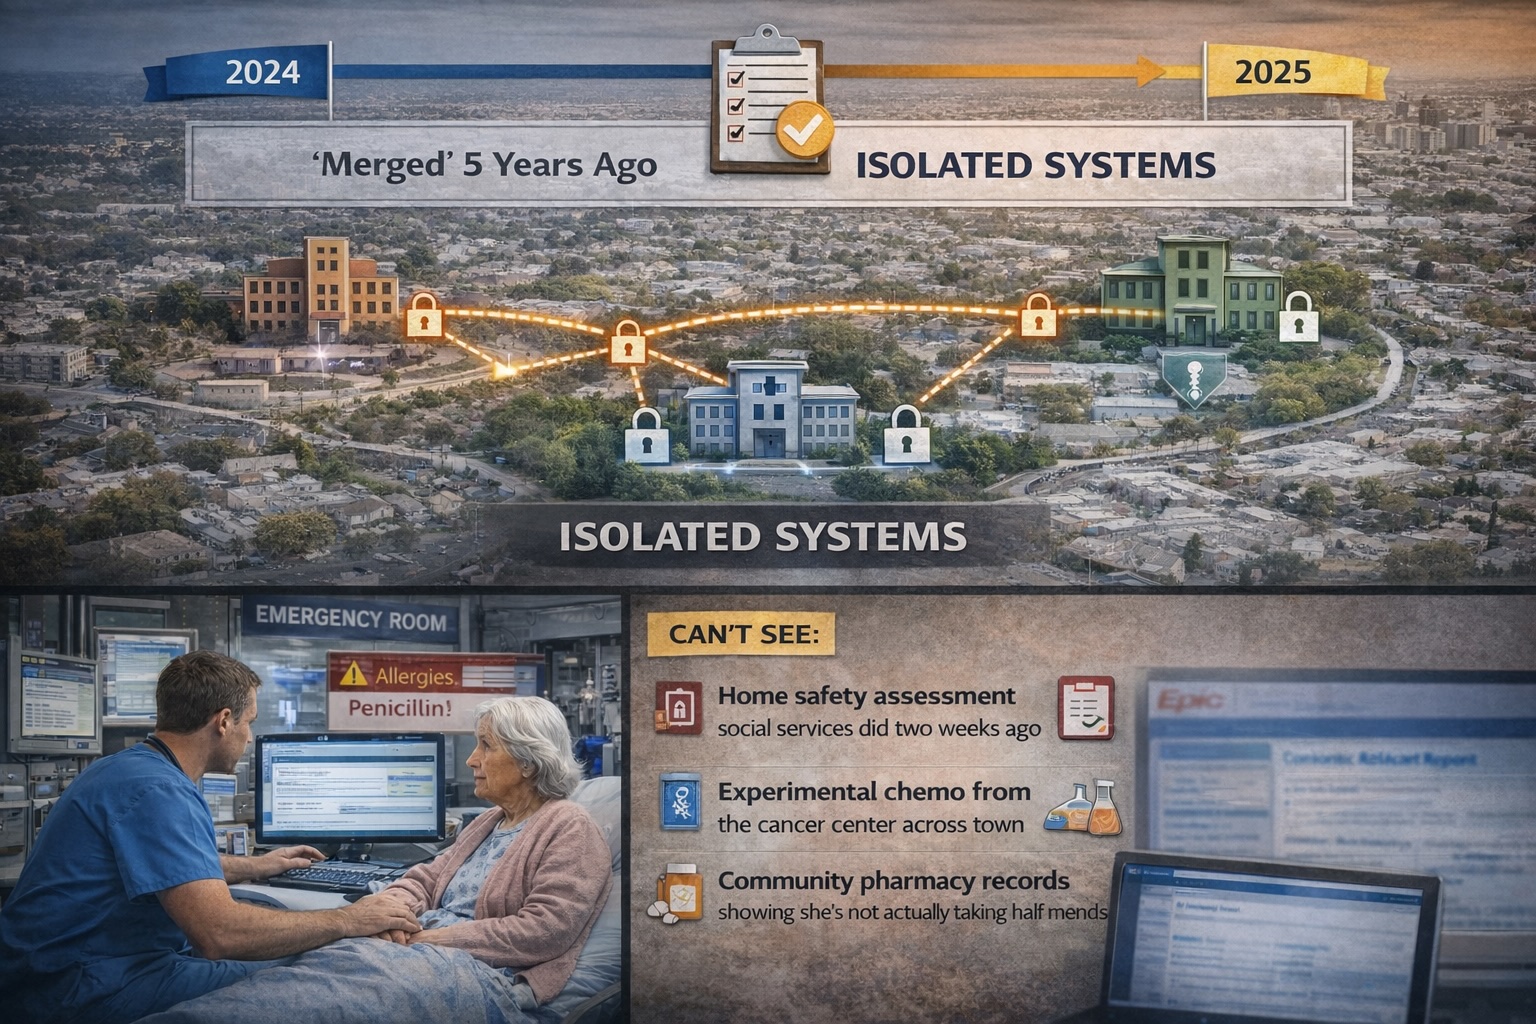
このシナリオの医療ネットワークは、3つの病院グループにまたがり、約350万人にサービスを提供しています。書類の上では、5年前に「統合」されていました。実際には、各システムは完全に分断されたままでした。
それが現場で何を意味したか、例を挙げます。高齢の女性が転倒して救急外来に来ました。医師は、自院のシステムで彼女がペニシリンアレルギーであることを確認できます。ここまでは問題ありません。見えないものは次の通りです。
- 2週間前に社会福祉サービスが行った、自宅の安全評価
- 市内の別のがんセンターで、試験的な化学療法を受けていること
- 地域の薬局の記録から分かる、処方された薬の半分を実際には飲んでいないこと
これは理屈の話ではありません。統合された医療ネットワークでは、こうした情報の欠落はよくあり、記録が共有されなければ患者が被害を受けることがあります。
既存の構成が機能していなかった理由
連携の基盤自体はすでにありました。1日に数百万件のHL7 v2メッセージを処理するインターフェースエンジンです。問題は、すべてがポイントツーポイントの接続とプッシュ型のメッセージングだったことです。
たとえて言えば、3か月前に誰かが大事なメールを送ってくれたのに、迷惑メールフィルターに引っかかっていた場合、あなたにとってその情報は存在しないのと同じです。彼らのシステムは、そういう仕組みでした。
特に厄介だったのは、社会ケア部門との接続です。「最新」とされていた連携は、CSVファイルをHL7メッセージに変換するカスタムのVPNトンネルでした。構築に開発者3人で2か月かかりました。接続が必要なプライマリケアのクリニックは200か所あります。計算してみてください。
研究チームの状況はさらに悪いものでした。彼らが必要としていたのは腫瘍のサイズやバイオマーカー値といった個別のデータですが、すべてがPDFの病理報告書の中に閉じ込められていました。担当者が文字どおり、手作業でデータをスプレッドシートに書き写していたのです。
実際に構築したもの
ファサード戦略(すべてを置き換えずに済ませる方法)
最初に必ず聞かれるのは、「古いシステムはすべて撤去したのですか」という質問です。
いいえ。まったくしていません。そうしていたら、数千万ドルの費用がかかり、何年も要したはずです。
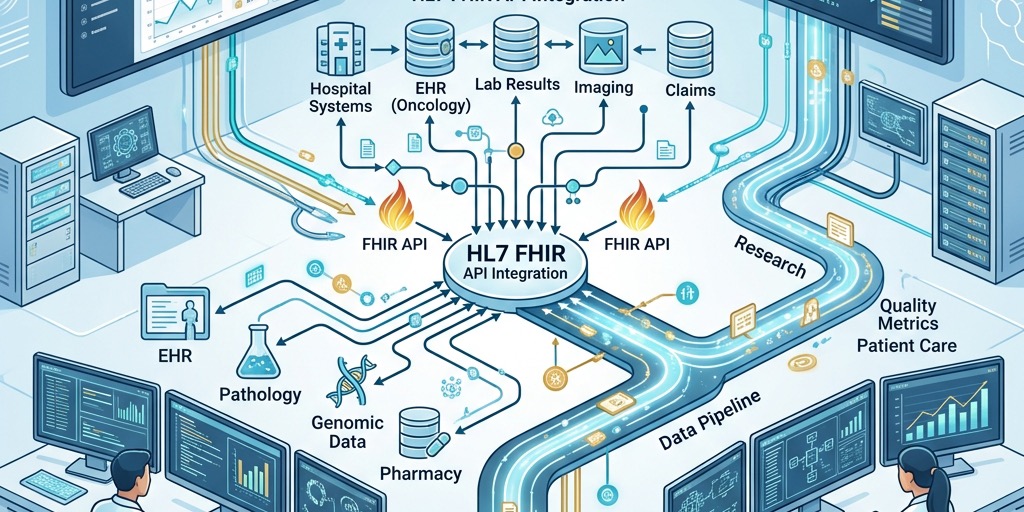
代わりに、FHIRファサードと呼ばれるものを構築しました。古いデータベースの上に置く翻訳役だと考えてください。レガシーシステムはそのまま同じ場所に残ります。ただ、誰かが最新のAPI呼び出し(たとえばGET /Patient/12345)を行うと、ファサードがそれを、旧システムが必要とする難解なSQLクエリやHL7の参照に変換します。
単純なデータであれば、この方法で十分にうまくいきました。複雑ながん領域のデータには、もっとしっかりした仕組みが必要でした。
がん領域のパイプライン(複雑さが増したところ)
病理報告書は、PDF、XMLファイル、ときにはスキャン画像で届きました。そこで、次のパイプラインを構築しました。
- 取り込み – 報告書をKafkaのストリームに流す
- 解析 – ETLサービスがPDFとXMLを分解する
- FHIRへのマッピング – 適切なFHIRリソース(Patient、Observation、Specimen)に変換する
- 匿名化 – 研究者がアクセスする前に、個人を特定できる情報を取り除く
こうして並べると、すっきりして見えます。実際はそうではありません。病理医ごとに報告書の書式が違うため、PDFから腫瘍の寸法を確実に抽出する方法を見つけるだけで3か月かかりました。
患者の同一性という壁
臨床データを共有する前に、「この人は誰なのか」という問題を解決する必要がありました。
A病院では「Martha J. Jones」(ID: 111)、社会福祉サービスでは「Martha Jones」(ID: 999)、がんセンターでは「M. Jones」(ID: ABC-7734)として登録されていました。
Master Patient Indexを、FHIRのPatientリソースと$matchオペレーションを使って実装しました。患者を検索すると、システムが「ゴールデンレコード」を見つけ、3つの識別情報を紐づけます。
本番データで初めて実行したとき、重複した患者レコードが約8,000件見つかりました。ネットワーク全体で4つの異なるIDを持っていた人もいました。
本当に工夫したところ:社会ケアの連携
ここが最も難しい部分で、正直なところ、私たちが最も誇りに思っている部分でもあります。
病院のシステムは、SNOMED-CTやLOINCといった標準化された医療コードを使います。社会ケアの記録は、「歩行に困難がある」「買い物に手助けが必要」といった自由記述のメモです。
FHIRのCarePlanとConsentのリソースを、他では見たことのない使い方で活用しました。
CarePlan: ソーシャルワーカーの支援計画が、病院の退院担当看護師の画面にそのまま表示されます。PDFの添付ではなく、構造化された、すぐに行動に移せるデータとしてです。
Consent: こちらは非常に重要です。患者が、HIVの感染状況を病院とは共有しても、介護施設の管理者とは共有しないと許可できる、きめ細かな同意の管理を構築しました。
自由記述の問題には、すべてのテキストをNLPエンジンに通し、「歩行に困難がある」を、運動機能の障害を表す適切なSNOMEDコードに対応付けました。これで、医師が運動機能の問題を検索すると、もとは平文だった社会ケアの記録も表示されるようになりました。
セキュリティ(データ侵害の悪夢を作らないために)
組織をまたいでAPIを開放することに、セキュリティの担当者が神経質になるのは当然です。
私たちはSMART on FHIRを使いました。認可をOAuth 2.0に委ねる仕組みです。実際の流れは次の通りです。
医師が、自分のEpicシステムで「View Community Record」をクリックします。すると、私たちのアプリがiframeで起動し、コンテキスト(どのユーザーか、どの患者か)が渡されます。認可サーバーが資格情報と権限を確認し、正当であれば、必要な範囲だけに絞ったアクセストークンが発行されます。たとえばObservationの読み取り専用で、それ以外は許可されません。
テストの段階で、トークンが正しく失効しないケースが1件あり、ひやりとしました。すぐに修正しています。
実際に何が変わったか
2024年半ばにFHIRファサードが稼働してから、次の変化がありました。
重複する検査が30%減りました。救急外来の医師が、専門センターの最近の結果をようやく確認できるようになったためです。これは実際のコスト削減であり、患者の負担の軽減でもあります。針を2度刺されたい人はいません。
退院計画にかかる期間が、4日から1日半になりました。病院の退院チームが社会ケアの計画をすぐに確認できるようになると、3日間も電話で連絡を取り合う必要がなくなったからです。
投薬ミスが18%減りました。病院の処方と地域薬局の調剤の情報を、1つのMedicationStatementのビューに集約しました。
研究チームのコホート作成にかかる時間が、4か月から2週間になりました。データの整理に時間を取られていた研究者が、いまは実際に論文を発表しています。
苦労して学んだこと
すべてをマッピングしない。当初は、レガシーデータベースのすべてのフィールドをFHIRに変換しようとしました。3か月経っても、ほとんど進んでいませんでした。そこで大きく方針を変えました。それぞれのユースケースで臨床上重要なものだけをマッピングします。ほかはv2まで待てます。
検証を徹底する。初期には、不正なデータが原因でアプリが何度も落ちました。そこで、APIゲートウェイで厳格な検証を実装しました。システムが生年月日のないPatientリソース(私たちのプロファイルでは必須です)を送ってきたら、詳細なエラーメッセージを付けて拒否します。各システムは、データ品質を一気に改善しました。
技術よりも、組織文化の問題のほうが難しい。ソーシャルワーカーは、新しいログインも新しいシステムも望みませんでした。そこで、FHIRビューアーをiframeで、彼らが使っている既存のケース管理ツールの中に直接埋め込みました。彼らは「新しい技術」を使っていることにすら気づいていません。使い慣れた画面の中で、ただ動いたのです。
これから
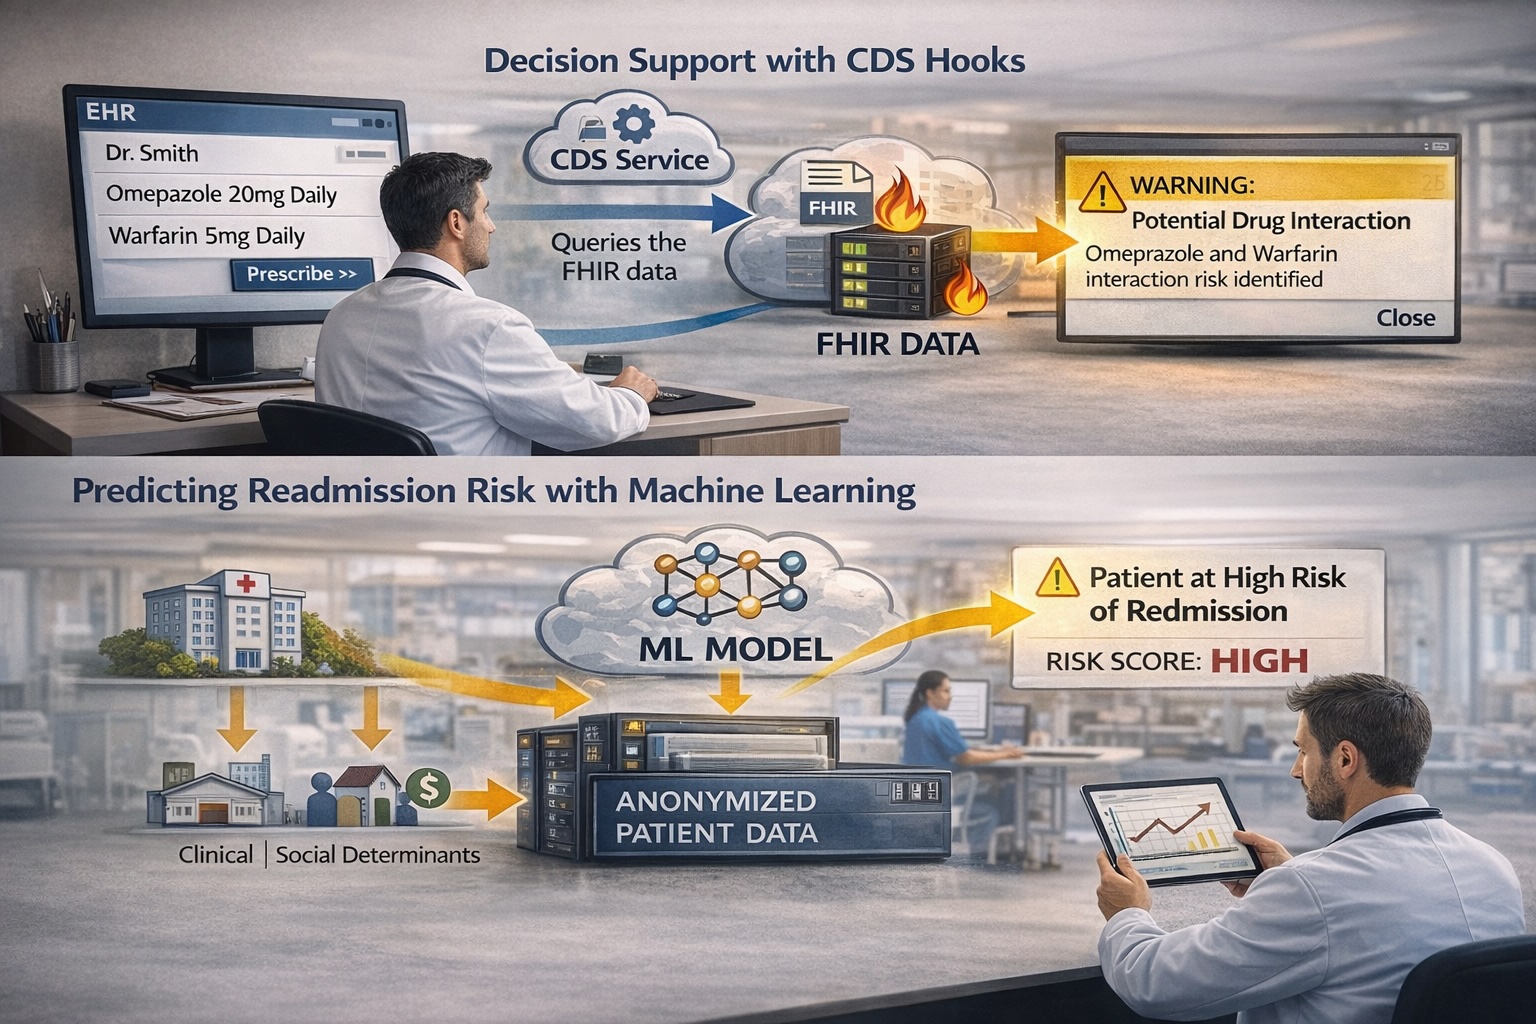
基盤ができたので、次は意思決定支援に進みます。CDS Hooksを実装しています。医師が薬を処方すると、サービスがFHIRのデータで禁忌を確認し、リアルタイムに警告を表示できます。
匿名化したデータで、再入院リスクを予測する機械学習モデルの学習も進めています。臨床データと社会的決定要因のデータを組み合わせるもので、すべてが分断されていた頃には不可能でした。
同じようなプロジェクトを検討しているなら、思っているより多くの時間を見込み、臨床スタッフの賛同を早い段階で得て、最初のバージョンですべての問題を解決しようとしないでください。
似た課題に取り組んでいる方には、具体的な内容を喜んでお話しします。私たちが犯した失敗を、繰り返す必要はありません。
相互運用性の課題について相談したい方は、ぜひご連絡ください。