

例示のシナリオ:この記事は、この種のプロジェクトがどう進むかを示すために書いた合成例です。特定のクライアントを描いたものではなく、数値も例示です。
背景
2024年1月、私たちはある地域の小売グループと協議を始めました。同社のEコマースプラットフォームは、平常時で1日あたり約40,000件、大型セール時には200,000件以上の注文を処理していました。バックエンドはOracle Database 19cで稼働し、2か所のコロケーション型データセンターにオンプレミスで置かれていました。データベースには約50TBのトランザクションデータが入っていました。注文、在庫、顧客レコード、出荷履歴に加え、コンプライアンス上の保持義務がある7年分の監査ログです。
問題は、現行の構成が壊れかけていたことではありません。この構成を続けること自体が難しくなっていたのです。Oracleのライセンス費用は過去3年で34%増えました。一因はOracleの強引な監査、もう一因はデータ量の実際の増加です。コロケーションサーバーのハードウェア更改は時期を過ぎていましたが、オンプレミスを更改しながら製品開発ロードマップにも投資するだけの設備投資は現実的ではありませんでした。クラウド移行は、戦略的に正しい判断でした。
このプロジェクトを本当に難しくしていたのは、9月から1月までの繁忙期にダウンタイムを許容できないという制約です。プロジェクトの開始は2024年2月で、次の9月までに本番の切り替えを終えることが必須条件でした。メンテナンスウィンドウなしで、稼働中の本番データベース50TBを約7か月で移行する必要があったのです。
なぜAuroraか、そしてスキーマ変換が単純ではなかった理由
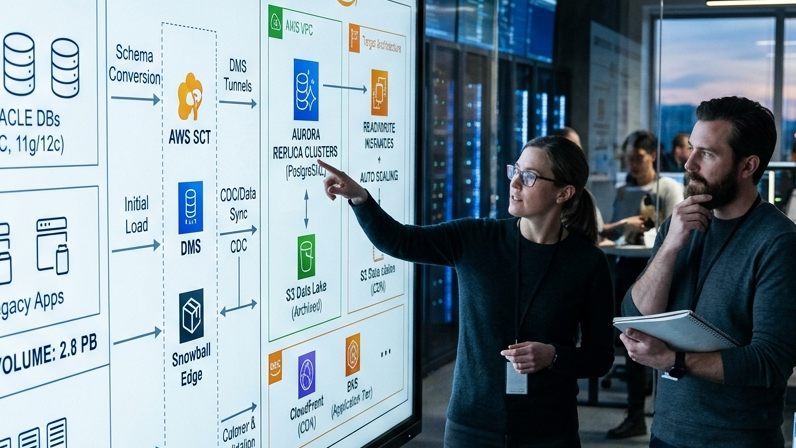
移行先のプラットフォームは、私たちが参画する前に決まっていました。クライアントのCTOがAurora PostgreSQL、Aurora MySQL、RDS Oracle(Oracleの方言をそのまま使えます)を比較し、コスト、性能、長期的な保守性の観点からAurora PostgreSQLを選んでいたのです。私たちもこの結論に同意しましたが、影響は大きいものでした。OracleからPostgreSQLへの移行は、単純なリフト・アンド・シフトではありません。Oracle固有の構文、データ型、そして直接は変換できない手続きロジックに対応するデータベースのポーティングです。
クライアントのOracleデータベースには、ストアドプロシージャ847本、データベーストリガー130個、パッケージ23個がありました。11年の開発で積み上がった、相当な量のビジネスロジックです。プロジェクトの最初のフェーズは、この手続き層を全面的に棚卸しし、書き直しが必要なOracle固有の構文を洗い出すことでした。AWS Schema Conversion Tool(SCT)のおかげで出だしは楽になりました。ストアドプロシージャの約60%は、手作業なしで自動変換できたのです。残りの40%は、軽微な構文修正から、OracleとPostgreSQLで実行モデルが根本的に異なるためのロジックの組み直しまで、手作業での書き直しが必要でした。
変換で多かった課題は次のとおりです。OracleのDECODE関数(CASE式に置き換え)、OracleのシーケンスとPostgreSQLのシーケンス(構文は異なるが意味は互換)、OracleのTO_DATEによる暗黙の変換(PostgreSQLは日付書式文字列に対してより厳格)、そしてOracleのCONNECT BYによる階層クエリ構文を使っていた複数のストアドプロシージャ(PostgreSQLの再帰CTEに置き換え)です。書き直しの範囲を減らすため、Oracle互換関数を実装するPostgreSQL拡張のOrafceを使いました。作業がなくなるわけではありませんが、よくあるパターンではかなり減らせます。
移行戦略:デュアルライトとシャドウリード
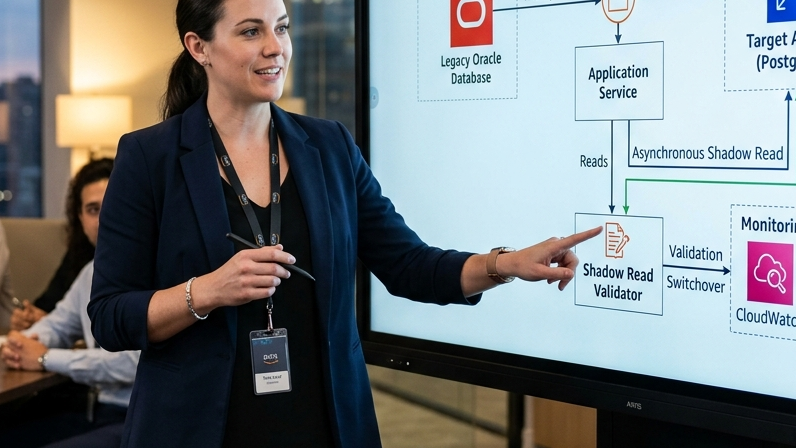
メンテナンスウィンドウなしで50TBのデータベースを移行するには、ソースシステムにトラフィックが流れ続ける間、2つのデータベースを同時に整合した状態に保つ戦略が必要です。私たちは、検証用のシャドウリードを組み合わせたデュアルライト方式を採用し、継続的なレプリケーション層にはAWS Database Migration Service(DMS)を使いました。
構成は次のとおりです。DMSを継続レプリケーションモードに設定し、OracleからAurora PostgreSQLへ変更をほぼリアルタイムで複製しました。通常の負荷では2–5秒、ピーク時には15–20秒の遅延でした。移行期間中、アプリケーションの書き込みと読み取りはOracleだけで行いました。並行して、シャドウサービスがすべての書き込み操作のコピーを受け取ってAurora PostgreSQLに再生し、2つのデータベースが同じ状態に収束することを確認できるようにしました。
技術的により面白かったのは、シャドウリードの部分です。両方のデータベースから定期的にレコードをサンプリングし、フィールド単位で比較する検証サービスを作りました。サンプルは1時間あたり50,000件で、データセット全体に均等に散らばるようハッシュで選びました。不一致は、レコード識別子、フィールド名、Oracleの値、Auroraの値、各システムでの最終更新タイムスタンプという全文脈つきで記録しました。これにより、移行期間中のデータ整合性を継続的に把握でき、開発環境では現れなかったスキーマ変換の問題も検出できました。
シャドウリードの期間中に、不一致は11の種類が見つかりました。ほとんどは軽微なものでした。Oracleの既定の数値型とPostgreSQLとで精度の扱いが異なる問題、タイムスタンプのタイムゾーン処理の違い、レガシーデータにおけるNULLと空文字列の扱いの違いです。重大なものは2つありました。夏時間の境界をまたぐ特殊なケースで、2つのシステム間で動作が異なった日付計算のストアドプロシージャが1つ。そして、重複キー違反を処理するOracle固有の動作を持ち、PostgreSQL版では完全に再現できていなかったトリガーが1つです。どちらも並行運用の期間中に見つかって修正され、本番でデータが壊れるおそれが生じる前に解消できました。
段階的アプローチ:切り替えまでの4段階
移行を一度きりのイベントとして扱わず、各段階に進行可否の判断基準を設けた4つのフェーズに分けました。
フェーズ1:スキーマと静的データ(1–4週目)。データベースのスキーマ、参照データのテーブル、そして更新されない履歴アーカイブデータを移行しました。これでAurora環境が立ち上がり、本番に何のリスクもなく、実際のデータ量でスキーマ変換を検証できました。このフェーズでは最初のDMSフルロードを使い、50TBのデータセットで完了まで11日かかりました。DMSは量に問題なく対応しましたが、IAM権限とVPCルーティング設定の問題で、デバッグに約2日を費やしました。DMSを使ったことがあれば予想できる問題ですが、あらかじめ計画に入れておく価値があります。
フェーズ2:継続レプリケーションとシャドウ検証(5–14週目)。DMSの継続レプリケーションとシャドウリード検証サービスを有効にしました。このフェーズは10週間続き、当初の計画より長くなりました。不一致のデータを使って、スキーマ変換を繰り返し改善したためです。フェーズ3に進む判断基準は、72時間の連続監視で不一致がゼロになることでした。この基準を満たしたのは14週目です。
フェーズ3:アプリケーション層の準備(15–22週目)。アプリケーションの接続層を2つのデータベース接続に対応させ、書き込みトラフィックより先に読み取りトラフィックをAuroraへ移せるフィーチャーフラグを実装しました。また、想定したピーク時のトラフィックを再現して、Aurora環境の負荷テストを完了しました。性能の面で、AuroraはOracleをそのまま置き換えられるものではありません。クエリ最適化の経路が異なり、Oracleでは速かった複数のクエリで、Auroraではインデックスの追加やクエリの組み直しが必要でした。この作業は、本番のトラフィックがAuroraに触れる前のフェーズ3で、本番データのクローンを使った負荷テストとして行いました。
フェーズ4:切り替え(24週目、1回の週末で実施)。実際の切り替えは段階的に行いました。まず、書き込みをOracleに残したまま、すべての読み取りトラフィックをAuroraに移しました(フェーズ3で作ったフィーチャーフラグを使用)。実際の読み取りトラフィックの下で4時間監視してから、次に進みました。続いて、1日の注文量が最も少ない日曜午前2時にアプリケーションを停止し、DMSに最後のレプリケーション遅延をゼロまで消化させ、Auroraをプライマリに昇格し、書き込み先をAuroraにするようアプリケーション設定を更新して、アプリケーションを再起動しました。ダウンタイムは合計8分でした。切り替え後14日間はロールバックの選択肢としてOracleを使える状態で残し、ロールバック期間中も最新に保つため、AuroraからOracleへの一方向レプリケーションを続けました。
Auroraでのパフォーマンスチューニング
性能の話は2章に分かれます。切り替え直後の第1章は懸念すべきものでした。トラフィックの多いいくつかのクエリが、Oracleのときより40–60%遅くなったのです。2週間のチューニングを経た第2章は、当初の想定を上回る結果になりました。
最も遅かったのは注文検索です。アプリケーションが頻繁に実行するクエリで、複数のフィルタパラメータの組み合わせにより、Auroraのクエリオプティマイザが不利な実行計画を選んでいました。このクエリのOracleの実行計画は、Auroraのプランナーが選ばないインデックスの組み合わせを使っていました。複合インデックスを追加し、ネストしたサブクエリではなくCTEを使うようクエリを書き直すと、Auroraでの実行時間はOracleの基準値を12%下回りました。同様のパターンはほかの8本のクエリにもあり、それぞれ実行計画の分析、インデックスの追加またはクエリの書き直し、負荷下での検証が必要でした。
Auroraのコネクションプーリングの挙動にも調整が必要でした。Oracle環境のコネクションプーリングは、非常に長く生きる接続を使っていました。PostgreSQLで動くAuroraは接続数の影響を受けやすく、接続の寿命を短くして、プールを積極的に再利用する運用が向いています。RDS Proxyの設定を調整し、アプリケーションのコネクションプール設定を見直した後、接続に起因する性能の問題はなくなりました。
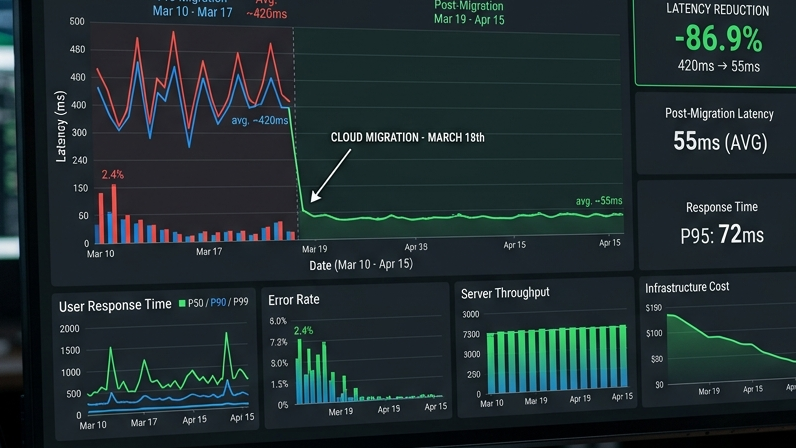
切り替えから60日後に測定した最終的な性能は次のとおりです。平均クエリ応答時間はOracleの基準値より18%改善しました。p99のクエリ応答時間(最も遅い1%のクエリ)は31%改善しました。主な理由は、ばらつきの大きいワークロードでも、AuroraのI/Oアーキテクチャのほうが、Oracle環境が使っていた回転式ディスクのストレージより安定して処理できることです。さらに2つのアベイラビリティゾーンに置いたリードレプリカが、Oracle構成にはなかった冗長性を加えました。
使わずに済んだが、あってよかったロールバック計画
この規模の移行で、現実的なロールバック計画がなければ、本番に出す準備はできていません。フェーズ4の切り替えを進める条件は、ロールバック計画が文書化されているだけでなく、テスト済みであることでした。
ロールバック計画は3つの要素からなります。第1に、切り替え後14日間、AuroraからOracleへの一方向レプリケーションでOracleを最新の状態に保ち、使える状態で残しました。ロールバックが必要になった場合の手順は、Auroraへのアプリケーションの書き込みを止め、一方向レプリケーションが追いつくのを待ち、アプリケーションの接続設定をOracleに戻し、再起動するというものです。見込みのロールバック時間は、15分にレプリケーション遅延の消化時間を加えたものでした。本番の切り替え前に、ステージング環境で2回テストしました。
第2に、フェーズ4の切り替えの直前に取得したデータベースのスナップショットを保管しました。レプリケーションによるロールバックが何らかの理由で失敗した場合の「最後の手段」です。50TBをスナップショットから復元するにはかなり時間がかかり、4–6時間と見積もっていましたが、選択肢としては用意してありました。
第3に、フェーズ3で作ったアプリケーションのフィーチャーフラグを、切り替え後も残しました。特定のアプリケーション機能が本番で問題を示し、それが特定のクエリ経路に限られていた場合、全体をロールバックせずに、その経路だけをOracleからの読み取りに戻せます。最もピンポイントな選択肢で、切り替えの大部分は問題なく動いているものの一部の領域にもう少し時間が必要な、「部分的な成功」の場面に対応するために設計しました。
ロールバック計画が発動されることはありませんでした。これはロールバック計画の質を述べているのではなく、14週間のシャドウ検証期間が何を成し遂げたかを述べています。切り替えの時点で、私たちはデータの整合性を継続的に測定していたため、高い確信を持てていたのです。
成果と教訓
切り替えから6か月後の数字は次のとおりです。Oracleのライセンス費用はなくなり(年間約$1.2M)、コロケーションのハードウェア費用もなくなりました(年間約$380K)。現在の規模でのAuroraの運用費用は年間約$420Kです。年間の純削減額は約$1.16Mとなりました。移行プロジェクトの費用(GTEMASの支援、AWSの移行クレジット、社内の工数を含む)は約$680Kで、投資回収期間は約7か月です。
コスト面だけでなく、インフラの機動性が高まった効果も大きなものです。クライアントは、ハードウェア調達のリードタイムなしに、トラフィックの動きに応じてAuroraの読み取り容量を増減できます。2024年の繁忙期もAuroraで問題なく乗り切り、最も取引の多かった日には過去最高の215,000件の注文を処理しました。そのときのp99クエリレイテンシは、Oracle環境が平常時に出していた基準値より低い値でした。
この規模の移行を経験した人なら、教訓は想定できるものでしょう。それでも繰り返す価値があるのは、プロジェクトがこれらへの投資を相変わらず惜しむからです。シャドウ検証は省ける作業ではありません。変換のミスが本番インシデントになる前に見つける仕組みです。Oracleの手続き層は、SCTの見積もりが示した以上に、手作業での書き直しを必要としました。移行先プラットフォームでのパフォーマンスチューニングには、開発環境の推定値ではなく、本番規模の負荷テストデータが要ります。そして、ロールバック計画は文書化するだけでなく、テストしなければなりません。
御社が大規模なデータベース移行(特にOracleからPostgreSQLまたはAuroraへの移行)を検討中なら、計画、検証、チューニングの作業が成否を分けます。GTEMASは、最初から現実的に作業範囲を見積もるお手伝いができます。