

Tình huống minh họa: bài viết này là ví dụ tổng hợp, viết để cho thấy cách vận hành một dự án như vậy. Bài không mô tả một khách hàng cụ thể nào, và các con số chỉ mang tính minh họa.
Bối cảnh
Tháng 1/2024, chúng tôi bắt đầu trao đổi với một tập đoàn bán lẻ trong khu vực. Nền tảng thương mại điện tử của họ xử lý khoảng 40,000 đơn hàng mỗi ngày vào thời điểm bình thường và tăng lên hơn 200,000 đơn trong các đợt khuyến mãi lớn. Backend chạy trên Oracle Database 19c, đặt on-premise tại hai data center thuê chỗ (co-location). Cơ sở dữ liệu chứa khoảng 50TB dữ liệu giao dịch: đơn hàng, tồn kho, hồ sơ khách hàng, lịch sử fulfillment và bảy năm audit log mà quy định tuân thủ buộc họ phải lưu giữ.
Hệ thống hiện tại không hỏng. Vấn đề là nó đang dần không thể duy trì. Chi phí bản quyền Oracle đã tăng 34% trong ba năm qua, một phần do Oracle kiểm tra giấy phép gắt gao, một phần do lượng dữ liệu thực sự tăng. Chu kỳ nâng cấp phần cứng tại co-location đã quá hạn, và công ty không thể vừa chi vốn đầu tư để nâng cấp hạ tầng on-premise vừa đầu tư cho lộ trình phát triển sản phẩm. Chuyển lên cloud là quyết định chiến lược đúng.
Ràng buộc cứng khiến dự án thực sự khó: họ không thể chịu downtime trong mùa cao điểm, kéo dài từ tháng 9 đến tháng 1. Dự án bắt đầu vào tháng 2/2024 và yêu cầu bắt buộc là hoàn tất cutover production trước tháng 9 năm đó. Chúng tôi có khoảng bảy tháng để chuyển 50TB của một database production đang hoạt động, không có khung giờ bảo trì.
Vì sao chọn Aurora, và vì sao bài toán schema không đơn giản
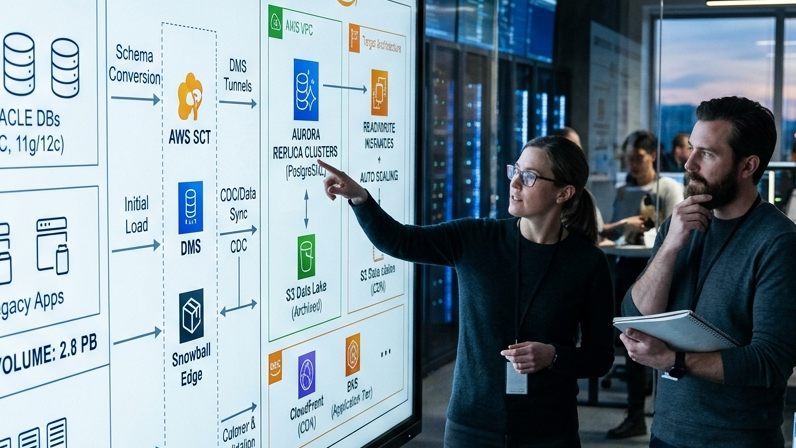
Nền tảng đích đã được chọn trước khi chúng tôi tham gia: CTO của khách hàng đã so sánh Aurora PostgreSQL với Aurora MySQL và RDS Oracle (giữ nguyên cú pháp Oracle) và chọn Aurora PostgreSQL vì chi phí, hiệu năng và khả năng bảo trì lâu dài. Chúng tôi đồng ý với kết luận này, nhưng hệ quả không nhỏ: chuyển từ Oracle sang PostgreSQL không phải là lift-and-shift. Đây là việc port database, phải xử lý cú pháp, kiểu dữ liệu và logic thủ tục riêng của Oracle vốn không chuyển thẳng sang được.
Database Oracle của khách hàng có 847 stored procedure, 130 trigger và 23 package. Đó là một khối logic nghiệp vụ lớn, tích lũy qua 11 năm phát triển. Giai đoạn đầu của dự án là rà soát toàn bộ lớp thủ tục này để tìm những cấu trúc riêng của Oracle cần viết lại. AWS Schema Conversion Tool (SCT) giúp chúng tôi đi trước một bước: công cụ tự động chuyển đổi khoảng 60% stored procedure mà không cần can thiệp thủ công. 40% còn lại phải viết lại thủ công ở nhiều mức độ khác nhau, từ chỉnh cú pháp nhỏ đến cấu trúc lại hoàn toàn logic ở những chỗ mô hình thực thi của Oracle và PostgreSQL khác nhau về bản chất.
Những vướng mắc chuyển đổi thường gặp nhất gồm: hàm DECODE của Oracle (thay bằng biểu thức CASE), sequence của Oracle so với sequence của PostgreSQL (cú pháp khác, ngữ nghĩa tương thích), hành vi tự động chuyển đổi TO_DATE của Oracle (PostgreSQL chặt chẽ hơn với chuỗi định dạng ngày), và một số stored procedure dùng cú pháp truy vấn phân cấp CONNECT BY của Oracle (thay bằng recursive CTE của PostgreSQL). Chúng tôi dùng Orafce, một extension của PostgreSQL cài sẵn các hàm tương thích Oracle, để thu hẹp phần phải viết lại. Orafce không xóa hết công việc, nhưng giảm đáng kể ở các mẫu phổ biến.
Chiến lược chuyển đổi: dual-write và shadow read
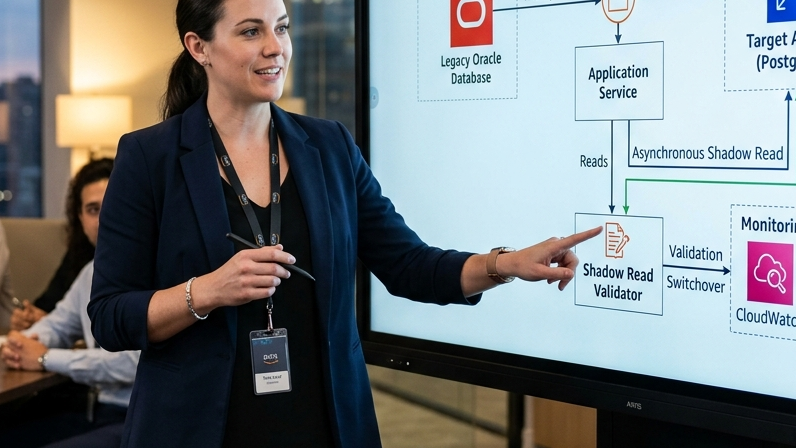
Chuyển một database 50TB mà không có khung giờ bảo trì đòi hỏi một chiến lược giữ hai database nhất quán với nhau trong khi lưu lượng vẫn đổ vào hệ thống nguồn. Chúng tôi dùng dual-write kết hợp shadow read để kiểm chứng, với AWS Database Migration Service (DMS) làm lớp nhân bản liên tục bên dưới.
Kiến trúc hoạt động như sau. DMS được cấu hình ở chế độ nhân bản liên tục, sao chép thay đổi từ Oracle sang Aurora PostgreSQL gần như theo thời gian thực. Độ trễ thường là 2-5 giây khi tải bình thường và tăng lên 15-20 giây vào giờ cao điểm. Trong suốt thời gian chuyển đổi, ứng dụng chỉ ghi vào Oracle và chỉ đọc từ Oracle. Song song đó, một shadow service nhận bản sao của mọi thao tác ghi và phát lại trên Aurora PostgreSQL, để chúng tôi kiểm chứng hai database hội tụ về cùng một trạng thái.
Phần shadow read là phần thú vị hơn về mặt kỹ thuật. Chúng tôi xây một dịch vụ kiểm chứng định kỳ lấy mẫu bản ghi từ cả hai database (50,000 bản ghi mỗi giờ, chọn theo hash để phân bổ đều trên toàn bộ tập dữ liệu) rồi so sánh từng trường. Mỗi điểm lệch được ghi log đầy đủ ngữ cảnh: mã định danh bản ghi, tên trường, giá trị ở Oracle, giá trị ở Aurora và thời điểm sửa đổi gần nhất ở mỗi hệ thống. Nhờ vậy, chúng tôi nắm được liên tục mức độ toàn vẹn dữ liệu trong suốt thời gian chuyển đổi và bắt được những lỗi chuyển đổi schema mà môi trường phát triển không bộc lộ.
Trong giai đoạn shadow read, chúng tôi tìm thấy mười một nhóm điểm lệch. Phần lớn là lỗi nhỏ: khác biệt về độ chính xác số (kiểu số mặc định của Oracle xử lý độ chính xác khác PostgreSQL), khác biệt trong xử lý múi giờ của timestamp, và cách xử lý NULL so với chuỗi rỗng trong dữ liệu cũ. Hai lỗi nghiêm trọng hơn: một stored procedure tính toán ngày tháng cho kết quả khác nhau giữa hai hệ thống trong các trường hợp biên liên quan đến mốc chuyển giờ mùa hè, và một trigger có hành vi riêng của Oracle khi xử lý vi phạm khóa trùng mà chúng tôi chưa tái tạo đầy đủ trên phiên bản PostgreSQL. Cả hai đều được phát hiện và sửa trong giai đoạn chạy song song, trước khi có bất kỳ nguy cơ làm hỏng dữ liệu trên production.
Cách tiến hành theo giai đoạn: bốn bước đến cutover
Thay vì coi đây là một sự kiện duy nhất, chúng tôi chia việc chuyển đổi thành bốn giai đoạn, mỗi giai đoạn có tiêu chí go/no-go riêng.
Giai đoạn 1 – Schema và dữ liệu tĩnh (tuần 1-4): Chuyển schema, các bảng dữ liệu tham chiếu và dữ liệu lưu trữ lịch sử không còn được sửa đổi. Bước này dựng môi trường Aurora và cho phép kiểm chứng việc chuyển đổi schema trên khối lượng dữ liệu thật mà không ảnh hưởng production. Chúng tôi dùng đợt full load đầu tiên của DMS cho giai đoạn này, mất 11 ngày với tập dữ liệu 50TB. DMS xử lý khối lượng này không gặp khó khăn gì, nhưng chúng tôi vướng lỗi quyền IAM và cấu hình định tuyến VPC, mất khoảng hai ngày để gỡ lỗi. Ai từng làm việc với DMS đều đoán trước được chuyện này, nhưng vẫn nên đưa vào kế hoạch.
Giai đoạn 2 – Nhân bản liên tục và kiểm chứng shadow (tuần 5-14): Bật nhân bản liên tục của DMS và dịch vụ kiểm chứng shadow read. Giai đoạn này chạy mười tuần, lâu hơn kế hoạch ban đầu, vì chúng tôi dùng dữ liệu điểm lệch để cải tiến dần việc chuyển đổi schema. Tiêu chí go/no-go để sang Giai đoạn 3 là không có điểm lệch nào trong cửa sổ giám sát liên tục 72 giờ. Chúng tôi đạt tiêu chí này vào tuần 14.
Giai đoạn 3 – Chuẩn bị lớp ứng dụng (tuần 15-22): Chuyển lớp kết nối của ứng dụng để hỗ trợ kết nối đồng thời tới hai database, thêm feature flag cho phép chuyển lưu lượng đọc sang Aurora trước lưu lượng ghi, và hoàn tất load testing môi trường Aurora trong điều kiện mô phỏng lưu lượng cao điểm. Về hiệu năng, Aurora không phải là bản thay thế Oracle cắm vào chạy được ngay: đường tối ưu truy vấn khác nhau, và một số truy vấn chạy tốt trên Oracle phải thêm index hoặc cấu trúc lại truy vấn mới chạy tốt trên Aurora. Phần việc này được làm trong Giai đoạn 3, trước khi có lưu lượng production nào chạm vào Aurora, dùng bản sao dữ liệu production để load testing.
Giai đoạn 4 – Cutover (tuần 24, thực hiện trong một cuối tuần): Cutover được thực hiện theo từng bước. Trước tiên, toàn bộ lưu lượng đọc được chuyển sang Aurora (bằng các feature flag dựng ở Giai đoạn 3) trong khi việc ghi vẫn đi vào Oracle. Chúng tôi theo dõi 4 giờ dưới lưu lượng đọc thật rồi mới tiếp tục. Sau đó, lúc 2 giờ sáng Chủ nhật, khi lượng đơn hàng thấp nhất trong ngày, chúng tôi dừng ứng dụng, để DMS xử lý hết độ trễ nhân bản còn lại về 0, nâng Aurora lên làm primary, cập nhật cấu hình ứng dụng để ghi vào Aurora rồi khởi động lại ứng dụng. Tổng thời gian downtime: 8 phút. Oracle vẫn được giữ trong 14 ngày sau cutover làm phương án rollback, với nhân bản một chiều từ Aurora về Oracle để giữ dữ liệu cập nhật trong thời gian này.
Tinh chỉnh hiệu năng trên Aurora
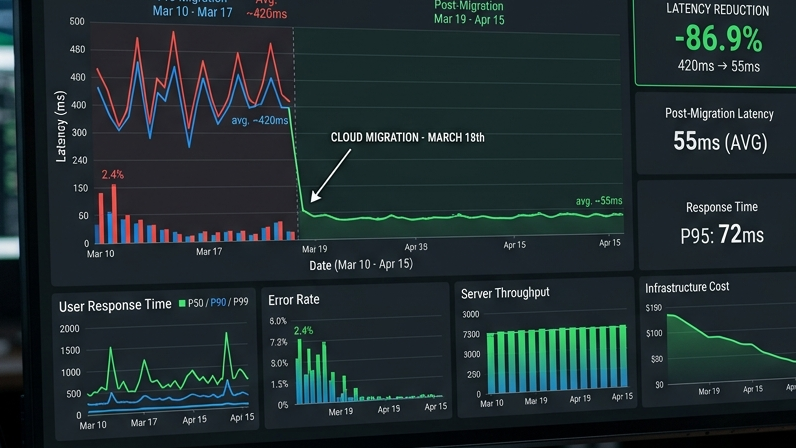
Câu chuyện hiệu năng có hai chặng. Chặng đầu, ngay sau cutover, đáng lo: một số truy vấn có lưu lượng cao chạy chậm hơn 40-60% trên Aurora so với trên Oracle. Chặng sau, sau hai tuần tinh chỉnh, kết quả tốt hơn dự kiến ban đầu của chúng tôi.
Truy vấn chậm nhất là truy vấn tìm kiếm đơn hàng, được ứng dụng chạy thường xuyên với tổ hợp tham số lọc khiến trình tối ưu truy vấn của Aurora lập ra execution plan kém. Execution plan trên Oracle dùng một tổ hợp index mà planner của Aurora không chọn. Thêm một composite index và viết lại truy vấn bằng CTE thay cho subquery lồng nhau đã đưa thời gian thực thi trên Aurora xuống thấp hơn mức nền của Oracle 12%. Mẫu tương tự xuất hiện ở 8 truy vấn khác, mỗi truy vấn đều phải phân tích execution plan, thêm index hoặc viết lại truy vấn, rồi kiểm chứng dưới tải.
Cách Aurora quản lý connection pooling cũng cần điều chỉnh. Môi trường Oracle dùng connection pooling với các kết nối sống rất lâu. Aurora chạy trên PostgreSQL nhạy hơn với số lượng kết nối và hoạt động tốt hơn khi kết nối sống ngắn hơn và pool được tái chế mạnh. Sau khi tinh chỉnh cài đặt RDS Proxy và điều chỉnh cấu hình connection pool của ứng dụng, các vấn đề hiệu năng liên quan đến kết nối đã hết.
Chỉ số hiệu năng ở trạng thái cuối, đo 60 ngày sau cutover: thời gian phản hồi truy vấn trung bình cải thiện 18% so với mức nền của Oracle. Thời gian phản hồi truy vấn p99 (1% truy vấn chậm nhất) cải thiện 31%, chủ yếu vì kiến trúc I/O của Aurora xử lý các workload có độ biến thiên cao ổn định hơn ổ đĩa quay mà môi trường Oracle đang dùng. Các read replica ở hai availability zone bổ sung thêm khả năng dự phòng mà hệ thống Oracle trước đó không có.
Kế hoạch rollback đã không cần dùng đến (nhưng may là có sẵn)
Bất kỳ đợt chuyển đổi nào ở quy mô này mà không có kế hoạch rollback đáng tin thì chưa sẵn sàng cho production. Quyết định cho phép cutover ở Giai đoạn 4 phụ thuộc vào việc kế hoạch rollback đã được kiểm thử, chứ không chỉ được viết thành tài liệu.
Kế hoạch rollback có ba phần. Thứ nhất, Oracle vẫn sẵn sàng và được cập nhật trong 14 ngày sau cutover, nhờ nhân bản một chiều từ Aurora. Nếu cần rollback, quy trình là: dừng việc ghi của ứng dụng vào Aurora, để nhân bản một chiều bắt kịp, chuyển cấu hình kết nối của ứng dụng về Oracle rồi khởi động lại. Thời gian rollback ước tính: 15 phút cộng thêm thời gian xử lý hết độ trễ nhân bản. Chúng tôi đã thử quy trình này hai lần trên môi trường staging trước khi cutover production.
Thứ hai, chúng tôi giữ một snapshot database chụp ngay trước cutover Giai đoạn 4. Đây là phương án "cuối cùng" nếu rollback dựa trên nhân bản thất bại vì bất kỳ lý do gì. Khôi phục 50TB từ snapshot mất nhiều thời gian hơn đáng kể (chúng tôi ước tính 4-6 giờ), nhưng phương án này luôn có sẵn.
Thứ ba, các feature flag của ứng dụng dựng ở Giai đoạn 3 vẫn được giữ nguyên sau cutover. Nếu một số chức năng gặp sự cố trên production và sự cố chỉ nằm ở một vài đường truy vấn, chúng tôi có thể chuyển riêng những đường đó về đọc từ Oracle mà không cần rollback toàn bộ. Đây là phương án chính xác nhất, được thiết kế cho trường hợp "thành công một phần", khi phần lớn cutover chạy tốt nhưng một mảng cần thêm thời gian.
Kế hoạch rollback chưa bao giờ phải dùng. Điều này không nói lên chất lượng của kế hoạch rollback, mà nói lên những gì giai đoạn kiểm chứng shadow 14 tuần đã làm được. Đến lúc cutover, chúng tôi rất tin vào tính nhất quán của dữ liệu vì đã đo nó liên tục.
Kết quả và bài học rút ra
Sáu tháng sau cutover, các con số như sau: chi phí bản quyền Oracle được loại bỏ (khoảng $1.2M mỗi năm), chi phí phần cứng co-location được loại bỏ (khoảng $380K mỗi năm), chi phí vận hành Aurora ở quy mô hiện tại khoảng $420K mỗi năm. Tiết kiệm ròng hằng năm: khoảng $1.16M. Chi phí dự án chuyển đổi (gồm chi phí làm việc với GTEMAS, tín dụng migration của AWS và thời gian của đội nội bộ) khoảng $680K. Thời gian hoàn vốn: khoảng 7 tháng.
Ngoài chuyện chi phí, hạ tầng linh hoạt hơn rõ rệt. Khách hàng giờ có thể tăng giảm năng lực đọc của Aurora theo lưu lượng mà không phải chờ mua sắm phần cứng. Họ đã chạy mùa cao điểm 2024 trên Aurora mà không có sự cố, xử lý 215,000 đơn vào ngày đông nhất (một kỷ lục mới), với độ trễ truy vấn p99 thấp hơn mức mà môi trường Oracle đạt được trong những thời kỳ vận hành bình thường.
Những bài học này ai từng làm chuyển đổi cỡ này cũng đoán được, nhưng vẫn đáng nhắc lại vì các dự án vẫn thường đầu tư thiếu vào chúng. Kiểm chứng shadow không phải chi phí phụ có thể bỏ: đây là cơ chế phát hiện lỗi chuyển đổi trước khi chúng thành sự cố production. Lớp thủ tục của Oracle cần viết lại thủ công nhiều hơn đáng kể so với ước tính của SCT. Tinh chỉnh hiệu năng trên nền tảng đích cần dữ liệu load testing ở quy mô production, không phải con số ước tính từ môi trường phát triển. Và kế hoạch rollback cần được kiểm thử, chứ không chỉ được viết thành tài liệu.
Nếu tổ chức của bạn đang cân nhắc chuyển một database quy mô lớn, nhất là từ Oracle sang PostgreSQL hoặc Aurora, thì việc lập kế hoạch, kiểm chứng và tinh chỉnh là nơi dự án thành hay bại. GTEMAS có thể giúp bạn xác định phạm vi công việc sát thực tế ngay từ đầu.