

Scénario illustratif : cet article est un exemple composite, écrit pour montrer comment se conduit un projet de ce type. Il ne décrit pas un client nommé, et les chiffres sont illustratifs.
La situation
En janvier 2024, nous avons engagé la discussion avec un groupe de distribution régional dont la plateforme e-commerce traitait environ 40 000 commandes par jour en période normale, et plus de 200 000 lors des grandes opérations promotionnelles. Son backend tournait sur Oracle Database 19c, hébergé sur site dans deux datacenters en colocation. La base contenait environ 50 To de données transactionnelles : commandes, stocks, fiches clients, historique de préparation et sept ans de journaux d’audit que la conformité l’obligeait à conserver.
Le problème n’était pas que l’infrastructure en place défaillait. Elle devenait intenable. Les coûts de licences Oracle avaient augmenté de 34 % en trois ans, en partie à cause des pratiques d’audit agressives d’Oracle, en partie à cause d’une réelle croissance des volumes de données. Le renouvellement du matériel des serveurs en colocation était en retard, et l’investissement nécessaire pour renouveler l’infrastructure sur site tout en finançant la feuille de route produit n’était pas envisageable. La migration vers le cloud était la bonne décision stratégique.
La contrainte qui rendait ce projet réellement difficile : aucune interruption de service n’était acceptable pendant la haute saison, de septembre à janvier. Le projet démarrait en février 2024 et la bascule en production devait être terminée avant le mois de septembre suivant. Nous disposions donc d’environ sept mois pour migrer 50 To d’une base de production active, sans fenêtre de maintenance.
Pourquoi Aurora, et pourquoi la question du schéma n’avait rien de simple
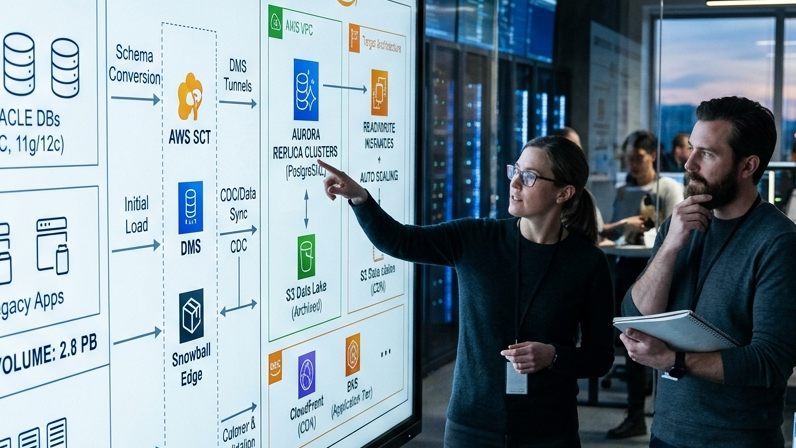
La plateforme cible avait été choisie avant notre arrivée : le CTO du client avait comparé Aurora PostgreSQL, Aurora MySQL et RDS Oracle (qui aurait conservé le dialecte Oracle) et retenu Aurora PostgreSQL pour des raisons de coût, de performance et de maintenabilité à long terme. Nous avons approuvé cette conclusion, mais ses conséquences étaient importantes : passer d’Oracle à PostgreSQL n’est pas un lift-and-shift. C’est un portage de base de données, qui demande de traiter la syntaxe, les types de données et la logique procédurale propres à Oracle, lesquels ne se traduisent pas directement.
La base Oracle du client contenait 847 procédures stockées, 130 déclencheurs et 23 packages : une masse considérable de logique métier accumulée en 11 ans de développement. La première phase du projet a consisté à auditer entièrement cette couche procédurale pour repérer les constructions spécifiques à Oracle à réécrire. AWS Schema Conversion Tool (SCT) nous a donné de l’avance : il a converti automatiquement environ 60 % des procédures stockées, sans intervention manuelle. Les 40 % restants ont demandé une réécriture manuelle plus ou moins lourde, d’un simple ajustement de syntaxe à la refonte complète de la logique lorsque les modèles d’exécution d’Oracle et de PostgreSQL diffèrent sur le fond.
Les difficultés de conversion les plus fréquentes étaient les suivantes : la fonction DECODE d’Oracle (remplacée par des expressions CASE), les séquences Oracle face aux séquences PostgreSQL (syntaxe différente, sémantique compatible), la conversion implicite TO_DATE d’Oracle (PostgreSQL est plus strict sur les formats de date) et plusieurs procédures stockées qui utilisaient la syntaxe de requête hiérarchique CONNECT BY d’Oracle (remplacée par les CTE récursives de PostgreSQL). Nous avons utilisé Orafce, une extension PostgreSQL qui implémente des fonctions de compatibilité Oracle, pour réduire la surface à réécrire : elle ne supprime pas le travail, mais l’allège sensiblement pour les motifs courants.
La stratégie de migration : double écriture et lectures fantômes
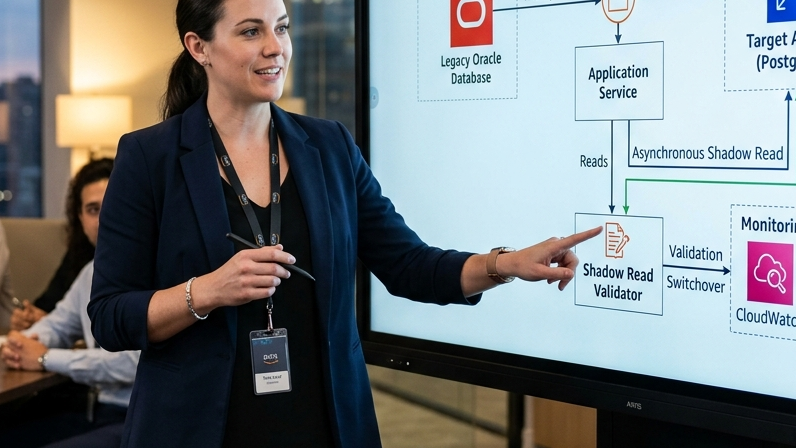
Migrer une base de 50 To sans fenêtre de maintenance exige de maintenir deux bases cohérentes en même temps, pendant que le trafic continue d’arriver sur le système source. Nous avons adopté une double écriture, avec des lectures fantômes (shadow reads) pour la validation, sur une couche de réplication continue reposant sur AWS Database Migration Service (DMS).
L’architecture fonctionnait ainsi. DMS était configuré en mode de réplication continue pour répliquer les modifications d’Oracle vers Aurora PostgreSQL quasiment en temps réel, avec en général 2–5 secondes de décalage en charge normale, qui montaient à 15–20 secondes lors des pics de trafic. Pendant la période de migration, l’application écrivait exclusivement dans Oracle et lisait exclusivement dans Oracle. En parallèle, un service fantôme consommait une copie de toutes les opérations d’écriture et les rejouait sur Aurora PostgreSQL, ce qui nous permettait de vérifier que les deux bases convergeaient vers le même état.
Le volet des lectures fantômes était le plus intéressant sur le plan technique. Nous avons construit un service de validation qui prélevait périodiquement des enregistrements dans les deux bases (50 000 par heure, sélectionnés par hachage pour répartir l’échantillon uniformément sur le jeu de données) et les comparait champ par champ. Chaque écart était journalisé avec tout son contexte : l’identifiant de l’enregistrement, le nom du champ, la valeur Oracle, la valeur Aurora et l’horodatage de la dernière modification dans chaque système. Nous avions ainsi une vision continue de l’intégrité des données pendant la migration, et nous avons pu détecter des problèmes de conversion du schéma qui n’étaient pas apparus en environnement de développement.
Nous avons relevé onze catégories d’écarts pendant la période de lectures fantômes. La plupart étaient mineures : différences de précision numérique, car le type numérique par défaut d’Oracle n’a pas le même comportement que celui de PostgreSQL ; différences de gestion des fuseaux horaires dans les horodatages ; traitement de NULL et de la chaîne vide dans les données héritées. Deux étaient plus sérieuses : une procédure stockée de calcul de dates qui se comportait différemment d’un système à l’autre dans des cas limites autour des changements d’heure, et un déclencheur dont le traitement des violations de clé en double, propre à Oracle, n’était pas entièrement reproduit dans la version PostgreSQL. Les deux ont été détectés et corrigés pendant la période de fonctionnement en parallèle, avant tout risque de corruption de données en production.
L’approche par phases : quatre étapes jusqu’à la bascule
Plutôt que d’en faire un événement unique, nous avons structuré la migration en quatre phases distinctes, avec des critères go/no-go définis à chaque étape.
Phase 1 – Schéma et données statiques (semaines 1–4) : migration du schéma, des tables de données de référence et des archives historiques qui ne sont pas modifiées activement. Cette phase a mis en place l’environnement Aurora et permis de valider la conversion du schéma sur des volumes de données réels, sans aucun risque pour la production. Nous avons utilisé pour cela le chargement complet initial de DMS, qui a pris 11 jours pour les 50 To. DMS n’a eu aucune difficulté avec le volume, mais nous avons rencontré des problèmes de permissions IAM et de routage VPC qui ont coûté environ deux jours de débogage : prévisible pour quiconque a déjà travaillé avec DMS, mais à prévoir dans le planning.
Phase 2 – Réplication continue et validation par lectures fantômes (semaines 5–14) : activation de la réplication continue de DMS et du service de validation par lectures fantômes. Cette phase a duré dix semaines, plus que prévu à l’origine, parce que nous avons exploité les données d’écarts pour améliorer le schéma converti par itérations. Le critère go/no-go de la phase 3 était zéro écart sur une fenêtre de surveillance continue de 72 heures. Nous l’avons atteint à la semaine 14.
Phase 3 – Préparation de la couche applicative (semaines 15–22) : adaptation de la couche de connexion de l’application pour gérer deux connexions de base de données, mise en place de feature flags permettant de basculer le trafic de lecture vers Aurora avant le trafic d’écriture, et tests de charge complets de l’environnement Aurora sous un trafic de pointe simulé. Côté performances, Aurora n’est pas un remplaçant direct d’Oracle : les chemins d’optimisation des requêtes diffèrent, et plusieurs requêtes performantes sur Oracle ont exigé des index supplémentaires ou une restructuration pour Aurora. Ce travail a été réalisé pendant la phase 3, avant que le moindre trafic de production ne touche Aurora, avec des clones des données de production pour les tests de charge.
Phase 4 – Bascule (semaine 24, exécutée sur un seul week-end) : la bascule proprement dite s’est faite par étapes. D’abord, tout le trafic de lecture a été déplacé vers Aurora (grâce aux feature flags de la phase 3) pendant que les écritures continuaient vers Oracle. Nous avons surveillé pendant 4 heures sous trafic de lecture réel avant de poursuivre. Ensuite, le dimanche à 2 h du matin, lorsque le volume de commandes était à son minimum quotidien, nous avons arrêté l’application, laissé DMS résorber le dernier décalage de réplication jusqu’à zéro, promu Aurora en base principale, modifié la configuration de l’application pour écrire dans Aurora et redémarré l’application. Durée totale d’interruption : 8 minutes. Oracle est resté disponible pendant 14 jours après la bascule comme option de retour arrière, avec une réplication à sens unique d’Aurora vers Oracle pour le maintenir à jour pendant cette fenêtre.
Réglage des performances sur Aurora
L’histoire des performances s’est déroulée en deux temps. Le premier, juste après la bascule, était préoccupant : plusieurs requêtes à fort trafic s’exécutaient 40–60 % plus lentement sur Aurora que sur Oracle. Le second, après deux semaines de réglages, a dépassé nos projections initiales.
La requête la plus lente était une recherche de commandes, exécutée souvent par l’application avec une combinaison de filtres qui produisait un mauvais plan d’exécution dans l’optimiseur d’Aurora. Le plan Oracle de cette requête s’appuyait sur une combinaison d’index que le planificateur d’Aurora ne choisissait pas. L’ajout d’un index composite et la réécriture de la requête avec des CTE plutôt que des sous-requêtes imbriquées ont ramené le temps d’exécution sur Aurora 12 % sous la référence Oracle. Le même schéma est apparu dans 8 autres requêtes : chacune a demandé d’analyser le plan d’exécution, d’ajouter un index ou de réécrire la requête, puis de valider sous charge.
Le comportement du pool de connexions d’Aurora a lui aussi nécessité des ajustements. L’environnement Oracle utilisait un pool de connexions à très longue durée de vie. Aurora, qui repose sur PostgreSQL, est plus sensible au nombre de connexions et gagne à avoir des connexions plus courtes et un recyclage agressif du pool. Après réglage de RDS Proxy et de la configuration du pool de connexions de l’application, les problèmes de performance liés aux connexions ont disparu.
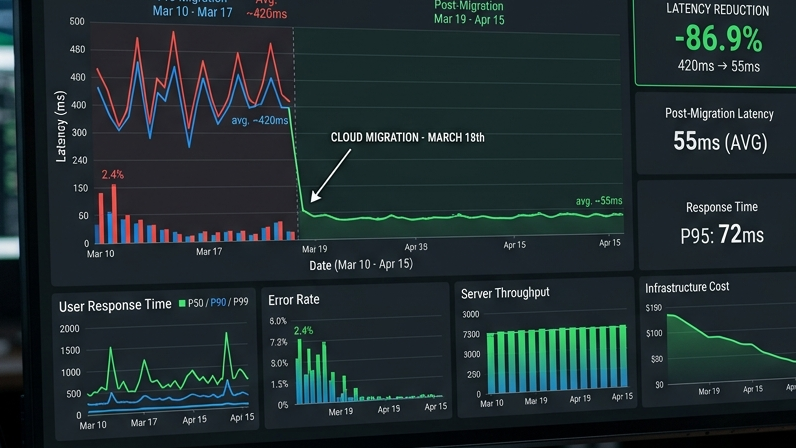
Les métriques de performance finales, mesurées 60 jours après la bascule : le temps de réponse moyen des requêtes s’est amélioré de 18 % par rapport à la référence Oracle. Le temps de réponse p99 (celui du 1 % de requêtes les plus lentes) s’est amélioré de 31 %, principalement parce que l’architecture d’E/S d’Aurora gère plus régulièrement les charges très variables que le stockage sur disques rotatifs de l’environnement Oracle. Des réplicas en lecture dans deux zones de disponibilité supplémentaires ont ajouté une redondance que l’installation Oracle n’avait pas.
Le plan de retour arrière dont nous n’avons pas eu besoin (mais heureusement prévu)
Une migration de cette ampleur sans plan de retour arrière crédible n’est pas prête pour la production. Le feu vert pour la bascule de la phase 4 était conditionné à un plan de retour arrière testé, et non simplement documenté.
Le plan de retour arrière comportait trois volets. Premièrement, Oracle est resté disponible et à jour pendant 14 jours après la bascule, grâce à une réplication à sens unique depuis Aurora. S’il avait fallu revenir en arrière, la procédure était la suivante : arrêter les écritures de l’application vers Aurora, laisser la réplication à sens unique se synchroniser, remettre la configuration de connexion de l’application sur Oracle et redémarrer. Durée de retour arrière estimée : 15 minutes, plus le temps de résorption du décalage de réplication. Nous l’avons testée deux fois en environnement de préproduction avant la bascule en production.
Deuxièmement, nous avons conservé un snapshot de la base pris juste avant la bascule de la phase 4. C’était l’option de dernier recours si le retour arrière par réplication échouait pour une raison quelconque. Restaurer 50 To depuis un snapshot prend beaucoup plus de temps (nous l’estimions à 4–6 heures), mais l’option existait.
Troisièmement, les feature flags de la phase 3 sont restés en place après la bascule. Si certaines fonctions de l’application avaient présenté des problèmes en production, isolés à certains chemins de requêtes, nous pouvions redéplacer ces seuls chemins vers des lectures Oracle sans retour arrière complet. C’était l’option la plus chirurgicale, conçue pour les scénarios de « succès partiel », où l’essentiel de la bascule fonctionne mais où un domaine a besoin de plus de temps.
Le plan de retour arrière n’a jamais été déclenché. Cela ne dit rien de la qualité de ce plan : cela dit ce qu’a permis la période de validation par lectures fantômes de 14 semaines. Au moment de la bascule, nous avions une grande confiance dans la cohérence des données, car nous la mesurions en continu.
Résultats et enseignements
Six mois après la bascule, les chiffres sont les suivants : coûts de licences Oracle supprimés (environ 1,2 M$ par an), coûts de matériel en colocation supprimés (environ 380 k$ par an), coûts d’exploitation d’Aurora à l’échelle actuelle d’environ 420 k$ par an. Économies annuelles nettes : environ 1,16 M$. Le coût du projet de migration (engagement de GTEMAS, crédits de migration AWS et temps interne compris) était d’environ 680 k$. Délai de retour sur investissement : environ 7 mois.
Au-delà des coûts, le gain d’agilité de l’infrastructure est notable. Le client peut désormais augmenter ou réduire la capacité de lecture d’Aurora selon le trafic, sans délai d’approvisionnement de matériel. Il a traversé sa haute saison 2024 sur Aurora sans incident, avec 215 000 commandes traitées lors de sa journée la plus chargée (un nouveau record) et une latence p99 des requêtes inférieure à celle que son environnement Oracle offrait en période normale.
Ces enseignements n’étonneront personne ayant mené des migrations de cette taille, mais ils méritent d’être répétés, car les projets continuent de sous-investir sur ces points. La validation par lectures fantômes n’est pas une charge facultative : c’est le mécanisme qui repère les erreurs de conversion avant qu’elles ne deviennent des incidents de production. La couche procédurale Oracle a demandé nettement plus de réécriture manuelle que ne l’estimait SCT. Le réglage des performances sur la plateforme cible exige des données de test de charge à l’échelle de la production, pas des estimations tirées d’environnements de développement. Et le plan de retour arrière doit être testé, pas seulement documenté.
Si votre organisation évalue une migration de base de données de grande ampleur, en particulier d’Oracle vers PostgreSQL ou Aurora, le projet se gagne ou se perd dans la planification, la validation et le réglage. GTEMAS peut vous aider à cadrer le travail de façon réaliste dès le départ.