

Illustratives Szenario: Dieser Artikel ist ein zusammengesetztes Beispiel, das zeigen soll, wie ein Projekt dieser Art abläuft. Er beschreibt keinen benannten Kunden, und die Zahlen sind illustrativ.
Die Ausgangslage
Im Januar 2024 begannen wir Gespräche mit einer regionalen Handelsgruppe. Ihre E-Commerce-Plattform verarbeitete in normalen Zeiten rund 40.000 Bestellungen pro Tag, bei großen Rabattaktionen stieg die Zahl auf mehr als 200.000. Das Backend lief auf Oracle Database 19c, betrieben On-Premise in zwei Co-Location-Rechenzentren. Die Datenbank enthielt etwa 50 TB an Transaktionsdaten: Bestellungen, Lagerbestände, Kundendatensätze, Fulfillment-Historie und sieben Jahre Audit-Logs, die aus Compliance-Gründen aufbewahrt werden mussten.
Das Problem war nicht, dass die bestehende Lösung versagte. Sie wurde untragbar. Die Oracle-Lizenzkosten waren in den vorangegangenen drei Jahren um 34 % gestiegen, zum Teil wegen der aggressiven Audit-Praxis von Oracle, zum Teil wegen des tatsächlichen Wachstums der Datenmengen. Der Austausch der Hardware in den Co-Location-Servern war überfällig. Die dafür nötigen Investitionen waren neben der Weiterentwicklung der eigenen Produkte nicht zu stemmen. Die Migration in die Cloud war die richtige strategische Entscheidung.
Was das Projekt wirklich schwierig machte: Während der Hochsaison, die von September bis Januar läuft, durfte es keine Ausfallzeit geben. Der Projektstart war im Februar 2024, der produktive Cutover musste zwingend vor dem folgenden September abgeschlossen sein. Uns blieben also etwa sieben Monate, um 50 TB einer aktiven Produktionsdatenbank ohne Wartungsfenster zu migrieren.
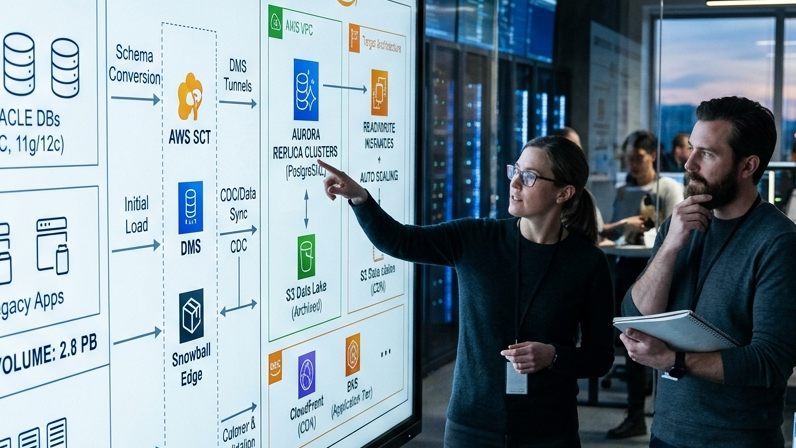
Warum Aurora und warum die Schemafrage nicht einfach war
Die Entscheidung für die Zielplattform war gefallen, bevor wir hinzugezogen wurden: Der CTO des Kunden hatte Aurora PostgreSQL gegen Aurora MySQL und RDS Oracle (das den Oracle-Dialekt erhalten hätte) abgewogen und sich aus Gründen der Kosten, der Performance und der langfristigen Wartbarkeit für Aurora PostgreSQL entschieden. Wir teilten diese Einschätzung, doch die Folgen waren erheblich: Der Wechsel von Oracle zu PostgreSQL ist kein Lift-and-Shift, sondern eine Portierung der Datenbank. Oracle-spezifische Syntax, Datentypen und prozedurale Logik lassen sich nicht direkt übertragen und müssen einzeln geprüft werden.
Die Oracle-Datenbank des Kunden enthielt 847 Stored Procedures, 130 Datenbank-Trigger und 23 Packages – eine beträchtliche Menge an Geschäftslogik, die sich über 11 Jahre Entwicklung angesammelt hatte. Die erste Projektphase war ein vollständiges Audit dieser prozeduralen Schicht, um die Oracle-spezifischen Konstrukte zu finden, die neu geschrieben werden mussten. Das AWS Schema Conversion Tool (SCT) verschaffte uns einen Vorsprung: Es konvertierte etwa 60 % der Stored Procedures automatisch, ohne manuelles Eingreifen. Die übrigen 40 % erforderten unterschiedlich viel Handarbeit, von kleinen Syntaxanpassungen bis zur vollständigen Neustrukturierung der Logik dort, wo sich die Ausführungsmodelle von Oracle und PostgreSQL grundlegend unterscheiden.
Die häufigsten Probleme bei der Konvertierung waren: die Oracle-Funktion DECODE (ersetzt durch CASE-Ausdrücke), Oracle-Sequenzen im Vergleich zu PostgreSQL-Sequenzen (andere Syntax, kompatible Semantik), das implizite TO_DATE-Verhalten von Oracle (PostgreSQL ist bei Datumsformat-Strings strenger) und mehrere Stored Procedures mit der hierarchischen Abfragesyntax CONNECT BY von Oracle (ersetzt durch rekursive CTEs in PostgreSQL). Mit Orafce, einer PostgreSQL-Erweiterung, die Oracle-Kompatibilitätsfunktionen bereitstellt, verkleinerten wir den Umfang der Neuschreibungen. Die Arbeit entfällt dadurch nicht, bei gängigen Mustern wird sie aber spürbar geringer.
Die Migrationsstrategie: Dual-Write und Shadow Reads
Eine Migration von 50 TB ohne Wartungsfenster verlangt eine Strategie, die zwei konsistente Datenbanken gleichzeitig vorhält, während der Datenverkehr weiter auf das Quellsystem läuft. Wir setzten auf einen Dual-Write-Ansatz mit Shadow Reads zur Validierung, aufgebaut auf dem AWS Database Migration Service (DMS) für die laufende Replikation.
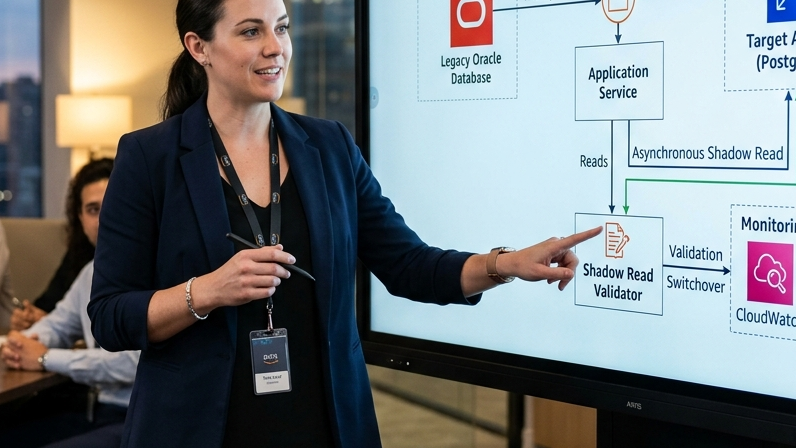
Die Architektur funktionierte so: DMS war im Modus der laufenden Replikation konfiguriert und übertrug Änderungen in nahezu Echtzeit von Oracle nach Aurora PostgreSQL – unter normaler Last typischerweise mit 2–5 Sekunden Verzögerung, in Spitzenzeiten mit 15–20 Sekunden. Während der Migration schrieb die Anwendung ausschließlich nach Oracle und las ausschließlich aus Oracle. Parallel dazu verarbeitete ein Shadow-Service eine Kopie aller Schreibvorgänge und spielte sie gegen Aurora PostgreSQL ein. So konnten wir prüfen, ob beide Datenbanken denselben Zustand erreichten.
Die Shadow-Read-Komponente war der technisch interessantere Teil. Wir bauten einen Validierungsservice, der regelmäßig Datensätze aus beiden Datenbanken stichprobenartig abfragte – 50.000 Datensätze pro Stunde, per Hash ausgewählt, damit sie gleichmäßig über den Datenbestand verteilt waren – und Feld für Feld verglich. Abweichungen wurden mit vollem Kontext protokolliert: Datensatz-ID, Feldname, Oracle-Wert, Aurora-Wert und der Zeitstempel der letzten Änderung in jedem System. So hatten wir während der gesamten Migration ein laufendes Bild der Datenintegrität und konnten Konvertierungsfehler im Schema finden, die in der Entwicklungsumgebung nicht aufgetreten waren.
In der Shadow-Read-Phase fanden wir elf Kategorien von Abweichungen. Die meisten waren geringfügig: Unterschiede in der numerischen Genauigkeit, weil der Standard-Zahlentyp von Oracle sich in der Präzision anders verhält als der von PostgreSQL, Unterschiede im Umgang mit Zeitzonen bei Zeitstempeln sowie NULL gegenüber leerem String in Altdaten. Zwei Fälle waren gewichtiger: eine Stored Procedure für Datumsarithmetik, die sich in Randfällen an den Grenzen der Sommerzeitumstellung in den beiden Systemen unterschiedlich verhielt, und ein Trigger mit Oracle-spezifischem Verhalten bei Verletzungen von Schlüsseleindeutigkeit, das wir in der PostgreSQL-Version nicht vollständig nachgebildet hatten. Beides wurde im Parallelbetrieb entdeckt und korrigiert, bevor in der Produktion ein Risiko für die Datenintegrität entstand.
Das phasenweise Vorgehen: Vier Stufen bis zum Cutover
Wir behandelten die Migration nicht als einzelnes Ereignis, sondern gliederten sie in vier getrennte Phasen mit jeweils festgelegten Go/No-go-Kriterien.
Phase 1 – Schema und statische Daten (Wochen 1–4): Migriert wurden das Datenbankschema, die Referenzdatentabellen und die historischen Archivdaten, die nicht aktiv verändert werden. Damit stand die Aurora-Umgebung, und wir konnten die Schemakonvertierung an realen Datenmengen validieren, ohne die Produktion zu gefährden. Für diese Phase nutzten wir den initialen DMS-Full-Load, der für die 50 TB 11 Tage dauerte. Das Datenvolumen bereitete DMS keine Schwierigkeiten, doch Probleme mit IAM-Berechtigungen und der VPC-Routing-Konfiguration kosteten uns rund zwei Tage Fehlersuche – vorhersehbar für alle, die schon mit DMS gearbeitet haben, aber es lohnt sich, dafür Zeit einzuplanen.
Phase 2 – Laufende Replikation und Shadow-Validierung (Wochen 5–14): Aktiviert wurden die laufende DMS-Replikation und der Shadow-Read-Validierungsservice. Diese Phase dauerte zehn Wochen und damit länger als ursprünglich geplant, weil wir die Abweichungsdaten nutzten, um die Schemakonvertierung Schritt für Schritt zu verbessern. Das Go/No-go-Kriterium für Phase 3 lautete: keine Abweichungen in einem durchgehenden Überwachungsfenster von 72 Stunden. In Woche 14 war es erreicht.
Phase 3 – Vorbereitung der Anwendungsschicht (Wochen 15–22): Die Verbindungsschicht der Anwendung wurde so umgebaut, dass sie zwei Datenbankverbindungen unterstützt. Mit Feature-Flags konnten wir den Lesezugriff vor dem Schreibzugriff auf Aurora verlagern, und wir schlossen die Lasttests der Aurora-Umgebung unter simuliertem Spitzenverkehr ab. Aurora ist aus Performance-Sicht kein Drop-in-Ersatz für Oracle – die Pfade der Abfrageoptimierung sind andere, und mehrere Abfragen, die unter Oracle gut liefen, brauchten für Aurora zusätzliche Indizes oder eine Umstrukturierung. Diese Arbeit erledigten wir in Phase 3, bevor Produktionsverkehr auf Aurora traf, und nutzten für die Lasttests Klone der Produktionsdaten.
Phase 4 – Cutover (Woche 24, an einem einzigen Wochenende durchgeführt): Der eigentliche Cutover erfolgte in Stufen. Zuerst wurde der gesamte Lesezugriff auf Aurora verlagert (über die in Phase 3 gebauten Feature-Flags), während die Schreibzugriffe weiter nach Oracle gingen. Wir beobachteten das System 4 Stunden unter echtem Leseverkehr, bevor wir fortfuhren. Dann, am Sonntag um 2 Uhr nachts, als das Bestellvolumen sein Tagesminimum erreichte, stoppten wir die Anwendung, ließen DMS die letzte Replikationsverzögerung auf null abbauen, stuften Aurora zur primären Datenbank hoch, stellten die Anwendungskonfiguration auf Schreibzugriffe nach Aurora um und starteten die Anwendung neu. Gesamte Ausfallzeit: 8 Minuten. Oracle blieb nach dem Cutover 14 Tage lang als Rollback-Option verfügbar; eine einseitige Replikation von Aurora zurück nach Oracle hielt die Datenbank während des Rollback-Fensters aktuell.
Performance-Tuning auf Aurora
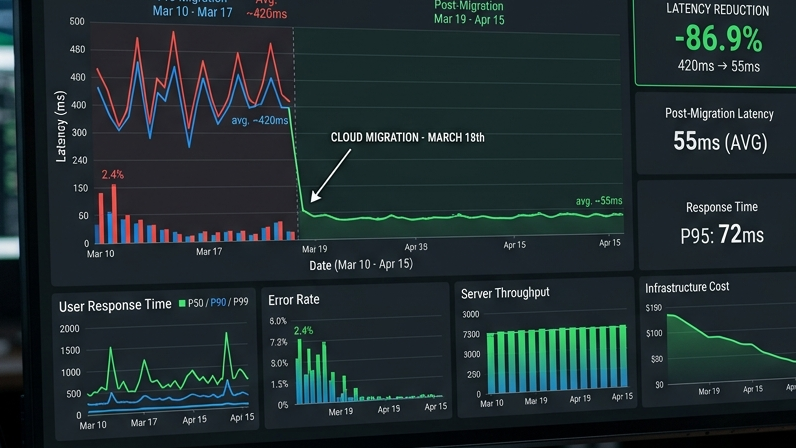
Die Performance-Geschichte hatte zwei Kapitel. Das erste, unmittelbar nach dem Cutover, gab Anlass zur Sorge: Mehrere stark genutzte Abfragen liefen auf Aurora 40–60 % langsamer als auf Oracle. Das zweite Kapitel, nach zwei Wochen Tuning, fiel besser aus, als wir anfangs prognostiziert hatten.
Die langsamste Abfrage war eine Bestellsuche, die die Anwendung häufig mit einer Kombination von Filterparametern ausführte, für die der Abfrageoptimierer von Aurora einen schlechten Ausführungsplan erzeugte. Der Oracle-Ausführungsplan nutzte für diese Abfrage eine Indexkombination, die der Planer von Aurora nicht wählte. Ein zusammengesetzter Index und das Umschreiben der Abfrage auf CTEs statt verschachtelter Subqueries brachten die Ausführungszeit auf Aurora um 12 % unter den Oracle-Ausgangswert. Ein ähnliches Muster zeigte sich bei 8 weiteren Abfragen – jede erforderte die Analyse des Ausführungsplans, einen zusätzlichen Index oder ein Umschreiben sowie die Validierung unter Last.
Auch das Connection Pooling von Aurora musste angepasst werden. Die Oracle-Umgebung arbeitete mit Connection Pooling und sehr langlebigen Verbindungen. Aurora auf Basis von PostgreSQL reagiert empfindlicher auf die Zahl der Verbindungen und profitiert von kürzeren Verbindungslebensdauern und konsequentem Recycling im Pool. Nach der Anpassung der RDS-Proxy-Einstellungen und der Konfiguration des Verbindungspools in der Anwendung waren die verbindungsbezogenen Performance-Probleme beseitigt.
Die Performance-Kennzahlen im Endzustand, gemessen 60 Tage nach dem Cutover: Die durchschnittliche Antwortzeit der Abfragen verbesserte sich gegenüber dem Oracle-Ausgangswert um 18 %. Die p99-Antwortzeit (die langsamsten 1 % der Abfragen) verbesserte sich um 31 %, vor allem weil die I/O-Architektur von Aurora Workloads mit hoher Streuung gleichmäßiger bewältigt als der HDD-Speicher, den die Oracle-Umgebung nutzte. Read Replicas in zwei weiteren Availability Zones brachten eine Redundanz, die das Oracle-Setup nicht hatte.
Der Rollback-Plan, den wir nicht brauchten (und trotzdem gern hatten)
Eine Migration dieser Größenordnung ohne glaubwürdigen Rollback-Plan ist nicht produktionsreif. Die Freigabe für den Cutover in Phase 4 hing davon ab, dass der Rollback-Plan getestet und nicht nur dokumentiert war.
Der Rollback-Plan bestand aus drei Teilen. Erstens blieb Oracle nach dem Cutover 14 Tage lang verfügbar und aktuell, gepflegt über eine einseitige Replikation von Aurora. Ein Rollback wäre so abgelaufen: Schreibzugriffe der Anwendung auf Aurora stoppen, die einseitige Replikation aufholen lassen, die Verbindungskonfiguration der Anwendung zurück auf Oracle umstellen und neu starten. Geschätzte Rollback-Dauer: 15 Minuten plus die Zeit, in der die Replikationsverzögerung abgebaut wird. Wir testeten das vor dem produktiven Cutover zweimal in der Staging-Umgebung.
Zweitens hatten wir unmittelbar vor dem Cutover in Phase 4 einen Datenbank-Snapshot erstellt. Er war die „letzte Instanz“, falls das Rollback über die Replikation aus irgendeinem Grund scheitern sollte. Die Wiederherstellung von 50 TB aus einem Snapshot dauert deutlich länger – wir schätzten 4–6 Stunden –, aber die Option bestand.
Drittens blieben die in Phase 3 gebauten Feature-Flags der Anwendung auch nach dem Cutover aktiv. Zeigten einzelne Anwendungsfunktionen in der Produktion Probleme, die auf bestimmte Abfragepfade beschränkt waren, konnten wir genau diese Pfade wieder auf Lesezugriffe über Oracle zurückschalten, ohne ein vollständiges Rollback. Das war die gezielteste Option; sie war für Szenarien eines „Teilerfolgs“ gedacht, in denen der Cutover größtenteils funktionierte, ein Bereich aber mehr Zeit brauchte.
Der Rollback-Plan kam nie zum Einsatz. Das sagt nichts über seine Qualität aus, sondern darüber, was die 14-wöchige Shadow-Validierung geleistet hat. Beim Cutover hatten wir großes Vertrauen in die Datenkonsistenz, weil wir sie kontinuierlich gemessen hatten.
Ergebnisse und Erkenntnisse
Sechs Monate nach dem Cutover sehen die Zahlen so aus: Die Oracle-Lizenzkosten entfielen (etwa 1,2 Mio. Dollar pro Jahr), die Hardwarekosten der Co-Location entfielen (etwa 380.000 Dollar pro Jahr), die Betriebskosten von Aurora im aktuellen Umfang betragen etwa 420.000 Dollar pro Jahr. Die jährliche Nettoersparnis liegt bei etwa 1,16 Mio. Dollar Die Kosten des Migrationsprojekts (einschließlich des GTEMAS-Einsatzes, der AWS-Migrationsgutschriften und des internen Aufwands) beliefen sich auf etwa 680.000 Dollar. Amortisationszeit: etwa 7 Monate.
Über die Kosten hinaus ist der Gewinn an Flexibilität in der Infrastruktur beträchtlich. Der Kunde kann die Lesekapazität von Aurora jetzt je nach Verkehrsmuster hoch- und herunterskalieren, ohne auf die Lieferzeiten für Hardware zu warten. Die Hochsaison 2024 lief ohne Zwischenfall auf Aurora, mit 215.000 Bestellungen am umsatzstärksten Tag – ein neuer Rekord – und einer p99-Latenz, die niedriger war als die, die die Oracle-Umgebung im normalen Betrieb geliefert hatte.
Die Erkenntnisse sind für jeden vorhersehbar, der Migrationen dieser Größe durchgeführt hat, aber sie sind es wert, wiederholt zu werden, weil Projekte hier weiterhin zu wenig investieren. Die Shadow-Validierung ist kein verzichtbarer Mehraufwand, sondern der Mechanismus, der Konvertierungsfehler findet, bevor sie zu Vorfällen in der Produktion werden. Die prozedurale Schicht von Oracle erforderte deutlich mehr manuelle Neuentwicklung, als die SCT-Schätzungen nahelegten. Das Performance-Tuning auf der Zielplattform braucht Lasttestdaten im Produktionsmaßstab, keine Schätzungen aus Entwicklungsumgebungen. Und der Rollback-Plan muss getestet und nicht nur dokumentiert sein.
Wenn Ihr Unternehmen eine Datenbankmigration größeren Umfangs prüft – insbesondere von Oracle nach PostgreSQL oder Aurora –, entscheiden Planung, Validierung und Tuning über Erfolg oder Misserfolg des Projekts. GTEMAS kann Ihnen helfen, den Aufwand von Anfang an realistisch einzugrenzen.