

Escenario ilustrativo: este artículo es un ejemplo compuesto, escrito para mostrar cómo se ejecuta un proyecto de este tipo. No describe a un cliente identificado y las cifras son ilustrativas.
La situación
En enero de 2024 iniciamos conversaciones con un grupo minorista regional cuya plataforma de comercio electrónico procesaba unos 40.000 pedidos diarios en períodos normales y más de 200.000 en las grandes campañas de ventas. Su backend funcionaba sobre Oracle Database 19c, alojado on-premise en dos centros de datos de colocación. La base de datos contenía unos 50TB de datos transaccionales: pedidos, inventario, registros de clientes, historial de despachos y siete años de registros de auditoría que el cumplimiento normativo les obligaba a conservar.
El problema no era que la configuración actual estuviera fallando, sino que se estaba volviendo insostenible. Los costos de licencias de Oracle habían subido un 34% en los tres años anteriores, en parte por las agresivas prácticas de auditoría de Oracle y en parte por un crecimiento real del volumen de datos. El ciclo de renovación del hardware de sus servidores en colocación estaba vencido, y el gasto de capital necesario para renovar la infraestructura on-premise y, a la vez, invertir en la hoja de ruta de producto no era viable. Migrar a la nube era la decisión estratégica correcta.
La restricción que volvió el proyecto realmente difícil: no podían permitirse tiempo de inactividad durante su temporada alta, que va de septiembre a enero. El proyecto comenzaba en febrero de 2024 y el cutover a producción debía completarse antes de septiembre de ese año. Eso nos daba unos siete meses para migrar 50TB de una base de datos de producción activa sin ventana de mantenimiento.
Por qué Aurora, y por qué el esquema no era un asunto sencillo
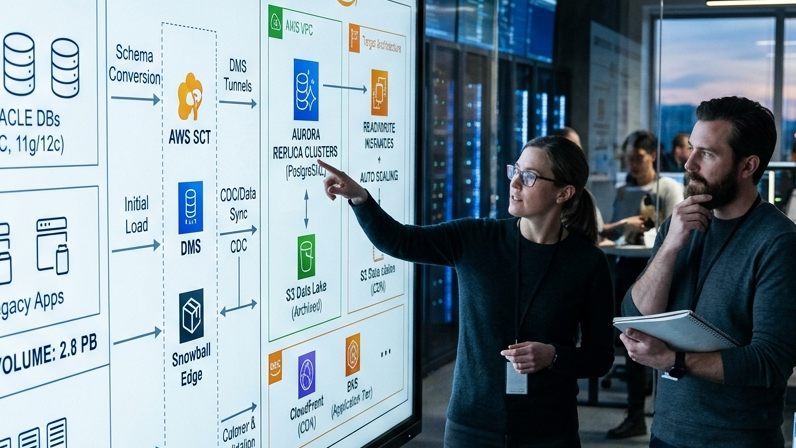
La plataforma de destino se decidió antes de nuestra intervención: el CTO del cliente había evaluado Aurora PostgreSQL frente a Aurora MySQL y RDS Oracle (que habría conservado el dialecto de Oracle) y eligió Aurora PostgreSQL por una combinación de costo, rendimiento y mantenibilidad a largo plazo. Coincidimos con la conclusión, pero las implicaciones eran importantes: migrar de Oracle a PostgreSQL no es un lift-and-shift. Es un port de base de datos que exige atender la sintaxis, los tipos de datos y la lógica procedimental específicos de Oracle, que no se traducen de forma directa.
La base de datos Oracle del cliente tenía 847 procedimientos almacenados, 130 triggers y 23 paquetes: una cantidad considerable de lógica de negocio acumulada durante 11 años de desarrollo. La primera fase del proyecto fue una auditoría completa de esta capa procedimental para identificar las construcciones específicas de Oracle que habría que reescribir. AWS Schema Conversion Tool (SCT) nos dio una ventaja inicial: automatizó la conversión de aproximadamente el 60% de los procedimientos almacenados sin intervención manual. El 40% restante requirió reescritura manual en distinto grado, desde pequeños ajustes de sintaxis hasta una reestructuración completa de la lógica en los casos en que los modelos de ejecución de Oracle y PostgreSQL difieren de fondo.
Los problemas de conversión más comunes fueron: la función DECODE de Oracle (reemplazada por expresiones CASE), las secuencias de Oracle frente a las de PostgreSQL (sintaxis distinta, semántica compatible), la conversión implícita TO_DATE de Oracle (PostgreSQL es más estricto con los formatos de fecha) y varios procedimientos almacenados que usaban la sintaxis jerárquica CONNECT BY de Oracle (reemplazada por las CTE recursivas de PostgreSQL). Usamos Orafce, una extensión de PostgreSQL que implementa funciones de compatibilidad con Oracle, para reducir la superficie de reescritura: no elimina el trabajo, pero lo reduce de forma apreciable en los patrones habituales.
La estrategia de migración: escritura dual y lecturas en sombra
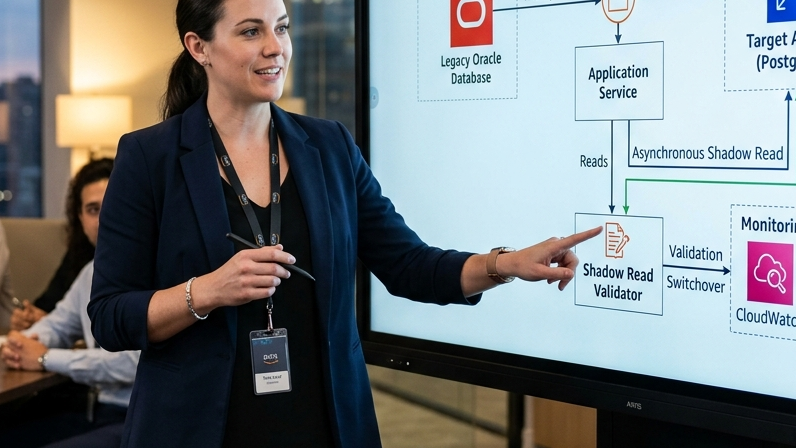
Migrar una base de datos de 50TB sin ventana de mantenimiento exige una estrategia que mantenga dos bases de datos consistentes a la vez mientras el tráfico sigue llegando al sistema de origen. Usamos escritura dual con lecturas en sombra para la validación, sobre AWS Database Migration Service (DMS) como capa de replicación continua.
La arquitectura funcionaba así. DMS se configuró en modo de replicación continua para replicar los cambios de Oracle a Aurora PostgreSQL casi en tiempo real: normalmente con un retraso de 2–5 segundos con carga normal, que subía a 15–20 segundos en los picos de tráfico. Durante el período de migración, la aplicación escribía y leía exclusivamente en Oracle. En paralelo, un servicio en sombra consumía una copia de todas las operaciones de escritura y las reproducía en Aurora PostgreSQL, lo que nos permitía validar que ambas bases de datos convergían al mismo estado.
El componente de lecturas en sombra fue la pieza técnicamente más interesante. Construimos un servicio de validación que tomaba periódicamente muestras de registros de ambas bases de datos (50.000 registros por hora, elegidos por hash para asegurar una distribución uniforme en el conjunto de datos) y los comparaba campo por campo. Las discrepancias se registraban con todo su contexto: el identificador del registro, el nombre del campo, el valor en Oracle, el valor en Aurora y la marca de tiempo de la última modificación en cada sistema. Esto nos dio una visión continua de la integridad de los datos durante la migración y nos permitió detectar problemas de conversión del esquema que no habían aparecido en el entorno de desarrollo.
Durante el período de lecturas en sombra encontramos once categorías de discrepancias. La mayoría eran menores: diferencias de precisión numérica, porque el tipo numérico por defecto de Oracle se comporta distinto que el de PostgreSQL; diferencias en el manejo de zonas horarias en las marcas de tiempo; y el tratamiento de NULL frente a cadena vacía en datos heredados. Dos fueron más importantes: un procedimiento almacenado de aritmética de fechas que se comportaba distinto en ambos sistemas en casos límite con cambios de horario de verano, y un trigger con un comportamiento propio de Oracle para manejar violaciones de clave duplicada, que no habíamos replicado por completo en la versión de PostgreSQL. Ambos se detectaron y corrigieron durante el período de operación en paralelo, antes de que hubiera riesgo de corrupción de datos en producción.
El enfoque por fases: cuatro etapas hasta el cutover
En lugar de tratarlo como un evento único, estructuramos la migración en cuatro fases diferenciadas, con criterios de go/no-go definidos en cada etapa.
Fase 1 – Esquema y datos estáticos (semanas 1–4): migrar el esquema de la base de datos, las tablas de datos de referencia y los datos históricos de archivo que no se modifican de forma activa. Esto estableció el entorno de Aurora y nos permitió validar la conversión del esquema con volúmenes de datos reales, sin ningún riesgo para producción. Para esta fase usamos la carga completa inicial de DMS, que tardó 11 días en completarse con los 50TB. DMS no tuvo dificultades con el volumen, pero nos encontramos con problemas de permisos de IAM y de configuración del enrutamiento de VPC que consumieron unos dos días de depuración: algo predecible para quien haya trabajado antes con DMS, pero que conviene prever.
Fase 2 – Replicación continua y validación en sombra (semanas 5–14): activar la replicación continua de DMS y el servicio de validación con lecturas en sombra. Esta fase duró diez semanas, más de lo planificado originalmente, porque usamos los datos de discrepancias para mejorar la conversión del esquema de forma iterativa. El criterio de go/no-go para la Fase 3 fue cero discrepancias en una ventana de monitoreo continuo de 72 horas. Alcanzamos ese criterio en la semana 14.
Fase 3 – Preparación de la capa de aplicación (semanas 15–22): migrar la capa de conexión de la aplicación para que admitiera dos conexiones de base de datos, implementar feature flags que permitieran trasladar el tráfico de lectura a Aurora antes que el de escritura, y completar las pruebas de carga del entorno de Aurora con tráfico pico simulado. En rendimiento, Aurora no es un reemplazo directo de Oracle: las rutas de optimización de consultas son distintas, y varias consultas que rendían bien en Oracle requirieron agregar índices o reestructurar la consulta para Aurora. Este trabajo se hizo en la Fase 3, antes de que ningún tráfico de producción tocara Aurora, usando clones de datos de producción para las pruebas de carga.
Fase 4 – Cutover (semana 24, ejecutado durante un solo fin de semana): el cutover se ejecutó por etapas. Primero se trasladó todo el tráfico de lectura a Aurora (con los feature flags construidos en la Fase 3) mientras las escrituras seguían en Oracle. Monitoreamos durante 4 horas con tráfico de lectura real antes de continuar. Luego, a las 2 a. m. del domingo, cuando el volumen de pedidos estaba en su mínimo diario, detuvimos la aplicación, dejamos que DMS llevara a cero el retraso final de replicación, promovimos Aurora a primaria, actualizamos la configuración de la aplicación para escribir en Aurora y la reiniciamos. Tiempo de inactividad total: 8 minutos. Oracle siguió disponible durante 14 días tras el cutover como opción de rollback, con replicación unidireccional de Aurora a Oracle para mantenerlo al día durante esa ventana.
Ajuste de rendimiento en Aurora
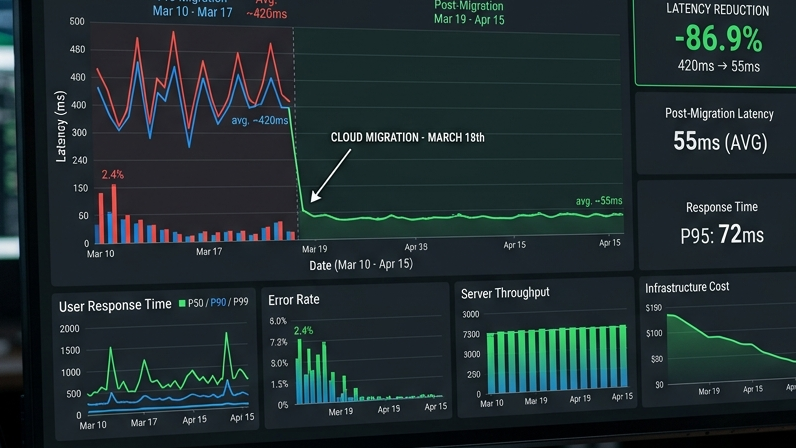
La historia del rendimiento tuvo dos capítulos. El primero, justo después del cutover, fue preocupante: varias consultas de mucho tráfico se ejecutaban entre un 40% y un 60% más lento en Aurora que en Oracle. El segundo, tras dos semanas de ajuste, fue mejor de lo que habíamos proyectado al principio.
La consulta más lenta era una búsqueda de pedidos que la aplicación ejecutaba con frecuencia, con una combinación de parámetros de filtro que generaba un mal plan de ejecución en el optimizador de consultas de Aurora. El plan de Oracle para esa consulta usaba una combinación de índices que el planificador de Aurora no elegía. Al agregar un índice compuesto y reescribir la consulta con CTE en lugar de subconsultas anidadas, el tiempo de ejecución en Aurora quedó un 12% por debajo de la referencia de Oracle. Apareció un patrón similar en otras 8 consultas: cada una requirió analizar el plan de ejecución, agregar un índice o reescribir la consulta, y validar bajo carga.
También hubo que ajustar el comportamiento del pool de conexiones de Aurora. El entorno Oracle usaba pools con conexiones de muy larga duración. Aurora, que corre sobre PostgreSQL, es más sensible al número de conexiones y se beneficia de conexiones más cortas y de un reciclaje agresivo del pool. Tras ajustar la configuración de RDS Proxy y la del pool de conexiones de la aplicación, los problemas de rendimiento relacionados con las conexiones desaparecieron.
Las métricas finales de rendimiento, medidas 60 días después del cutover: el tiempo medio de respuesta de las consultas mejoró un 18% respecto a la referencia de Oracle. El tiempo de respuesta p99 (el 1% de consultas más lentas) mejoró un 31%, sobre todo porque la arquitectura de E/S de Aurora maneja las cargas de alta variabilidad de forma más consistente que el almacenamiento en discos giratorios que usaba el entorno Oracle. Las réplicas de lectura en dos zonas de disponibilidad adicionales aportaron una redundancia que la configuración de Oracle no tenía.
El plan de rollback que no necesitamos (pero que nos alegró tener)
Una migración de este alcance sin un plan de rollback creíble no está lista para producción. La aprobación del cutover de la Fase 4 dependía de que el plan de rollback estuviera probado, no solo documentado.
El plan de rollback tenía tres componentes. Primero, Oracle siguió disponible y actualizado durante 14 días tras el cutover, mediante replicación unidireccional desde Aurora. Si hubiera sido necesario revertir, el proceso era: detener las escrituras de la aplicación en Aurora, dejar que la replicación unidireccional se pusiera al día, devolver la configuración de conexión de la aplicación a Oracle y reiniciar. Tiempo estimado de rollback: 15 minutos más el tiempo de vaciado del retraso de replicación. Lo probamos dos veces en el entorno de staging antes del cutover a producción.
Segundo, mantuvimos un snapshot de la base de datos tomado inmediatamente antes del cutover de la Fase 4. Era la opción de "último recurso" si el rollback basado en replicación fallaba por cualquier motivo. Restaurar 50TB desde un snapshot tarda bastante más (lo estimamos en 4–6 horas), pero la opción existía.
Tercero, los feature flags de la aplicación construidos en la Fase 3 se mantuvieron tras el cutover. Si determinadas funciones de la aplicación mostraban problemas en producción, aislados en ciertas rutas de consulta, podíamos devolver esas rutas concretas a lecturas en Oracle sin un rollback completo. Era la opción más quirúrgica y estaba pensada para escenarios de "éxito parcial", en los que la mayor parte del cutover funcionaba pero un área necesitaba más tiempo.
El plan de rollback nunca se activó. Eso no habla de la calidad del plan, sino de lo que logró el período de 14 semanas de validación en sombra. Cuando hicimos el cutover, teníamos mucha confianza en la consistencia de los datos porque la habíamos estado midiendo de forma continua.
Resultados y lecciones aprendidas
Seis meses después del cutover, las cifras son: costos de licencias de Oracle eliminados (aproximadamente 1,2 M USD al año), costos de hardware de colocación eliminados (aproximadamente 380 mil USD al año) y costos de operación de Aurora a la escala actual de aproximadamente 420 mil USD al año. Ahorro neto anual: aproximadamente 1,16 M USD. El costo del proyecto de migración (incluido el servicio de GTEMAS, los créditos de migración de AWS y el tiempo interno) fue de aproximadamente 680 mil USD. Período de recuperación de la inversión: aproximadamente 7 meses.
Más allá del costo, la mejora en agilidad de la infraestructura es significativa. El cliente ahora puede aumentar o reducir la capacidad de lectura de Aurora según los patrones de tráfico, sin los plazos de adquisición de hardware. Pasó su temporada alta de 2024 sobre Aurora sin incidentes y procesó 215.000 pedidos en su día de mayor volumen, un récord, con una latencia p99 de consultas inferior a la que su referencia de Oracle ofrecía en períodos de operación normal.
Las lecciones son predecibles para quien haya hecho migraciones de esta escala, pero vale la pena repetirlas porque los proyectos siguen subinvirtiendo en ellas. La validación en sombra no es un costo prescindible: es el mecanismo que identifica los errores de conversión antes de que se conviertan en incidentes de producción. La capa procedimental de Oracle requirió mucho más esfuerzo de reescritura manual que el que estimaba SCT. El ajuste de rendimiento en la plataforma de destino necesita datos de pruebas de carga a escala de producción, no estimaciones de entornos de desarrollo. Y el plan de rollback debe probarse, no solo documentarse.
Si su organización está evaluando una migración de base de datos de gran escala, en particular de Oracle a PostgreSQL o a Aurora, el trabajo de planificación, validación y ajuste es donde el proyecto se gana o se pierde. GTEMAS puede ayudarle a dimensionar el trabajo de forma realista desde el principio.