

Oktober 2025
Beispielszenario: Dieser Artikel ist ein zusammengesetztes Beispiel, das zeigen soll, wie ein Projekt dieser Art abläuft. Er beschreibt keinen namentlich genannten Kunden, und die Zahlen dienen nur der Veranschaulichung.
Das Problem in diesem Szenario
Ich will nichts beschönigen: Als wir Anfang 2024 mit diesem Projekt begannen, dachte ich, wir wären in sechs Monaten fertig. Die FHIR-Fassade und die Onkologie-Pipeline gingen ab Mitte 2024 schrittweise in Betrieb; die Anbindung der Sozialversorgung, das schwierigste Stück, zahlte sich erst in den letzten Monaten aus. Inzwischen ist es Ende 2025, und wir kommen gerade erst beim gesamten Netzwerk in Fahrt.
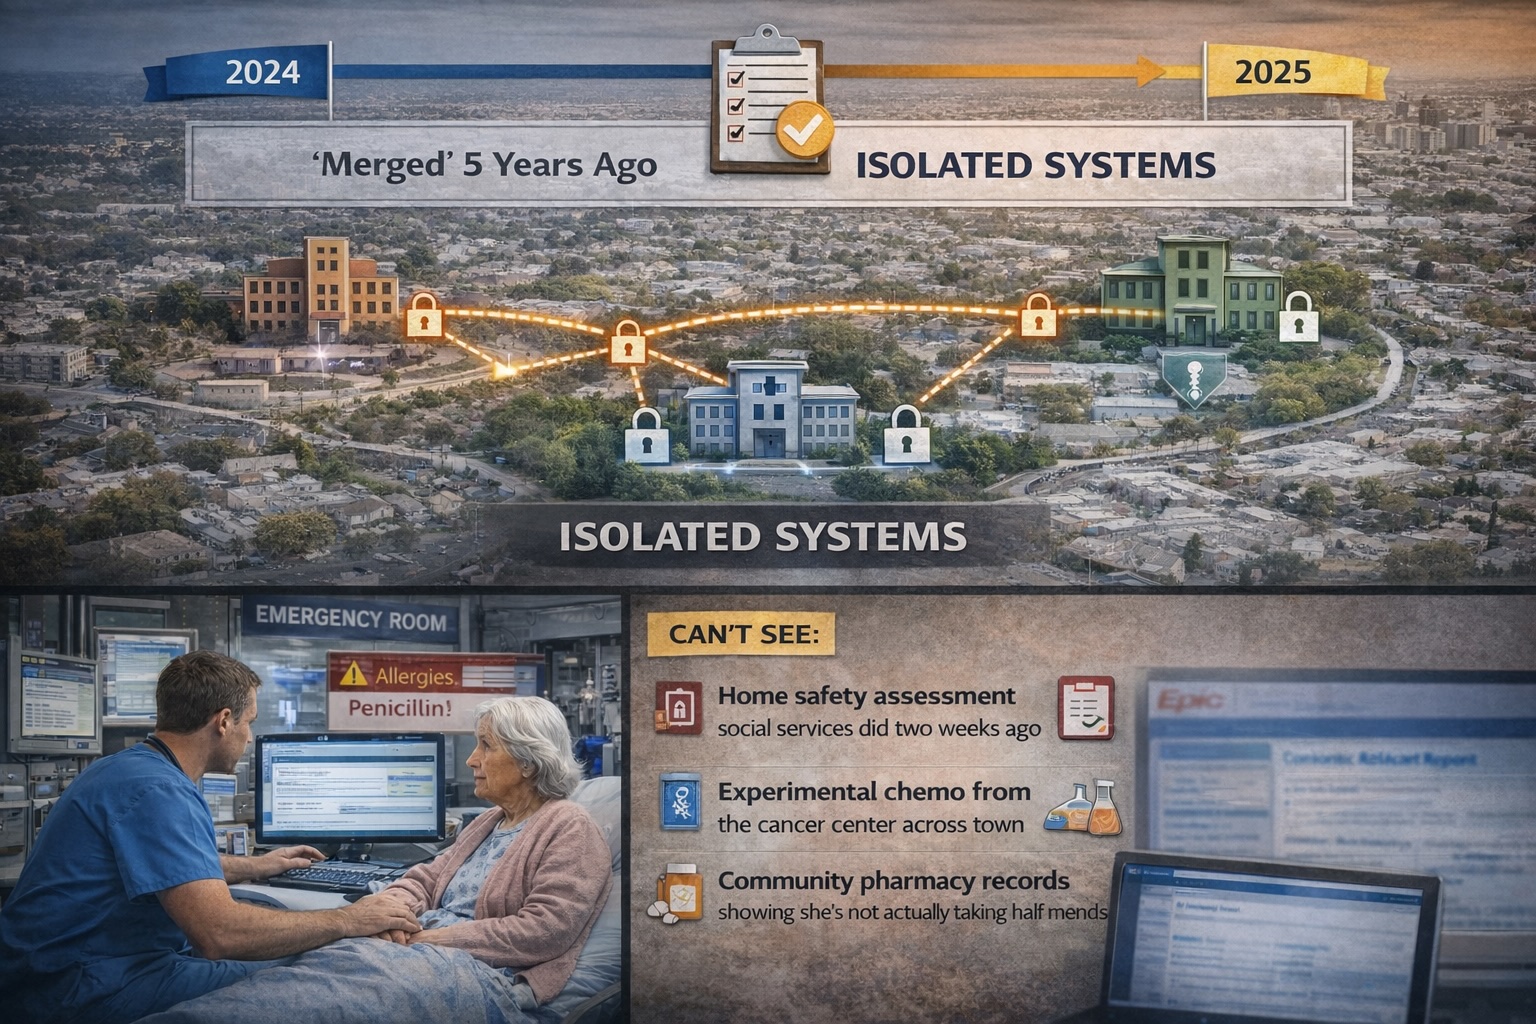
Das Gesundheitsnetzwerk in diesem Szenario umfasst drei Krankenhausgruppen, die rund 3,5 Millionen Menschen versorgen. Auf dem Papier waren sie vor fünf Jahren „fusioniert“. In der Praxis? Ihre Systeme waren weiterhin vollständig voneinander getrennt.
Was das konkret bedeutete: Eine ältere Patientin kommt nach einem Sturz in die Notaufnahme. Der Arzt sieht im System seines Krankenhauses, dass sie allergisch auf Penicillin ist. Gut. Was er nicht sehen kann:
- Die Einschätzung der Sicherheit in der Wohnung, die der Sozialdienst vor zwei Wochen erstellt hat
- Dass sie im Krebszentrum auf der anderen Seite der Stadt eine experimentelle Chemotherapie erhält
- Die Unterlagen ihrer Apotheke vor Ort, aus denen hervorgeht, dass sie die Hälfte ihrer Medikamente gar nicht nimmt
Das ist nicht theoretisch. Solche Lücken sind in fusionierten Gesundheitsnetzwerken verbreitet, und Patienten können zu Schaden kommen, wenn Unterlagen nicht geteilt werden.
Warum die bestehende Landschaft nicht funktionierte
Integrationsinfrastruktur gab es bereits ... eine Interface Engine, die täglich Millionen von HL7-v2-Nachrichten verarbeitete. Das Problem? Es waren ausschließlich Punkt-zu-Punkt-Verbindungen und Push-Nachrichten.
Man kann es sich so vorstellen: Wenn Ihnen jemand vor drei Monaten eine wichtige E-Mail geschickt hat, die im Spamfilter hängen blieb, existiert diese Information für Sie nicht. So arbeiteten ihre Systeme.
Die eigentliche Schwierigkeit war die Anbindung der Sozialversorgung. Ihre „moderne“ Integration war ein eigener VPN-Tunnel, der CSV-Dateien in HL7-Nachrichten umwandelte. Drei Entwickler hatten zwei Monate dafür gebraucht. Wir hatten 200 Hausarztpraxen anzubinden. Rechnen Sie selbst.
Das Forschungsteam hatte es noch schwerer. Es wollte bestimmte Datenpunkte (Tumorgrößen, Biomarkerwerte), aber alles steckte in PDF-Pathologieberichten. Jemand übertrug die Daten buchstäblich von Hand in Tabellenkalkulationen.
Was wir tatsächlich gebaut haben
Die Fassaden-Strategie (oder: wie man nicht alles ersetzt)
Die erste Frage, die alle stellen: „Haben Sie alle alten Systeme herausgerissen?“
Nein. Auf keinen Fall. Das hätte Dutzende Millionen Dollar gekostet und Jahre gedauert.
Stattdessen haben wir eine sogenannte FHIR-Fassade gebaut. Sie ist ein Übersetzer, der über den alten Datenbanken sitzt. Die Altsysteme bleiben genau dort, wo sie sind, aber wenn nun jemand einen modernen API-Aufruf macht (etwa GET /Patient/12345), übersetzt die Fassade ihn in die jeweilige kryptische SQL-Abfrage oder HL7-Abfrage, die das alte System braucht.
Für einfache Daten funktionierte das sehr gut. Für die komplexen Onkologie-Daten? Dafür brauchten wir etwas Schwereres.
Die Onkologie-Pipeline (wo es kompliziert wurde)
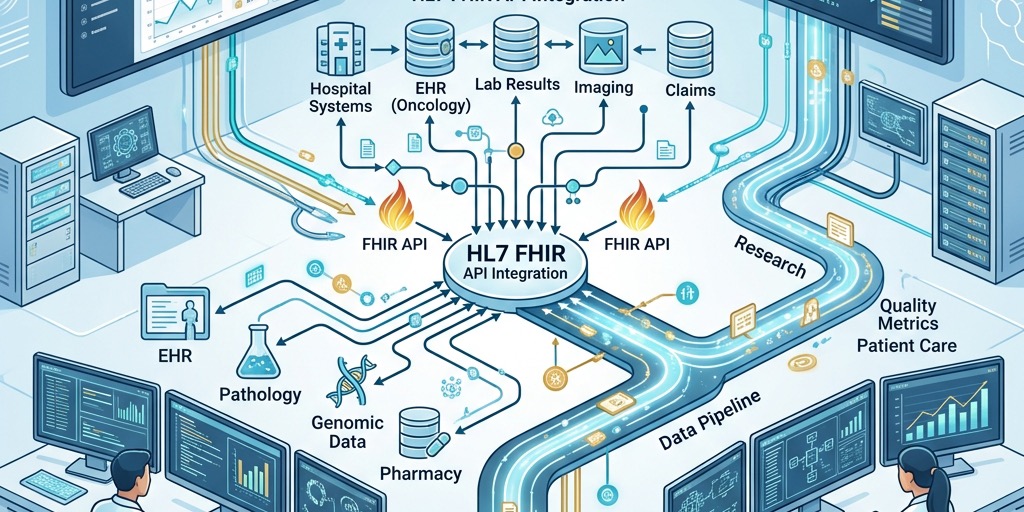
Pathologieberichte kamen als PDFs, als XML-Dateien, manchmal sogar als eingescannte Bilder. Wir bauten eine Pipeline:
- Ingestion – Berichte laufen über Kafka-Streams ein
- Parsing – Ein ETL-Service zerlegt die PDFs und das XML
- FHIR-Mapping – Umwandlung in korrekte FHIR-Ressourcen (Patient, Observation, Specimen)
- Anonymisierung – Entfernen personenbezogener Angaben vor dem Zugriff durch die Forschung
In dieser Aufzählung klingt das sauber. In der Realität? Wir brauchten drei Monate allein, um herauszufinden, wie sich Tumorabmessungen zuverlässig aus PDFs extrahieren lassen, weil jeder Pathologe seine Berichte anders formatiert.
Die Identitätskrise
Bevor wir klinische Daten teilen konnten, mussten wir die Frage „Wer ist diese Person?“ lösen.
Krankenhaus A kannte „Martha J. Jones“ (ID: 111). Der Sozialdienst kannte „Martha Jones“ (ID: 999). Das Krebszentrum kannte „M. Jones“ (ID: ABC-7734).
Wir führten einen Master Patient Index ein, der die Patient-Ressource von FHIR und die Operation $match nutzt. Wenn man jetzt einen Patienten abfragt, findet das System den „Golden Record“ und verknüpft alle drei Identitäten.
Beim ersten Lauf mit Produktionsdaten fanden wir rund 8.000 doppelte Patientendatensätze. Manche Personen hatten vier verschiedene IDs im Netzwerk.
Wo wir wirklich Neues geschaffen haben: die Anbindung der Sozialversorgung
Das war der schwierigste Teil, und ehrlich gesagt bin ich auf das, was wir hier geleistet haben, am meisten stolz.
Krankenhaussysteme verwenden standardisierte medizinische Codes wie SNOMED-CT und LOINC. Unterlagen der Sozialversorgung? Freitextnotizen wie „Patient geht mit Mühe“ oder „Braucht Hilfe beim Einkaufen“.
Wir nutzten die FHIR-Ressourcen CarePlan und Consent auf eine Weise, die ich anderswo noch nicht gesehen habe:
CarePlan: Der Unterstützungsplan der Sozialarbeiterin erscheint direkt auf dem Bildschirm der Pflegekraft im Entlassmanagement des Krankenhauses. Nicht als PDF-Anhang, sondern als strukturierte, nutzbare Daten.
Consent: Dieser Punkt ist entscheidend. Wir bauten fein abgestufte Einwilligungskontrollen, sodass ein Patient erlauben konnte, seinen HIV-Status mit dem Krankenhaus zu teilen, aber nicht mit der Leitung des Pflegeheims.
Für das Freitext-Problem schickten wir alles durch eine NLP-Engine, die „geht mit Mühe“ dem passenden SNOMED-Code für eingeschränkte Mobilität zuordnete. Plötzlich tauchten bei der Suche eines Arztes nach Mobilitätsproblemen auch Unterlagen der Sozialversorgung auf – obwohl sie als reiner Text begonnen hatten.
Sicherheit (oder: wie wir keinen Albtraum aus Datenlecks geschaffen haben)
Das Öffnen von APIs über Organisationsgrenzen hinweg macht Sicherheitsverantwortliche nervös. Zu Recht.
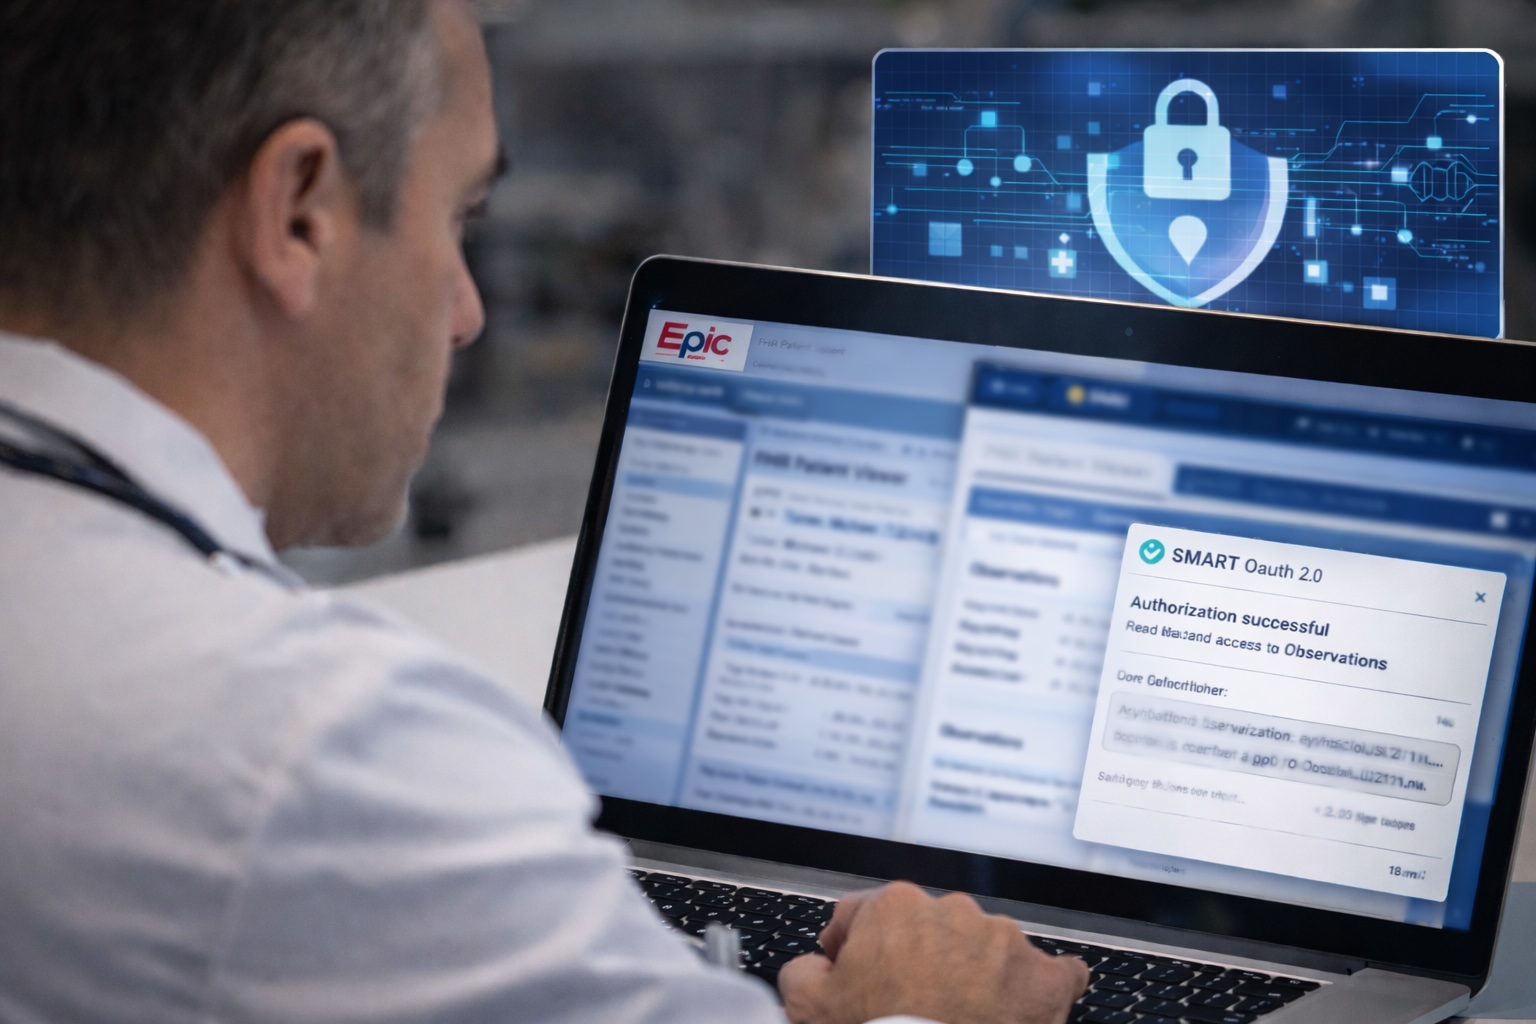
Wir setzten SMART on FHIR ein, das die Autorisierung im Grunde an OAuth 2.0 delegiert. So läuft das in der Praxis ab:
Ein Arzt klickt in seinem Epic-System auf „Community-Akte anzeigen“. Das startet unsere App in einem iframe und übergibt den Kontext (welcher Nutzer, welcher Patient). Unser Autorisierungsserver prüft Anmeldedaten und Berechtigungen. Ist alles in Ordnung, erhält der Arzt ein Access Token, das genau auf das Nötige begrenzt ist. Vielleicht nur Lesezugriff auf Observations, sonst nichts.
Im Test gab es einen Beinahe-Vorfall, bei dem das Token einer Person nicht korrekt ablief. Das wurde schnell behoben.
Was sich tatsächlich verändert hat
Seit die FHIR-Fassade Mitte 2024 in Betrieb ging:
Doppelte Labortests sanken um 30 %, weil Ärzte in der Notaufnahme endlich aktuelle Ergebnisse aus Fachzentren sehen konnten. Das spart echtes Geld und bedeutet echten Komfort für die Patienten. Niemand will zweimal mit der Nadel gestochen werden.
Die Entlassungsplanung verkürzte sich von vier Tagen auf anderthalb. Wenn das Entlassungsteam im Krankenhaus den Sozialversorgungsplan sofort einsehen kann, hört das dreitägige Hinterhertelefonieren offenbar auf.
Medikationsfehler gingen um 18 % zurück. Wir führten die Verordnungen der Krankenhäuser und die Abgaben der Apotheken vor Ort in einer einzigen MedicationStatement-Ansicht zusammen.
Das Forschungsteam verkürzte den Aufbau einer Kohorte von vier Monaten auf zwei Wochen. Es veröffentlicht jetzt tatsächlich Fachartikel, statt die ganze Zeit mit der Datenaufbereitung zu verbringen.
Was wir gelernt haben (auf die harte Tour)
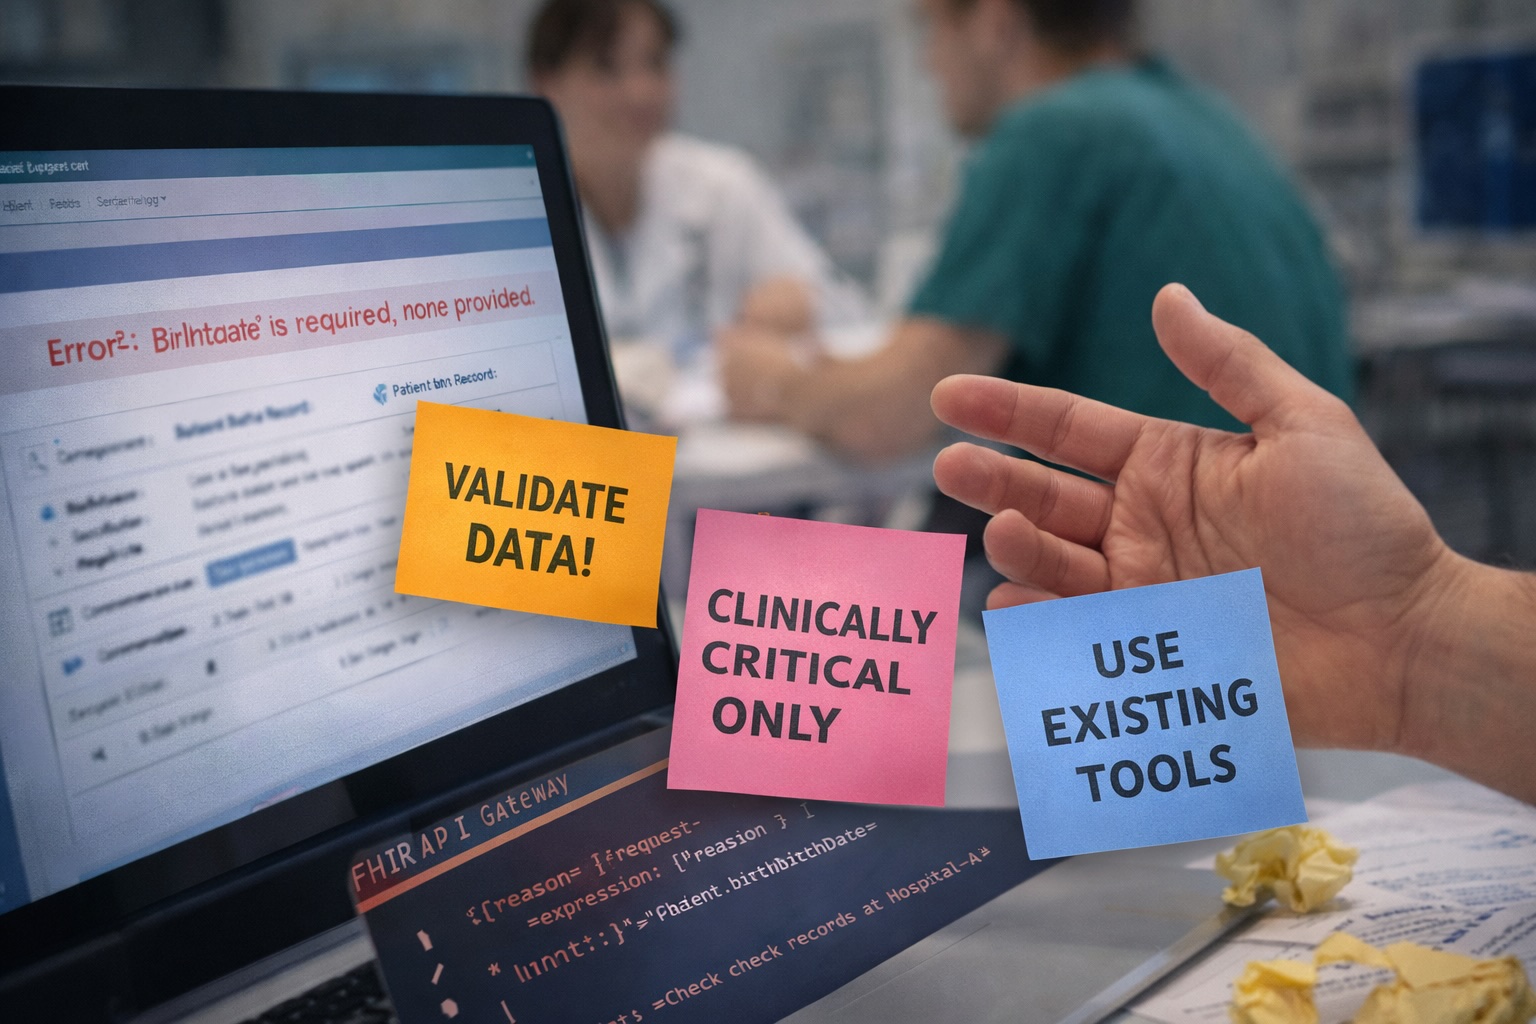
Nicht alles mappen. Anfangs wollten wir jedes einzelne Feld jeder Altdatenbank nach FHIR überführen. Nach drei Monaten hatten wir kaum Fortschritte gemacht. Wir änderten den Kurs radikal. Gemappt wird nur, was für den konkreten Anwendungsfall klinisch kritisch ist. Alles andere kann bis Version 2 warten.
Konsequent validieren. Anfangs brachten fehlerhafte Daten unsere Apps immer wieder zum Absturz. Wir führten eine strenge Validierung am API-Gateway ein. Sendete ein System eine Patient-Ressource ohne Geburtsdatum (in unserem Profil Pflicht), lehnten wir sie mit einer detaillierten Fehlermeldung ab. Die Systeme verbesserten ihre Datenqualität sehr schnell.
Das kulturelle Problem ist schwerer als das technische. Sozialarbeiter wollten kein weiteres Login und kein weiteres System. Wir betteten unseren FHIR-Viewer per iframe direkt in ihr bestehendes Fallmanagement-Tool ein. Sie merkten nicht einmal, dass sie „neue Technologie“ nutzten. Es funktionierte einfach in ihrer vertrauten Oberfläche.
Wie es weitergeht
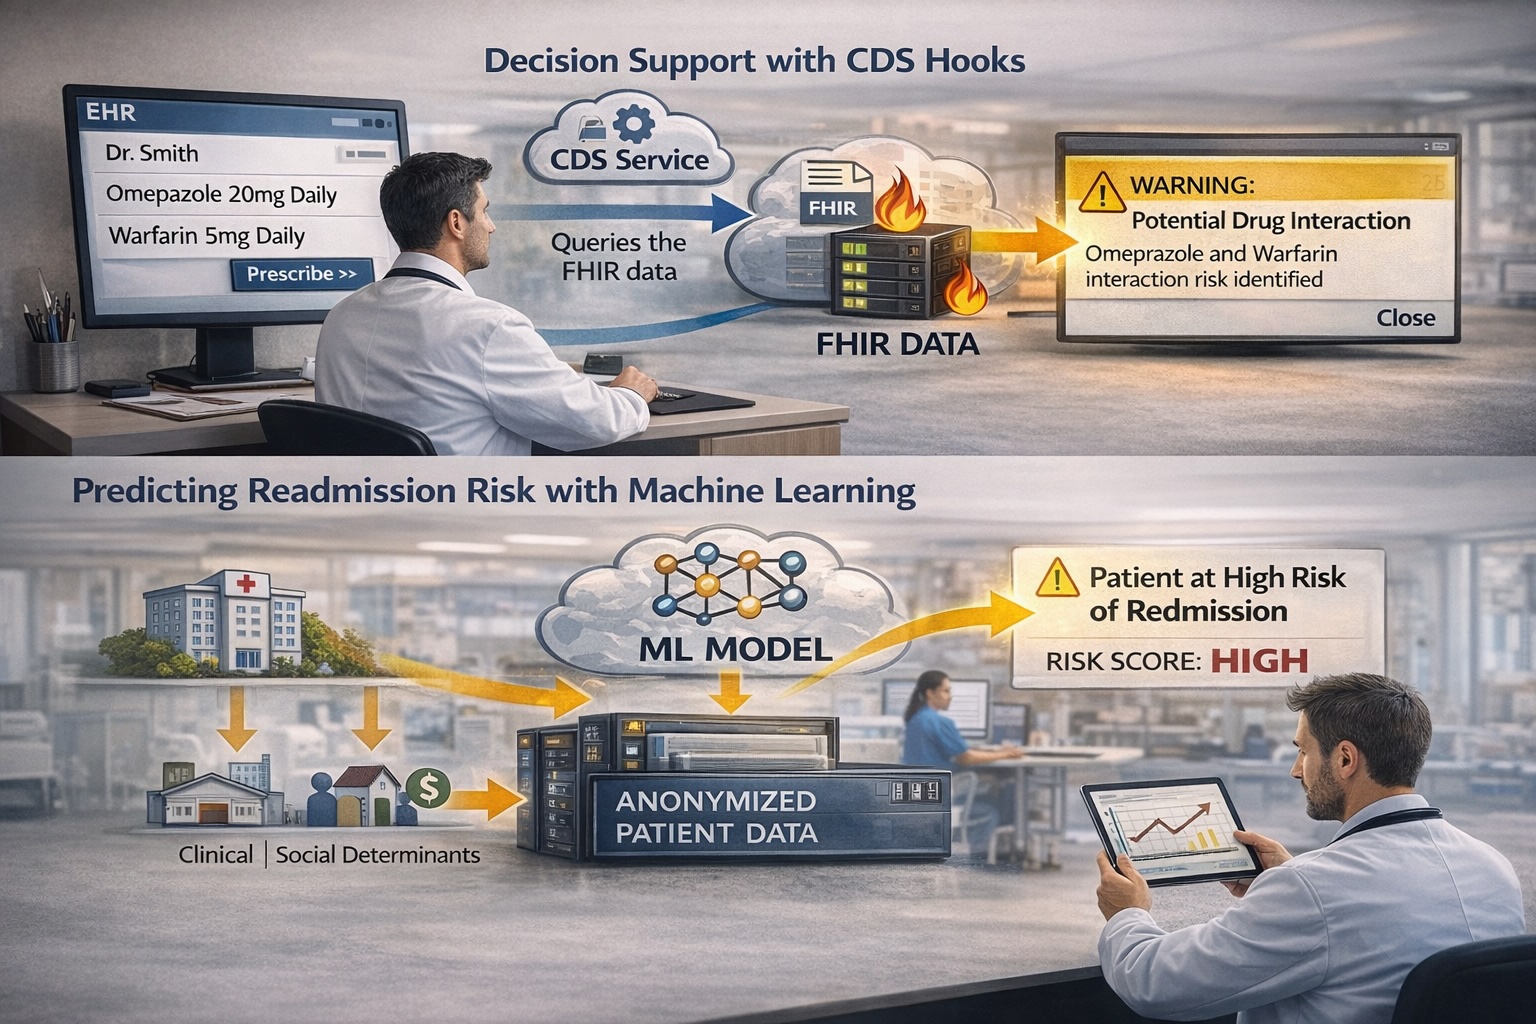
Mit dem fertigen Fundament gehen wir jetzt in die Entscheidungsunterstützung. Wir setzen CDS Hooks um. Verordnet ein Arzt ein Medikament, prüft ein Service die FHIR-Daten auf Gegenanzeigen und kann in Echtzeit eine Warnung einblenden.
Außerdem trainieren wir ML-Modelle mit den anonymisierten Daten, um das Wiederaufnahmerisiko vorherzusagen. Dabei werden klinische Daten und soziale Determinanten kombiniert. Das war unmöglich, solange alles in Silos lag.
Wenn Sie ein solches Projekt erwägen: Planen Sie mehr Zeit ein, als Sie denken, holen Sie das klinische Personal früh ins Boot und versuchen Sie bitte nicht, in Version 1 jedes Problem zu lösen.
Ich spreche gern über Details, wenn Sie vor ähnlichen Herausforderungen stehen. Die Fehler, die wir gemacht haben? Die müssen Sie nicht wiederholen.
Möchten Sie Ihre Interoperabilitäts-Herausforderungen besprechen? Lassen Sie uns ins Gespräch kommen.