

Tháng 10 năm 2025
Kịch bản minh họa: bài viết này là một ví dụ tổng hợp, được viết để cho thấy một dự án như vậy được vận hành ra sao. Bài không mô tả một khách hàng nào được nêu tên, và các số liệu chỉ mang tính minh họa.
Vấn đề trong kịch bản này
Nói thật, khi bắt đầu dự án này vào đầu năm 2024, tôi nghĩ sáu tháng là xong. FHIR facade và pipeline ung bướu lên sóng theo từng giai đoạn từ giữa năm 2024. Phần tích hợp chăm sóc xã hội, phần khó nhất, chỉ mới bắt đầu cho kết quả trong vài tháng gần đây. Bây giờ là cuối năm 2025 và chúng tôi mới bắt đầu vào nhịp với toàn mạng lưới.
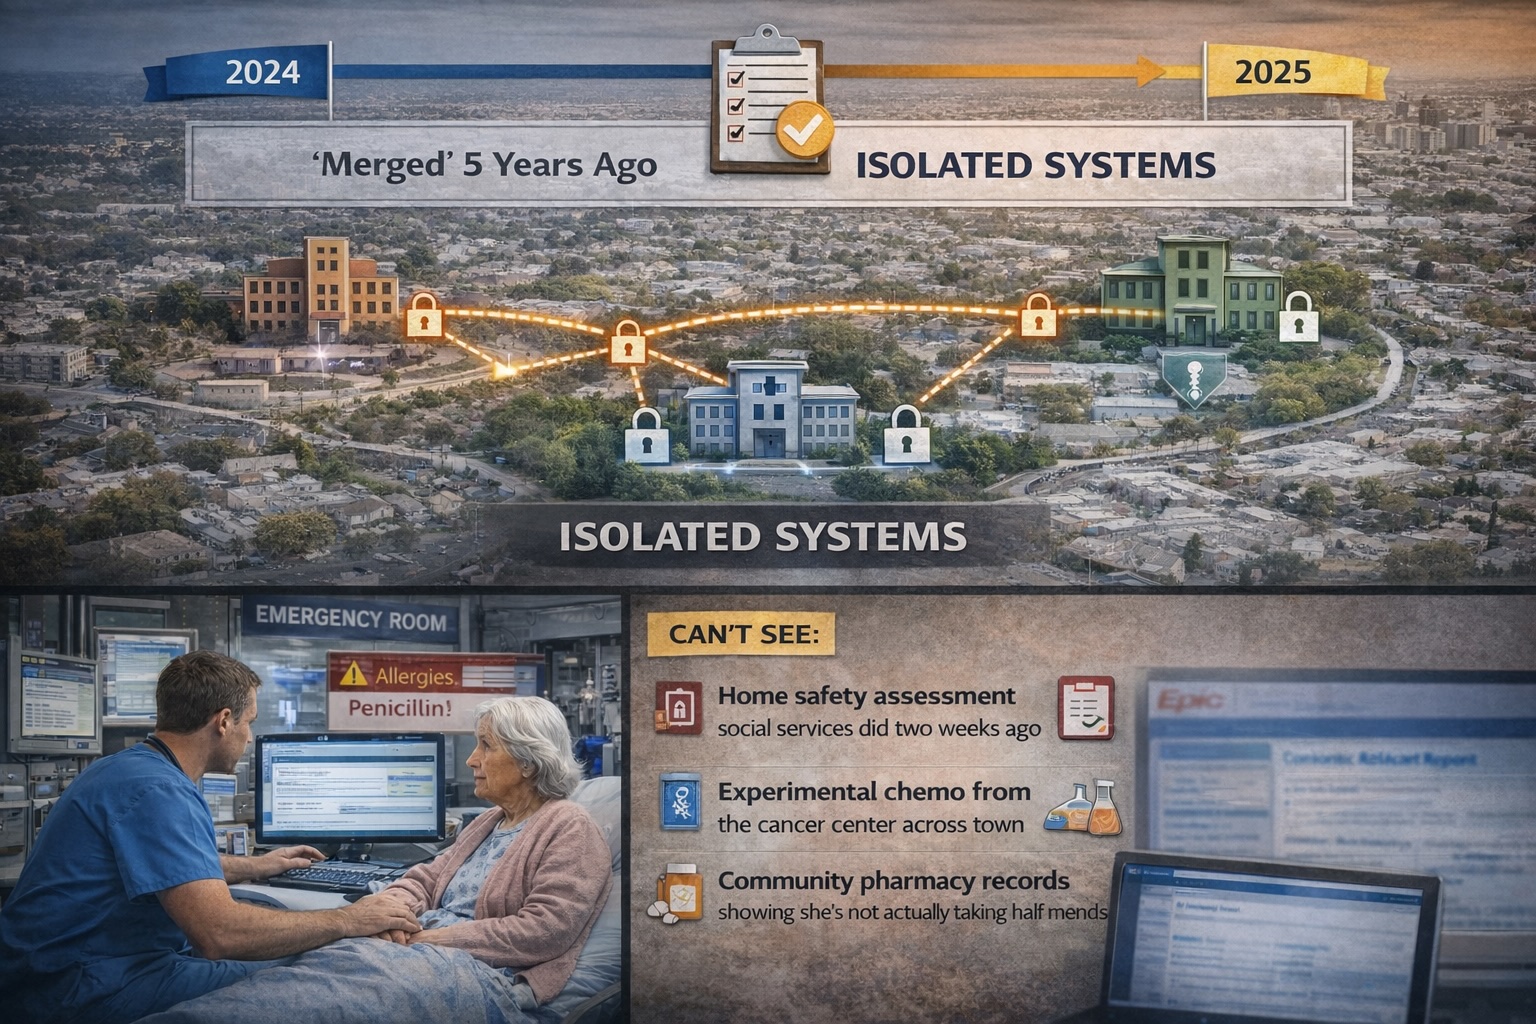
Mạng lưới y tế trong kịch bản này gồm ba nhóm bệnh viện, phục vụ khoảng 3,5 triệu người. Trên giấy tờ, họ đã "sáp nhập" từ năm năm trước. Trên thực tế, các hệ thống của họ vẫn tách biệt hoàn toàn.
Điều đó có nghĩa như sau. Một cụ bà nhập cấp cứu sau khi ngã. Bác sĩ thấy trong hệ thống của bệnh viện rằng bà dị ứng penicillin. Tốt. Nhưng bác sĩ không thấy được:
- Bản đánh giá an toàn tại nhà mà bộ phận công tác xã hội thực hiện hai tuần trước
- Việc bà đang dùng hóa trị thử nghiệm ở trung tâm ung bướu bên kia thành phố
- Hồ sơ nhà thuốc cộng đồng cho thấy thực tế bà không uống một nửa số thuốc
Đây không phải giả định. Những khoảng trống như vậy khá phổ biến ở các mạng lưới y tế đã sáp nhập, và bệnh nhân có thể bị tổn hại khi hồ sơ không được chia sẻ.
Hệ thống hiện có hỏng ở đâu
Họ đã có hạ tầng tích hợp: một interface engine xử lý hàng triệu thông điệp HL7 v2 mỗi ngày. Vấn đề là tất cả đều là kết nối điểm–điểm và nhắn tin kiểu đẩy (push).
Hình dung thế này: nếu ba tháng trước có người gửi bạn một email quan trọng nhưng nó rơi vào hộp thư rác, thì với bạn thông tin đó không tồn tại. Các hệ thống của họ vận hành đúng như vậy.
Phần đau đầu thật sự là kết nối bộ phận chăm sóc xã hội. Kết nối "hiện đại" của họ là một đường hầm VPN tự viết, chuyển tệp CSV thành thông điệp HL7. Ba lập trình viên mất hai tháng mới làm xong. Chúng tôi có 200 phòng khám chăm sóc ban đầu cần kết nối. Bạn tự tính đi.
Nhóm nghiên cứu còn vất vả hơn. Họ cần những điểm dữ liệu cụ thể (kích thước khối u, giá trị dấu ấn sinh học) nhưng mọi thứ nằm trong các báo cáo giải phẫu bệnh dạng PDF. Có người phải chép dữ liệu vào bảng tính bằng tay.
Chúng tôi đã xây những gì
Chiến lược facade (hay cách không phải thay thế mọi thứ)
Câu đầu tiên ai cũng hỏi: "Các bạn có gỡ bỏ toàn bộ hệ thống cũ không?"
Không. Tuyệt đối không. Làm vậy sẽ tốn hàng chục triệu đô la và mất nhiều năm.
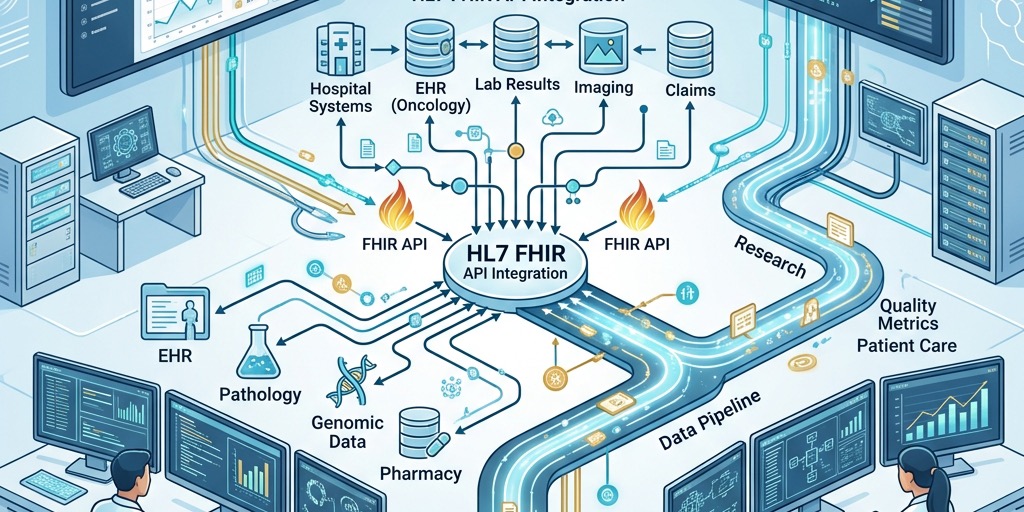
Thay vào đó, chúng tôi xây một FHIR facade. Có thể hình dung nó là một lớp phiên dịch đặt trên các cơ sở dữ liệu cũ. Hệ thống cũ vẫn nằm nguyên chỗ cũ, nhưng khi có ai gọi một API hiện đại (như GET /Patient/12345), facade sẽ chuyển lệnh gọi đó thành câu truy vấn SQL hay tra cứu HL7 khó hiểu mà hệ thống cũ cần.
Cách này chạy tốt với dữ liệu đơn giản. Còn dữ liệu ung bướu phức tạp thì sao? Chúng tôi cần một thứ nặng hơn.
Pipeline ung bướu (nơi mọi thứ trở nên phức tạp)
Báo cáo giải phẫu bệnh đến dưới dạng PDF, tệp XML, đôi khi cả ảnh scan. Chúng tôi xây một pipeline:
- Tiếp nhận – Báo cáo chạy qua các luồng Kafka
- Phân tích cú pháp – Dịch vụ ETL tách nội dung từ PDF và XML
- Ánh xạ FHIR – Chuyển sang các resource FHIR chuẩn (Patient, Observation, Specimen)
- Ẩn danh hóa – Xóa thông tin định danh cá nhân trước khi nhóm nghiên cứu truy cập
Liệt kê ra nghe gọn gàng. Thực tế thì sao? Chúng tôi mất ba tháng chỉ để tìm cách trích xuất ổn định kích thước khối u từ PDF, vì mỗi bác sĩ giải phẫu bệnh trình bày báo cáo một kiểu.
Bài toán định danh
Trước khi chia sẻ bất kỳ dữ liệu lâm sàng nào, chúng tôi phải giải bài toán "người này là ai?".
Bệnh viện A biết "Martha J. Jones" (ID: 111). Bộ phận công tác xã hội biết "Martha Jones" (ID: 999). Trung tâm ung bướu biết "M. Jones" (ID: ABC-7734).
Chúng tôi triển khai một Master Patient Index dựa trên resource Patient của FHIR và thao tác $match. Giờ khi truy vấn một bệnh nhân, hệ thống tìm ra "hồ sơ chuẩn" (golden record) và liên kết cả ba danh tính.
Lần đầu chạy trên dữ liệu production, chúng tôi tìm thấy khoảng 8.000 hồ sơ bệnh nhân trùng lặp. Có người mang đến bốn ID khác nhau trong mạng lưới.
Nơi chúng tôi thực sự đổi mới: tích hợp chăm sóc xã hội
Đây là phần khó nhất và thành thật mà nói, cũng là phần tôi tự hào nhất.
Hệ thống bệnh viện dùng các mã y khoa chuẩn như SNOMED-CT và LOINC. Còn hồ sơ chăm sóc xã hội? Là ghi chú văn bản tự do, kiểu "Bệnh nhân đi lại khó khăn" hoặc "Cần giúp đỡ khi đi chợ".
Chúng tôi dùng các resource CarePlan và Consent của FHIR theo cách tôi chưa thấy ở nơi nào khác:
CarePlan: Kế hoạch hỗ trợ của nhân viên xã hội hiển thị thẳng trên màn hình của điều dưỡng làm thủ tục xuất viện. Không phải tệp PDF đính kèm mà là dữ liệu có cấu trúc, dùng được ngay.
Consent: Phần này rất quan trọng. Chúng tôi xây cơ chế quản lý sự đồng ý chi tiết, để bệnh nhân có thể cho phép chia sẻ tình trạng nhiễm HIV với bệnh viện nhưng không chia sẻ với quản lý viện dưỡng lão.
Với bài toán văn bản tự do, chúng tôi cho toàn bộ chạy qua một engine NLP để ánh xạ "đi lại khó khăn" sang mã SNOMED đúng cho tình trạng suy giảm vận động. Từ đó, khi bác sĩ tìm các vấn đề về vận động, hồ sơ chăm sóc xã hội cũng hiện ra, dù ban đầu chỉ là văn bản thô.
Bảo mật (hay cách chúng tôi tránh được một thảm họa lộ dữ liệu)
Mở API giữa các tổ chức khiến những người làm bảo mật lo lắng. Họ lo là có lý.
Chúng tôi dùng SMART on FHIR, về cơ bản là giao việc ủy quyền cho OAuth 2.0. Trong thực tế nó chạy như sau:
Bác sĩ bấm "Xem hồ sơ cộng đồng" trong hệ thống Epic của họ. Thao tác đó mở ứng dụng của chúng tôi trong một iframe, kèm theo ngữ cảnh (người dùng nào, bệnh nhân nào). Máy chủ ủy quyền của chúng tôi kiểm tra thông tin đăng nhập và quyền hạn. Nếu hợp lệ, họ nhận một access token giới hạn đúng phạm vi cần dùng, chẳng hạn chỉ đọc Observation và không gì khác.
Chúng tôi từng suýt gặp sự cố khi kiểm thử, vì token của một người không hết hạn đúng. Lỗi đó được sửa rất nhanh.
Điều gì đã thay đổi
Từ khi FHIR facade lên sóng vào giữa năm 2024:
Số xét nghiệm lặp giảm 30% vì bác sĩ cấp cứu cuối cùng cũng xem được kết quả gần đây từ các trung tâm chuyên khoa. Đó là tiền thật và sự dễ chịu thật cho bệnh nhân. Không ai muốn bị chích kim hai lần.
Lập kế hoạch xuất viện giảm từ bốn ngày xuống một ngày rưỡi. Hóa ra khi nhóm xuất viện của bệnh viện xem được ngay kế hoạch chăm sóc xã hội, họ không còn phải gọi điện qua lại suốt ba ngày.
Sai sót thuốc giảm 18%. Chúng tôi gộp đơn thuốc của bệnh viện và dữ liệu cấp phát của nhà thuốc cộng đồng vào một góc nhìn MedicationStatement duy nhất.
Nhóm nghiên cứu rút thời gian lập nhóm đối tượng (cohort) từ bốn tháng xuống hai tuần. Giờ họ thực sự công bố bài báo, thay vì dành hết thời gian vật lộn với dữ liệu.
Những bài học đắt giá
Đừng ánh xạ mọi thứ. Ban đầu chúng tôi cố chuyển từng trường của từng cơ sở dữ liệu cũ sang FHIR. Ba tháng sau, gần như không có tiến triển. Chúng tôi đổi hướng dứt khoát: chỉ ánh xạ những gì quan trọng về lâm sàng cho đúng use case của bạn. Phần còn lại để dành cho v2.
Kiểm tra dữ liệu thật chặt. Lúc đầu, dữ liệu xấu liên tục làm ứng dụng của chúng tôi sập. Chúng tôi áp dụng kiểm tra nghiêm ngặt tại API gateway. Nếu một hệ thống gửi resource Patient không có ngày sinh (bắt buộc trong profile của chúng tôi), chúng tôi từ chối và trả về thông báo lỗi chi tiết. Các hệ thống làm sạch dữ liệu của mình rất nhanh.
Vấn đề văn hóa khó hơn vấn đề kỹ thuật. Nhân viên xã hội không muốn thêm một lần đăng nhập, thêm một hệ thống. Chúng tôi nhúng trình xem FHIR thẳng vào công cụ quản lý ca mà họ đang dùng, bằng iframe. Họ thậm chí không biết mình đang dùng "công nghệ mới". Nó chạy ngay trong giao diện quen thuộc của họ.
Bước tiếp theo
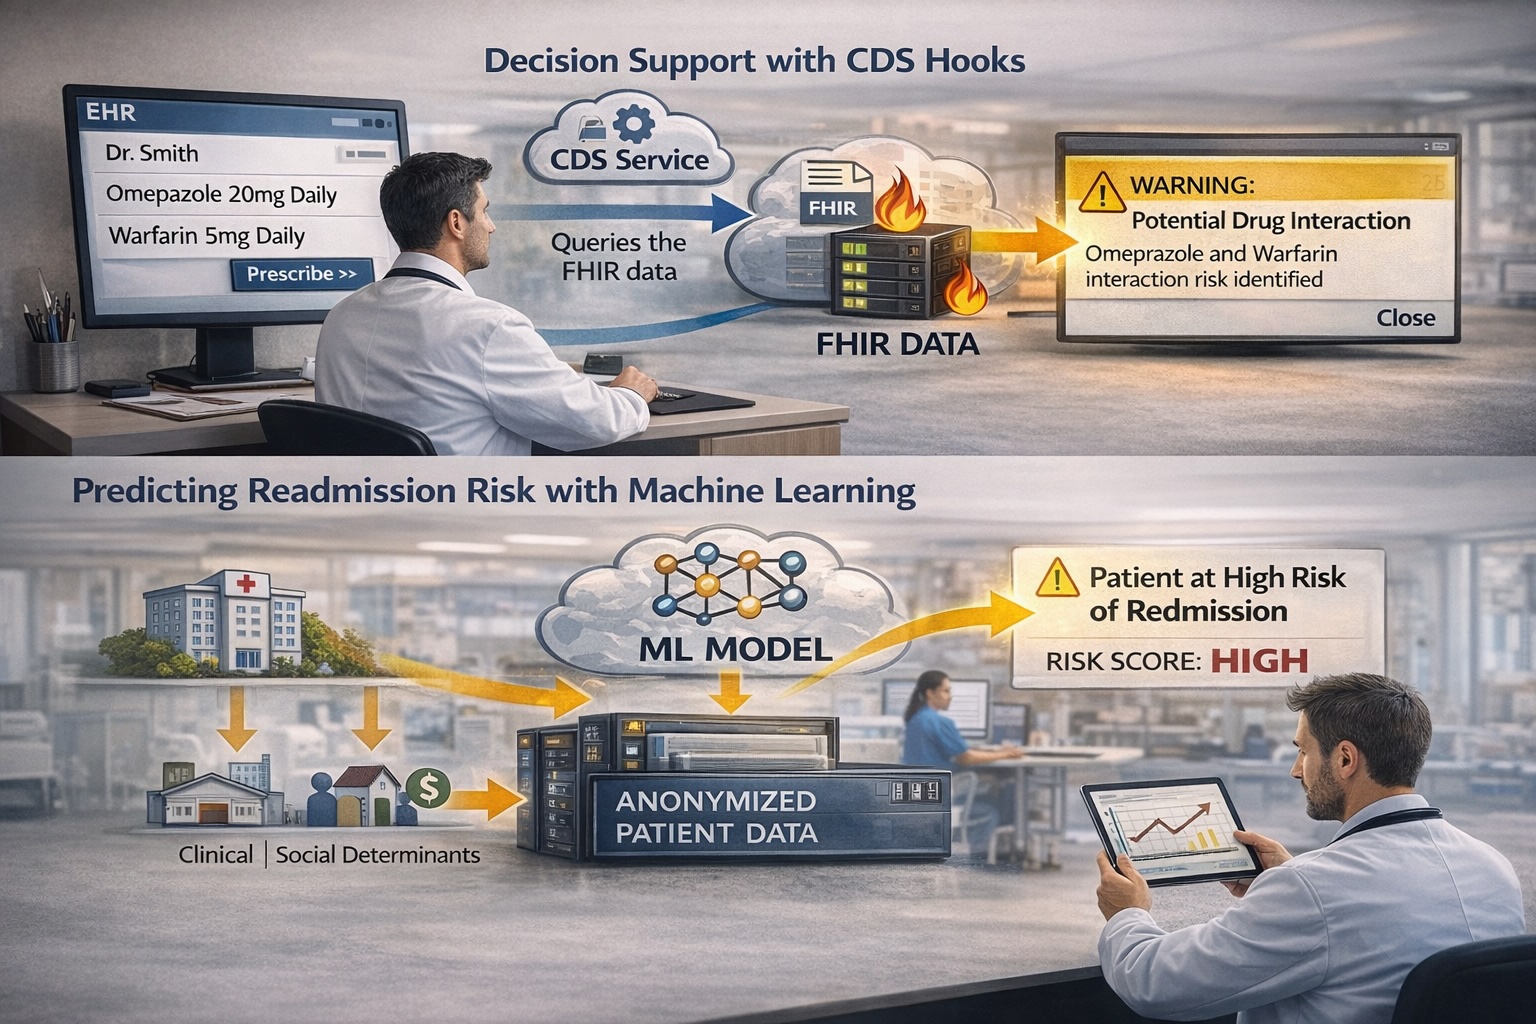
Khi nền tảng đã có, chúng tôi chuyển sang hỗ trợ ra quyết định. Chúng tôi đang triển khai CDS Hooks. Khi bác sĩ kê một loại thuốc, một dịch vụ kiểm tra dữ liệu FHIR để tìm chống chỉ định và có thể hiện cảnh báo ngay lập tức.
Chúng tôi cũng đang huấn luyện các mô hình ML trên dữ liệu đã ẩn danh để dự đoán nguy cơ tái nhập viện, kết hợp dữ liệu lâm sàng và các yếu tố xã hội quyết định sức khỏe. Việc này không thể làm được khi mọi thứ còn bị tách rời.
Nếu bạn đang cân nhắc một dự án như thế này: hãy dự trù nhiều thời gian hơn bạn nghĩ, tranh thủ sự đồng thuận của nhân viên lâm sàng từ sớm, và đừng cố giải quyết mọi vấn đề ngay ở phiên bản 1.
Chúng tôi sẵn lòng trao đổi chi tiết nếu bạn đang gặp thách thức tương tự. Những sai lầm chúng tôi đã mắc, bạn không cần lặp lại.
Muốn trao đổi về thách thức liên thông dữ liệu của bạn? Hãy liên hệ với chúng tôi.