

La crise des silos de données
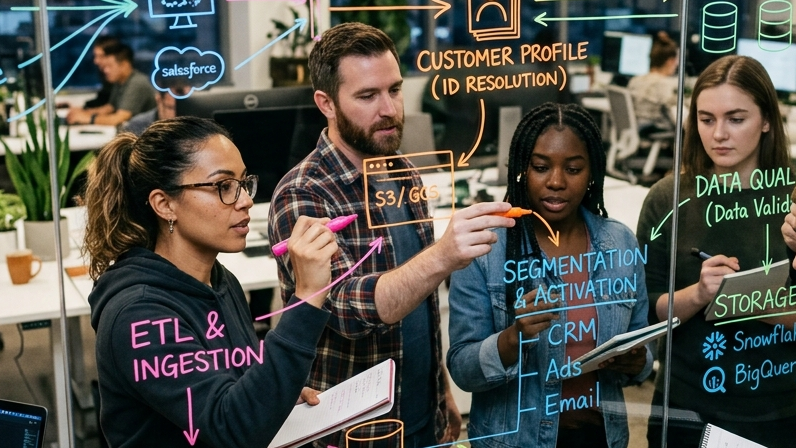
Une entreprise moyenne utilise en même temps des dizaines d’outils marketing. Ce chiffre paraît absurde jusqu’à ce qu’on les énumère : plateforme d’e-mailing, fournisseur de SMS, gestionnaire de publicités sur les réseaux sociaux, DSP de publicité display, analytique web, CRM, plateforme e-commerce, base du programme de fidélité, système de tickets du support client, et une autre douzaine d’outils spécialisés par-dessus. Chacun collecte des données de comportement. Presque aucun ne dialogue avec les autres en temps réel.
Il en résulte une vision fragmentée du client, qui produit des situations franchement embarrassantes. Un client qui a acheté un produit hier est reciblé aujourd’hui par des publicités pour ce même produit. Un acheteur régulier à forte valeur appelle le support, et le conseiller n’a aucune visibilité sur son historique d’achats récent. Un abonné qui s’est désinscrit des e-mails marketing continue d’en recevoir, parce que sa désinscription a été enregistrée dans la plateforme d’e-mailing sans jamais être transmise à l’outil de SMS. Ce ne sont pas des cas limites. Ce sont des situations courantes, qui érodent à la fois la confiance des clients et le ROI du marketing.
Pour les CMO, ce n’est pas un problème de création. C’est un problème d’infrastructure de données. Le résoudre exige une collaboration entre la direction marketing et l’organisation d’ingénierie, à un niveau que la plupart des entreprises n’ont pas encore institutionnalisé.
L’architecture d’une CDP
La Customer Data Platform (CDP) est la réponse d’architecture au problème des silos. À la base, une CDP fait trois choses : elle ingère les données d’événements et d’attributs de chaque point de contact client, elle résout les identités entre ces points de contact (en reliant le cookie d’un visiteur anonyme du site web à une adresse e-mail connue, ou l’identifiant d’un utilisateur d’application mobile à une fiche contact du CRM) et elle maintient pour chaque client un « Golden Record » unifié, accessible en temps réel ou quasi réel à tous les autres outils de la chaîne.
La mise en œuvre technique d’une CDP varie fortement selon l’éditeur et selon la complexité de l’environnement de données de l’organisation. Les grandes plateformes (Segment, Adobe Real-Time CDP, Salesforce Data Cloud et un nombre croissant d’alternatives composables) font chacune des compromis différents entre flexibilité, complexité de mise en œuvre et coût total. Le bon choix dépend de l’infrastructure de données existante, de la sophistication des cas d’usage marketing à couvrir et de la capacité d’ingénierie disponible pour construire et maintenir la couche d’intégration.
Ce qu’elles ont en commun, c’est la couche de résolution d’identité. C’est là que se situe le vrai défi technique. Résoudre l’identité d’un client entre une application mobile, un navigateur web, un système de caisse en magasin et un programme de fidélité tiers exige un appariement déterministe (même adresse e-mail, même numéro de téléphone) combiné à un appariement probabiliste (comportements similaires, même plage d’adresses IP, données de sessions successives). Y parvenir, avec des taux de faux positifs acceptables, n’a rien de trivial et demande un travail d’ingénierie des données rigoureux dès le départ.
L’orchestration omnicanale en pratique
Avec une couche de données unifiée, une véritable orchestration omnicanale devient réalisable. L’illustration classique est le panier abandonné : si un utilisateur ajoute des articles à son panier dans l’application mobile sans finaliser sa commande, la CDP déclenche une notification push. Si cette notification n’est pas ouverte dans un délai défini, elle déclenche deux heures plus tard un e-mail personnalisé. Si l’e-mail est ouvert mais que l’utilisateur n’achète toujours pas, il est ajouté à une audience de reciblage Facebook, avec une variante de visuel adaptée aux articles précis qu’il a consultés.
Ce scénario paraît simple, mais l’exécuter suppose que la CDP dispose de données de session exactes et à jour issues de l’application mobile, d’une intégration bidirectionnelle en temps réel avec le service de notifications push et la plateforme d’e-mailing, et d’une connexion directe à l’API Marketing de Facebook. Chaque intégration a ses caractéristiques de latence et ses modes de défaillance. Construire et maintenir cette infrastructure relève de l’ingénierie, pas des opérations marketing.
Les organisations qui s’y prennent bien ont estompé la frontière entre leurs équipes marketing et d’ingénierie, non pas sur le plan organisationnel, mais dans leur façon de collaborer et dans ce que chacune prend en charge.
La couche IA et ML : de la segmentation à la prédiction
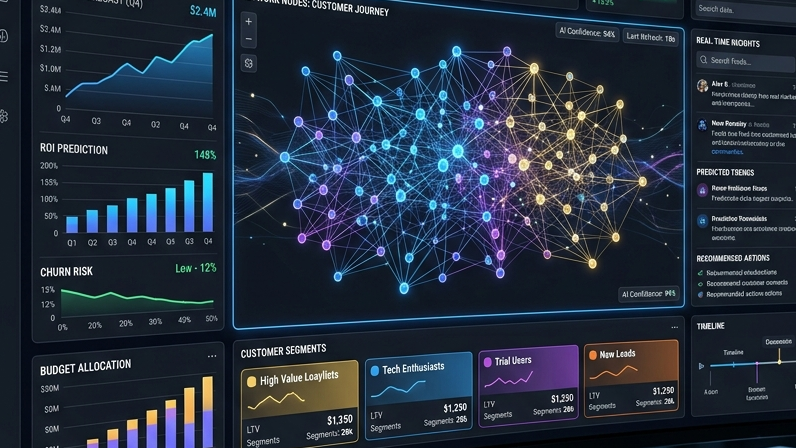
Une CDP unifie les données. La couche d’IA les active. Une fois que vous disposez d’une fiche client propre et unifiée, vous pouvez passer d’une segmentation à base de règles (« envoyer cette offre aux clients qui ont acheté au cours des 30 derniers jours ») à une modélisation prédictive (« identifier les clients susceptibles de partir dans les 14 prochains jours et déclencher une action de rétention avant qu’ils ne le fassent »).
Cette distinction pèse énormément sur le ROI du marketing. La segmentation à base de règles regarde en arrière : elle regroupe les clients selon ce qu’ils ont déjà fait. La modélisation prédictive regarde en avant : elle les regroupe selon ce qu’ils sont susceptibles de faire. L’écart de précision des actions, et donc des taux de conversion et de l’effet sur la rétention, est considérable.
Les modèles de ML qui alimentent cette couche comprennent généralement le scoring de propension à l’attrition, la prédiction de la valeur vie client, la recommandation de la meilleure offre suivante et l’optimisation de l’heure d’envoi. Chaque modèle demande un jeu de données d’entraînement différent, une approche différente de feature engineering et une intégration différente avec la couche d’activation. Construire ces modèles correctement, les tenir à jour à mesure que le comportement des clients évolue et surveiller leur dérive et leurs biais, c’est un travail de data science permanent.
L’IA générative ajoute aussi une dimension nouvelle. Au-delà des modèles prédictifs, les modèles génératifs peuvent produire à grande échelle des textes de messages personnalisés, en adaptant le ton, les références produit et l’appel à l’action au profil de chaque client. Un client qui a l’habitude de réagir aux signaux d’urgence reçoit un e-mail différent de celui qui réagit à la preuve sociale. Le modèle de message est le même ; le contenu est généré individuellement. Les premiers à adopter cette approche font état d’améliorations notables des taux d’ouverture par rapport aux campagnes de segmentation classiques.
Une stratégie de données first-party dans un monde sans cookies
La disparition des cookies tiers, déjà en cours sur les principaux navigateurs (Safari et Firefox en tête, Chrome à leur suite), a fait de la stratégie de données first-party un sujet de conseil d’administration, et non plus seulement une question d’opérations marketing.
Les cookies tiers permettaient aux annonceurs de suivre les utilisateurs d’un site à l’autre sans relation explicite. Ils étaient le socle du reciblage comportemental, du plafonnement de fréquence entre sites et des modèles d’attribution sur lesquels reposait la plupart de la mesure de la publicité numérique. Leur suppression oblige à repenser en profondeur la façon dont les organisations identifient leurs clients, les touchent et mesurent l’impact du marketing sur eux.
La réponse n’est pas simplement « collecter plus de données first-party ». Elle consiste à les collecter dans un cadre auquel les utilisateurs consentent réellement, conforme au GDPR, au CCPA et aux réglementations équivalentes des juridictions concernées, et assez solide pour servir de fondation à l’attribution et à l’activation à mesure que les signaux tiers disparaissent. Cela suppose une CDP conçue dès le départ pour la gestion du consentement, et non ajoutée après coup. Les données de consentement doivent circuler dans les mêmes pipelines que les données de comportement, afin que chaque décision d’activation (chaque e-mail déclenché, chaque pixel de reciblage) soit vérifiée par rapport à l’état actuel du consentement du client avant de s’exécuter.
Les organisations qui ont investi dans cette architecture découvrent que des données first-party conformes ont plus de valeur que les données tierces qu’elles remplacent, car elles sont exactes, consenties et utilisables sans le risque juridique et de réputation que portent désormais les données tierces.
La méthodologie de mise en œuvre de GTEMAS
L’infrastructure de données marketing échoue pour des raisons prévisibles : la couche d’intégration est sous-estimée, la logique de résolution d’identité est trop simplifiée, la gouvernance du consentement et de la qualité des données n’est pas intégrée au pipeline dès le départ, et les équipes marketing et d’ingénierie travaillent sur des calendriers différents avec des définitions différentes de la réussite.
GTEMAS prend en charge l’infrastructure de données marketing dans le cadre d’une mission AI-Native Delivery, menée sur FastDX, notre chaîne de livraison AI-native : des ingénieurs issus du Talent Ecosystem, qui comprennent à la fois l’architecture technique et les cas d’usage marketing, et qui portent la livraison de bout en bout au lieu de combler un manque d’effectifs. Notre méthodologie commence par un audit des données : que possède l’organisation, où se trouve-t-il, quelle en est la qualité, et quels sont les écarts entre l’état actuel et la fiche client unifiée dont l’équipe marketing a besoin ?
À partir de là, nous concevons et construisons l’architecture d’intégration : choix et configuration de la CDP, mise en place du suivi d’événements sur les surfaces web et mobiles, connexion des sources de données CRM et transactionnelles, et mise en œuvre de la logique de résolution d’identité adaptée à l’environnement de données de l’organisation. Nous construisons en parallèle la couche d’activation IA et ML, en priorisant les cas d’usage dont le signal de ROI est le plus clair : en général la prévention de l’attrition et la meilleure offre suivante, car ils produisent des résultats mesurables assez vite pour valider l’investissement avant le prochain cycle budgétaire.
Si votre organisation travaille avec un environnement de données marketing fragmenté et que vous voulez comprendre ce qu’exigerait une architecture unifiée, sur les plans technique, organisationnel et financier, l’équipe GTEMAS sera heureuse d’engager cette conversation.