

Die Krise der Datensilos
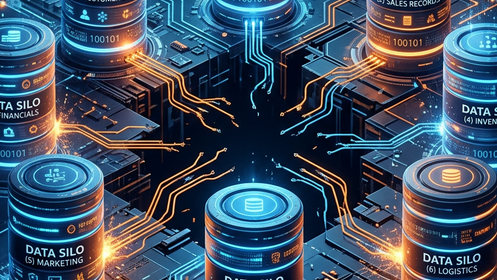
Ein durchschnittliches Unternehmen betreibt Dutzende Marketing-Tools gleichzeitig. Die Zahl klingt absurd, bis man beginnt, sie aufzuzählen: E-Mail-Plattform, SMS-Anbieter, Verwaltung bezahlter Social-Anzeigen, Display-DSP, Web-Analytics, CRM, E-Commerce-Plattform, Datenbank des Treueprogramms, Ticketsystem des Kundensupports und noch ein weiteres Dutzend kategoriespezifischer Tools obendrauf. Jedes erfasst Verhaltensdaten. Fast keines spricht in Echtzeit mit den anderen.
Das Ergebnis ist eine zersplitterte Sicht auf den Kunden, die wirklich peinliche Resultate hervorbringt. Ein Kunde, der gestern ein Produkt gekauft hat, wird heute mit Anzeigen für genau dieses Produkt retargetet. Ein wertvoller Stammkunde ruft beim Support an, und der Mitarbeiter sieht seine jüngsten Käufe nicht. Ein Abonnent, der sich vom E-Mail-Marketing abgemeldet hat, erhält weiter Nachrichten, weil die Abmeldung in der E-Mail-Plattform erfasst, aber nie an das SMS-Tool weitergegeben wurde. Das sind keine Randfälle. Sie sind Routine, und sie untergraben sowohl das Vertrauen der Kunden als auch den Marketing-ROI.
Für CMOs ist das kein kreatives Problem. Es ist ein Problem der Dateninfrastruktur. Und es zu lösen erfordert eine Zusammenarbeit zwischen Marketingleitung und Engineering-Organisation, wie sie die meisten Unternehmen noch nicht fest etabliert haben.
Die Architektur der CDP
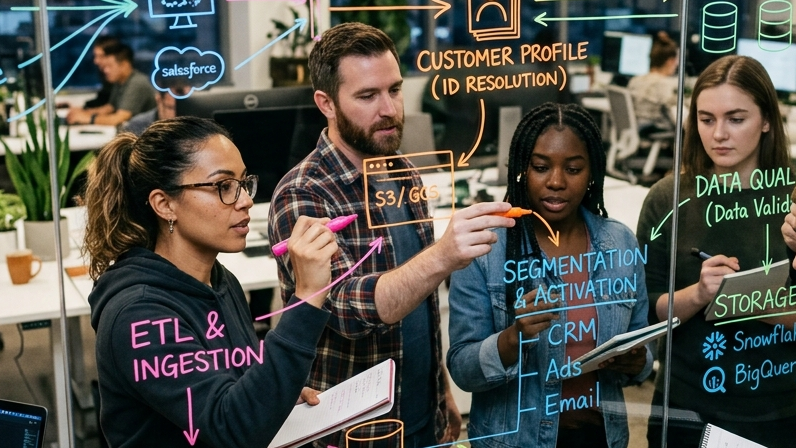
Die Customer Data Platform (CDP) ist die architektonische Antwort auf das Silo-Problem. Im Kern leistet eine CDP drei Dinge: Sie nimmt Ereignis- und Attributdaten von jedem Kundenkontaktpunkt auf, sie löst Identitäten über diese Kontaktpunkte hinweg auf (etwa indem sie das Cookie eines anonymen Website-Besuchers mit einer bekannten E-Mail-Adresse verknüpft oder die Nutzer-ID einer Mobile App mit einem CRM-Kontakt), und sie führt für jeden Kunden einen einheitlichen „Golden Record“, auf den jedes andere Tool im Stack in Echtzeit oder nahezu in Echtzeit zugreifen kann.
Die technische Umsetzung einer CDP unterscheidet sich deutlich je nach Anbieter und nach Komplexität der Datenlandschaft des Unternehmens. Die großen Plattformen – Segment, Adobe Real-Time CDP, Salesforce Data Cloud und eine wachsende Zahl von Composable-Alternativen – gehen jeweils andere Kompromisse zwischen Flexibilität, Implementierungsaufwand und Gesamtkosten ein. Die richtige Wahl hängt von der vorhandenen Dateninfrastruktur ab, vom Anspruchsniveau der Marketing-Anwendungsfälle, die unterstützt werden sollen, und von der Engineering-Kapazität, die zum Aufbau und Betrieb der Integrationsschicht zur Verfügung steht.
Gemeinsam ist ihnen die Schicht zur Identitätsauflösung. Hier liegt die eigentliche technische Herausforderung. Die Identität eines Kunden über eine Mobile App, einen Webbrowser, ein Kassensystem im Geschäft und ein Treueprogramm eines Drittanbieters aufzulösen, erfordert deterministisches Matching (gleiche E-Mail-Adresse, gleiche Telefonnummer) in Kombination mit probabilistischem Matching (ähnliche Verhaltensmuster, gleicher IP-Adressbereich, aufeinanderfolgende Sitzungsdaten). Das richtig hinzubekommen – mit vertretbaren Raten an falsch positiven Treffern – ist alles andere als trivial und verlangt von Anfang an sorgfältiges Data Engineering.
Omnichannel-Orchestrierung in der Praxis
Mit einer einheitlichen Datenschicht wird echte Omnichannel-Orchestrierung machbar. Das Standardbeispiel ist der abgebrochene Warenkorb: Legt ein Nutzer in der Mobile App Artikel in den Warenkorb und schließt den Kauf nicht ab, löst die CDP eine Push-Benachrichtigung aus. Wird sie innerhalb eines festgelegten Zeitfensters nicht geöffnet, folgt zwei Stunden später eine personalisierte E-Mail. Wird die E-Mail geöffnet, der Nutzer kauft aber trotzdem nicht, kommt er in eine Facebook-Retargeting-Zielgruppe, mit einer Creative-Variante, die auf die konkret angesehenen Artikel zugeschnitten ist.
Dieser Ablauf klingt einfach, doch seine Umsetzung verlangt, dass die CDP über genaue, aktuelle Sitzungsdaten aus der Mobile App verfügt, über eine bidirektionale Echtzeit-Integration mit dem Push-Dienst und der E-Mail-Plattform sowie über eine Live-Verbindung zur Marketing-API von Facebook. Jede Integration hat eigene Latenzeigenschaften und Fehlerbilder. Diese Infrastruktur aufzubauen und zu betreiben, ist Engineering-Arbeit, keine Arbeit der Marketing-Operations.
Die Organisationen, die das gut umsetzen, haben die Grenze zwischen Marketing- und Engineering-Team aufgeweicht – nicht organisatorisch, sondern in der Art, wie sie zusammenarbeiten und was jedes Team verantwortet.
Die KI- und ML-Schicht: von der Segmentierung zur Vorhersage
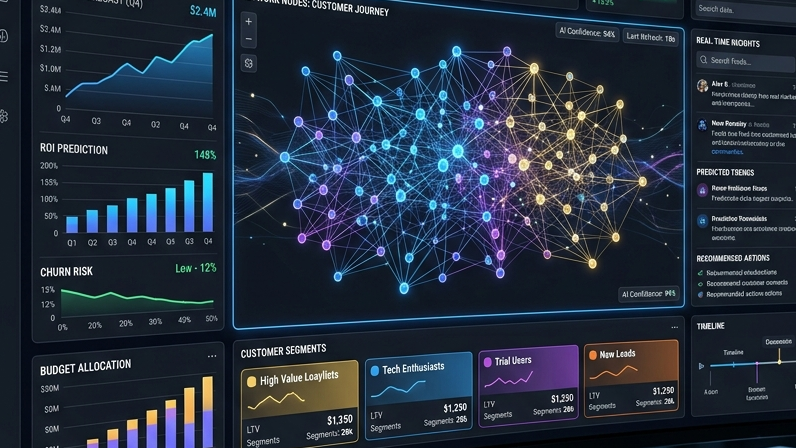
Eine CDP vereinheitlicht Daten. Die KI-Schicht macht sie nutzbar. Sobald ein sauberer, einheitlicher Kundendatensatz vorliegt, lässt sich von regelbasierter Segmentierung („schicke dieses Angebot an Kunden, die in den letzten 30 Tagen gekauft haben“) zu prädiktiver Modellierung übergehen („erkenne Kunden, die in den nächsten 14 Tagen voraussichtlich abwandern, und löse eine Bindungsmaßnahme aus, bevor sie es tun“).
Diese Unterscheidung ist für den Marketing-ROI enorm wichtig. Regelbasierte Segmentierung blickt zurück: Sie gruppiert Kunden nach dem, was sie bereits getan haben. Prädiktive Modellierung blickt nach vorn: Sie gruppiert Kunden nach dem, was sie voraussichtlich tun werden. Der Unterschied in der Treffgenauigkeit der Maßnahmen – und damit bei Konversionsraten und Wirkung auf die Kundenbindung – ist erheblich.
Zu den ML-Modellen, die diese Schicht tragen, gehören typischerweise Scoring der Abwanderungsneigung, Vorhersage des Customer Lifetime Value, Empfehlung des nächstbesten Angebots und Optimierung des Versandzeitpunkts. Jedes Modell braucht einen anderen Trainingsdatensatz, einen anderen Ansatz beim Feature Engineering und eine andere Anbindung an die Aktivierungsschicht. Diese Modelle korrekt zu bauen, sie bei sich änderndem Kundenverhalten aktuell zu halten und auf Drift und Verzerrungen (Bias) zu überwachen, ist laufende Data-Science-Arbeit.
Generative KI fügt hier eine weitere Dimension hinzu. Über prädiktive Modelle hinaus können generative Modelle personalisierte Nachrichtentexte in großem Maßstab erzeugen – und Tonfall, konkrete Produktbezüge und Handlungsaufforderung auf das Profil des einzelnen Kunden zuschneiden. Ein Kunde, der bisher auf Dringlichkeit reagiert hat, erhält eine andere E-Mail als einer, der auf Social Proof reagiert. Die Vorlage ist dieselbe, der Inhalt wird individuell erzeugt. Frühe Anwender dieses Ansatzes berichten von spürbar besseren Öffnungsraten im Vergleich zu klassischen, segmentbasierten Kampagnen.
First-Party-Daten-Strategie in der Post-Cookie-Welt
Das Auslaufen von Drittanbieter-Cookies – bereits im Gange in den großen Browsern, mit Safari und Firefox vorneweg und Chrome im Anschluss – hat die First-Party-Daten-Strategie zu einem Thema auf Vorstandsebene gemacht und nicht nur zu einer Frage der Marketing-Operations.
Drittanbieter-Cookies erlaubten es Werbetreibenden, Nutzer websiteübergreifend ohne ausdrückliche Beziehung zu verfolgen. Sie waren das Rückgrat des verhaltensbasierten Retargetings, der websiteübergreifenden Frequenzbegrenzung und der Attributionsmodelle, auf denen der Großteil der Messung digitaler Werbung beruhte. Ihr Wegfall zwingt dazu, grundlegend neu zu denken, wie Organisationen ihre Kunden identifizieren, erreichen und die Wirkung von Marketing messen.
Die Antwort lautet nicht einfach „mehr First-Party-Daten sammeln“. Die Antwort ist, First-Party-Daten in einem Rahmen zu erheben, dem Nutzer tatsächlich zustimmen, der die DSGVO, den CCPA und entsprechende Vorschriften in den relevanten Rechtsordnungen einhält und der belastbar genug ist, um als Grundlage für Attribution und Aktivierung zu dienen, wenn Drittanbieter-Signale verschwinden. Das verlangt eine CDP, die von Anfang an für das Consent Management ausgelegt ist und nicht erst nachträglich damit ergänzt wird. Einwilligungsdaten müssen durch dieselben Pipelines fließen wie Verhaltensdaten, sodass jede Aktivierungsentscheidung – jede ausgelöste E-Mail, jeder Retargeting-Pixel – gegen den aktuellen Einwilligungsstatus des Kunden geprüft wird, bevor sie ausgelöst wird.
Organisationen, die in diese Architektur investiert haben, stellen fest, dass rechtskonforme First-Party-Daten mehr wert sind als die Drittanbieter-Daten, die sie ersetzen – weil sie genau sind, mit Einwilligung erhoben wurden und sich ohne das rechtliche und rufschädigende Risiko nutzen lassen, das Drittanbieter-Daten inzwischen mit sich bringen.
Die Implementierungsmethodik von GTEMAS
Marketing-Dateninfrastruktur scheitert aus vorhersehbaren Gründen: Die Integrationsschicht wird unterschätzt, die Logik der Identitätsauflösung zu stark vereinfacht, die Governance für Einwilligung und Datenqualität nicht von Anfang an in die Pipeline eingebaut, und Marketing- und Engineering-Team arbeiten mit unterschiedlichen Zeitplänen und unterschiedlichen Vorstellungen von Erfolg.
GTEMAS übernimmt Marketing-Dateninfrastruktur als AI-Native Delivery, betrieben auf FastDX, unserer AI-nativen Delivery-Pipeline – mit Engineers aus dem Talent Ecosystem, die sowohl die technische Architektur als auch die Marketing-Anwendungsfälle verstehen und die Lieferung durchgängig verantworten, statt nur eine Personallücke zu füllen. Unsere Methodik beginnt mit einem Daten-Audit: Was hat die Organisation, wo liegt es, wie ist die Qualität, und wo klaffen Lücken zwischen dem Ist-Zustand und dem einheitlichen Kundendatensatz, den das Marketing braucht?
Darauf aufbauend entwerfen und bauen wir die Integrationsarchitektur – wir wählen die CDP aus und konfigurieren sie, bauen die Event-Tracking-Instrumentierung über Web- und Mobile-Oberflächen, binden CRM- und Transaktionsdatenquellen an und setzen die zur Datenlandschaft der Organisation passende Logik zur Identitätsauflösung um. Die KI- und ML-Aktivierungsschicht bauen wir parallel auf und priorisieren die Anwendungsfälle mit dem klarsten ROI-Signal: in der Regel Abwanderungsprävention und nächstbestes Angebot, weil sie messbare Ergebnisse so schnell liefern, dass sich die Investition vor dem nächsten Budgetzyklus bestätigen lässt.
Wenn Ihre Organisation mit einer zersplitterten Marketing-Datenlandschaft arbeitet und Sie wissen möchten, was eine einheitliche Architektur technisch, organisatorisch und finanziell erfordern würde, beginnt das GTEMAS-Team dieses Gespräch gern mit Ihnen.