

数据孤岛危机
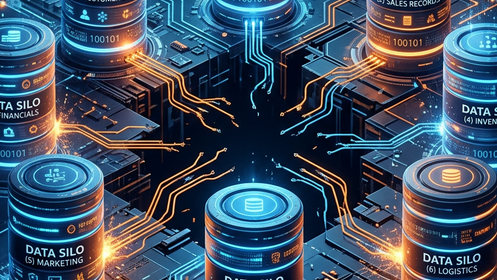
一家普通企业会同时运行几十个营销工具。这个数字在您真正开始列举之前听起来很荒谬:邮件平台、短信服务商、付费社交广告管理工具、展示广告 DSP、网站分析、CRM、电商平台、会员忠诚度计划数据库、客服工单系统,再加上叠在上面的另外十几个细分类别工具。每一个都在采集行为数据,却几乎没有哪两个能实时互通。
结果是对客户的认知支离破碎,由此产生的后果实在令人尴尬。昨天刚买过某款产品的客户,今天又收到这款产品的再营销广告。一位高价值的回头客致电客服,坐席却看不到他最近的购买记录。一位已退订邮件营销的订阅者仍在收到邮件,因为退订只记录在邮件平台里,从未同步到短信工具。这些都不是个别情况,而是常态,它们既损害客户信任,也拉低营销 ROI。
对 CMO 来说,这不是创意问题,而是数据基础设施问题。要解决它,营销管理层和工程组织需要密切协作,而这种协作的程度,多数公司尚未形成制度。
CDP 的架构
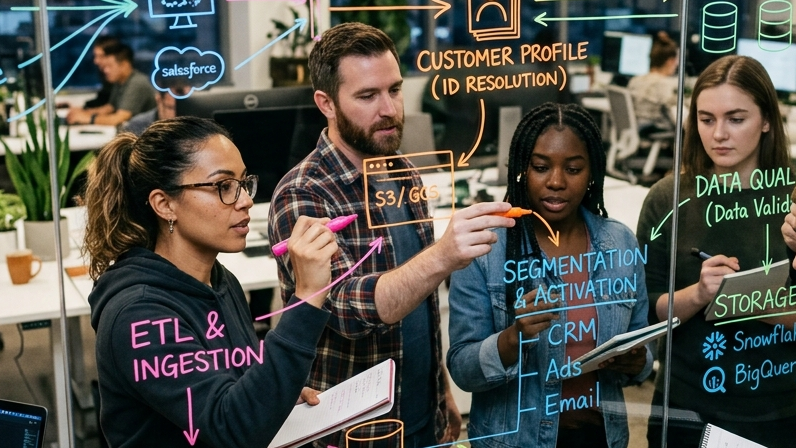
客户数据平台(CDP)是解决孤岛问题的架构方案。CDP 的核心做三件事:从每个客户触点摄取事件和属性数据;跨触点解析身份(把匿名网站访客的 Cookie 关联到已知的电子邮箱,把移动应用用户 ID 关联到 CRM 联系人记录);并为每位客户维护一份统一的“Golden Record”,让技术栈中的其他所有工具都能实时或近实时地访问。
CDP 的技术实现因供应商和企业数据环境的复杂程度而差异很大。主要的平台,包括 Segment、Adobe Real-Time CDP、Salesforce Data Cloud,以及越来越多的可组合替代方案,在灵活性、实施复杂度和总体成本之间各有取舍。合适的选择取决于企业现有的数据基础设施、需要支持的营销用例的复杂程度,以及可用于搭建和维护集成层的工程能力。
它们的共同点是身份解析层,真正的技术挑战就在这里。要在移动应用、网页浏览器、门店 POS 系统和第三方会员计划之间解析同一位客户的身份,需要把确定性匹配(相同的电子邮箱、相同的电话号码)与概率性匹配(相似的行为模式、相同的 IP 地址段、连续的会话数据)结合起来。要把这件事做好,并把误判率控制在可接受的范围内,并不容易,从一开始就需要认真的数据工程。
全渠道编排的实践
有了统一的数据层,真正的全渠道编排才可能实现。最常见的例子是购物车放弃:如果用户在移动应用里把商品加入购物车却没有结账,CDP 会触发一条推送通知。如果通知在设定的时间窗口内没有被打开,两小时后会触发一封个性化邮件。如果邮件被打开了,用户仍然没有购买,就会被加入 Facebook 再营销受众,并展示针对其浏览过的具体商品定制的创意版本。
这个流程听起来很简单,但要执行它,CDP 必须有来自移动应用的准确、最新的会话数据,与推送通知服务和邮件平台实时双向集成,并与 Facebook 的 Marketing API 保持实时连接。每个集成都有各自的延迟特性和故障模式。搭建和维护这套基础设施是工程工作,不是营销运营工作。
执行得好的企业,已经模糊了营销团队与工程团队之间的界限,不是在组织架构上,而是在协作方式和各自负责的内容上。
AI 与 ML 层:从分群到预测
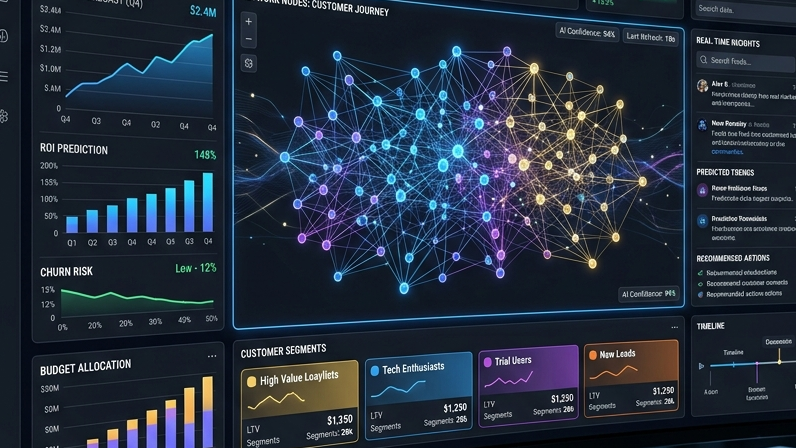
CDP 统一数据,AI 层则把数据用起来。有了干净、统一的客户记录,您就可以从基于规则的分群(“向过去 30 天内购买过的客户发送这个优惠”)转向预测建模(“识别未来 14 天内可能流失的客户,并在他们流失之前启动挽留措施”)。
这个区别对营销 ROI 影响极大。基于规则的分群是向后看的:按客户已经做过的事来分组。预测建模是向前看的:按客户可能会做的事来分组。两者在干预精准度上的差异,以及由此带来的转化率和留存效果的差异,相当可观。
支撑这一层的 ML 模型通常包括流失倾向评分、生命周期价值预测、下一个最佳优惠推荐和发送时间优化。每个模型需要不同的训练数据集、不同的特征工程方法,以及与激活层不同的集成方式。把这些模型建对,随着客户行为的演变保持更新,并监控其漂移和偏差,是持续不断的数据科学工作。
生成式 AI 也在这里增添了新的维度。除了预测模型,生成式模型还能规模化地产出个性化的消息文案,根据个别客户的画像调整语气、具体的产品内容和行动号召。习惯对紧迫感提示做出反应的客户,与对社会认同做出反应的客户,收到的邮件不同。模板是同一个,内容则是逐个生成的。采用这种做法的先行者报告称,与传统的基于分群的营销活动相比,打开率有明显提升。
后 Cookie 时代的第一方数据策略
第三方 Cookie 的淘汰已在主流浏览器中展开,Safari 和 Firefox 在前,Chrome 随后。这让第一方数据策略成为董事会层面关注的问题,而不再只是营销运营的问题。
第三方 Cookie 让广告主无需与用户建立明确关系,就能跨网站追踪用户。它们是行为再营销、跨站频次控制以及支撑大多数数字广告效果衡量的归因模型的基础。它们的消失,迫使企业从根本上重新思考如何识别客户、触达客户,以及衡量营销对客户的影响。
答案并不只是“多收集第一方数据”。答案是在一个框架内收集第一方数据:用户确实同意,符合 GDPR、CCPA 及相关司法辖区的同等法规,并且足够稳固,在第三方信号消失后仍可作为归因和激活的基础。这要求 CDP 从一开始就按同意管理来设计,而不是事后附加。同意数据需要和行为数据走同样的流水线,确保每一个激活决策,每一封触发的邮件、每一个再营销像素,在触发之前都对照客户当前的同意状态进行检查。
已在这种架构上投入的企业发现,合规的第一方数据比它所取代的第三方数据更有价值,因为它准确、经同意,而且使用时没有第三方数据现在带来的法律和声誉风险。
GTEMAS 的实施方法
营销数据基础设施的失败原因往往是可预见的:低估了集成层的工作量,把身份解析的逻辑过度简化,没有从一开始就把同意与数据质量的治理做进流水线,营销团队与工程团队的时间线不同、对成功的定义也不同。
GTEMAS 以 AI-Native Delivery 的方式承接营销数据基础设施项目,基于我们的 AI-native 交付流水线 FastDX 运行,由来自 Talent Ecosystem 的工程师负责,他们既懂技术架构,也懂营销用例,端到端负责交付,而不是填补人头缺口。我们的方法从数据审计开始:企业有什么、数据在哪里、质量如何,以及现状与营销团队所需的统一客户记录之间有哪些差距?
在此基础上,我们设计并搭建集成架构:选型并配置 CDP,在网页和移动端搭建事件追踪埋点,连接 CRM 和交易数据源,并实施适合企业数据环境的身份解析逻辑。我们同步搭建 AI 与 ML 激活层,优先处理投资回报信号最明确的用例,通常是流失预防和下一个最佳优惠,因为它们能较快产生可衡量的结果,在下一个预算周期之前验证这笔投入。
如果您的企业正面对割裂的营销数据环境,想了解统一架构在技术、组织和财务上需要什么,GTEMAS 团队乐意与您开始这场对话。