

La crisis de los silos de datos
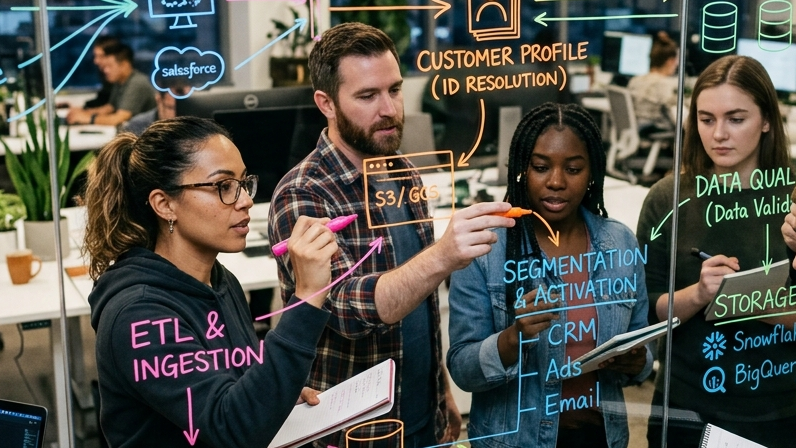
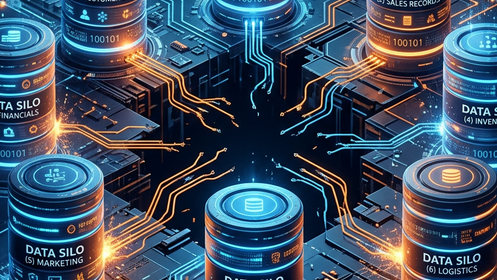
La empresa promedio usa a la vez decenas de herramientas de marketing. La cifra parece absurda hasta que uno empieza a enumerarlas: plataforma de correo, proveedor de SMS, administrador de anuncios de pago en redes sociales, DSP de publicidad display, analítica web, CRM, plataforma de comercio electrónico, base de datos del programa de lealtad, sistema de tickets de atención al cliente y una docena más de herramientas específicas de cada categoría encima. Cada una captura datos de comportamiento. Casi ninguna se comunica con las demás en tiempo real.
El resultado es una visión fragmentada del cliente que produce situaciones realmente vergonzosas. Un cliente que compró un producto ayer recibe hoy anuncios de retargeting de ese mismo producto. Un comprador recurrente de alto valor llama a soporte y el agente no ve su historial reciente de compras. Un suscriptor que canceló el marketing por correo sigue recibiendo mensajes, porque la baja quedó registrada en la plataforma de correo pero nunca llegó a la herramienta de SMS. No son casos aislados. Son rutina, y erosionan tanto la confianza del cliente como el ROI del marketing.
Para los CMO, esto no es un problema creativo. Es un problema de infraestructura de datos. Y resolverlo exige una colaboración entre la dirección de marketing y la organización de ingeniería a un nivel que la mayoría de las empresas aún no ha institucionalizado.
La arquitectura de la CDP
La Customer Data Platform (CDP) es la solución arquitectónica al problema de los silos. En esencia, una CDP hace tres cosas: ingiere datos de eventos y atributos de cada punto de contacto con el cliente, resuelve identidades entre esos puntos de contacto (vincula la cookie de un visitante anónimo del sitio web con una dirección de correo conocida, y el ID de usuario de una aplicación móvil con el registro de contacto del CRM) y mantiene un "Golden Record" unificado de cada cliente, accesible en tiempo real o casi real para el resto de las herramientas del stack.
La implementación técnica de una CDP varía mucho según el proveedor y la complejidad del entorno de datos de la organización. Las plataformas principales (Segment, Adobe Real-Time CDP, Salesforce Data Cloud y un número creciente de alternativas composables) plantean compensaciones distintas entre flexibilidad, complejidad de implementación y costo total. La elección correcta depende de la infraestructura de datos existente, de la sofisticación de los casos de uso de marketing que debe respaldar y de la capacidad de ingeniería disponible para construir y mantener la capa de integración.
Lo que todas tienen en común es la capa de resolución de identidades. Ahí está el verdadero reto técnico. Resolver la identidad de un cliente entre una aplicación móvil, un navegador web, un sistema POS en tienda y el programa de lealtad de un tercero requiere una coincidencia determinista (el mismo correo, el mismo teléfono) combinada con una coincidencia probabilística (patrones de comportamiento similares, el mismo rango de direcciones IP, datos de sesiones consecutivas). Hacerlo bien, con tasas aceptables de falsos positivos, no es trivial y exige una ingeniería de datos cuidadosa desde el inicio.
Orquestación omnicanal en la práctica
Con una capa de datos unificada, la orquestación omnicanal de verdad se vuelve alcanzable. El ejemplo clásico es el carrito abandonado: si un usuario agrega productos al carrito en la aplicación móvil y no completa la compra, la CDP dispara una notificación push. Si esa notificación no se abre dentro de un plazo definido, dispara dos horas después un correo personalizado. Si el correo se abre pero el usuario sigue sin comprar, se le suma a una audiencia de retargeting en Facebook, con una variante creativa adaptada a los productos concretos que vio.
Este flujo parece sencillo, pero ejecutarlo exige que la CDP tenga datos de sesión precisos y actualizados de la aplicación móvil, una integración bidireccional en tiempo real con el servicio de notificaciones push y con la plataforma de correo, y una conexión en vivo con la Marketing API de Facebook. Cada integración tiene sus propias características de latencia y sus modos de fallo. Construir y mantener esta infraestructura es trabajo de ingeniería, no de operaciones de marketing.
Las organizaciones que lo ejecutan bien han difuminado la línea entre sus equipos de marketing e ingeniería, no en lo organizativo, sino en cómo colaboran y qué le corresponde a cada uno.
La capa de IA y ML: de la segmentación a la predicción
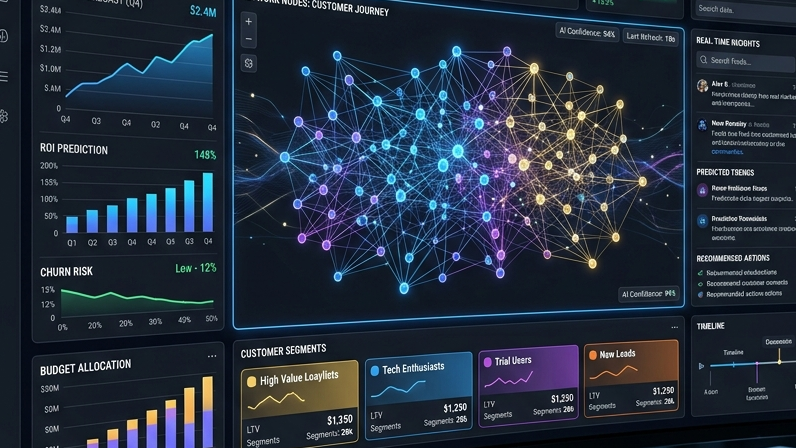
Una CDP unifica los datos. La capa de IA los activa. Con un registro de cliente limpio y unificado, se puede pasar de la segmentación basada en reglas ("enviar esta oferta a los clientes que compraron en los últimos 30 días") al modelado predictivo ("identificar a los clientes con probabilidad de abandonar en los próximos 14 días y activar una acción de retención antes de que lo hagan").
Esta diferencia importa enormemente para el ROI del marketing. La segmentación basada en reglas mira hacia atrás: agrupa a los clientes por lo que ya hicieron. El modelado predictivo mira hacia adelante: los agrupa por lo que probablemente harán. La diferencia en la precisión de las intervenciones, y por tanto en las tasas de conversión y en el impacto sobre la retención, es sustancial.
Los modelos de ML que sostienen esta capa suelen incluir puntuación de propensión al abandono, predicción del valor de vida del cliente, recomendación de la mejor siguiente oferta y optimización del momento de envío. Cada modelo requiere un conjunto de datos de entrenamiento distinto, un enfoque distinto de ingeniería de variables y una integración distinta con la capa de activación. Construir bien estos modelos, mantenerlos actualizados a medida que evoluciona el comportamiento de los clientes y vigilar su deriva y sus sesgos es trabajo continuo de ciencia de datos.
La IA generativa también agrega una dimensión nueva. Más allá de los modelos predictivos, los modelos generativos pueden producir a escala el texto de mensajes personalizados, adaptando el tono, las referencias específicas a productos y la llamada a la acción al perfil de cada cliente. Un cliente con historial de responder a señales de urgencia recibe un correo distinto al de uno que responde a la prueba social. La plantilla es la misma; el contenido se genera de forma individual. Quienes adoptaron este enfoque de forma temprana reportan mejoras significativas en la tasa de apertura frente a las campañas basadas en segmentación tradicional.
Estrategia de datos propios en un mundo sin cookies
La desaparición de las cookies de terceros, que ya está en marcha en los principales navegadores (Safari y Firefox a la cabeza y Chrome detrás), ha convertido la estrategia de datos propios en una preocupación del consejo de administración, y no solo en una cuestión de operaciones de marketing.
Las cookies de terceros permitían a los anunciantes rastrear a los usuarios entre sitios web sin una relación explícita. Eran la base del retargeting conductual, del límite de frecuencia entre sitios y de los modelos de atribución sobre los que se apoyaba la mayor parte de la medición de la publicidad digital. Su eliminación obliga a replantear de raíz cómo las organizaciones identifican a sus clientes, llegan a ellos y miden el impacto del marketing.
La respuesta no es simplemente "recopilar más datos propios". La respuesta es recopilar datos propios dentro de un marco al que los usuarios realmente den su consentimiento, que cumpla con el GDPR, la CCPA y las regulaciones equivalentes de las jurisdicciones relevantes, y que sea lo bastante sólido para servir de base a la atribución y la activación a medida que desaparecen las señales de terceros. Esto exige una CDP diseñada desde el principio para gestionar el consentimiento, y no como un complemento. Los datos de consentimiento deben circular por los mismos pipelines que los datos de comportamiento, de modo que cada decisión de activación (cada correo disparado, cada píxel de retargeting) se contraste con el estado de consentimiento vigente del cliente antes de ejecutarse.
Las organizaciones que han invertido en esta arquitectura descubren que los datos propios que cumplen la normativa valen más que los datos de terceros que reemplazan, porque son precisos, cuentan con consentimiento y se pueden usar sin el riesgo legal y reputacional que hoy conllevan los datos de terceros.
La metodología de implementación de GTEMAS
La infraestructura de datos de marketing falla por razones previsibles: se subestima la capa de integración, se simplifica en exceso la lógica de resolución de identidades, la gobernanza del consentimiento y de la calidad de datos no se incorpora al pipeline desde el inicio, y los equipos de marketing e ingeniería trabajan con plazos distintos y definiciones distintas de éxito.
GTEMAS asume la infraestructura de datos de marketing como un proyecto de AI-Native Delivery, ejecutado sobre FastDX, nuestro pipeline de entrega AI-native: ingenieros del Talent Ecosystem que entienden tanto la arquitectura técnica como los casos de uso de marketing y que se hacen cargo de la entrega de principio a fin, en lugar de cubrir un hueco de personal. Nuestra metodología empieza con una auditoría de datos: qué tiene la organización, dónde está, qué calidad tiene y qué brechas hay entre la situación actual y el registro unificado del cliente que necesita el equipo de marketing.
A partir de ahí, diseñamos y construimos la arquitectura de integración: seleccionamos y configuramos la CDP, construimos la instrumentación de seguimiento de eventos en las superficies web y móviles, conectamos las fuentes de datos del CRM y transaccionales e implementamos la lógica de resolución de identidades adecuada al entorno de datos de la organización. Construimos en paralelo la capa de activación de IA y ML, priorizando los casos de uso con la señal de ROI más clara: normalmente la prevención del abandono y la mejor siguiente oferta, porque producen resultados medibles con la rapidez suficiente para validar la inversión antes del siguiente ciclo presupuestario.
Si su organización trabaja con un entorno de datos de marketing fragmentado y quiere saber qué exigiría una arquitectura unificada (en lo técnico, lo organizativo y lo financiero), el equipo de GTEMAS con gusto inicia esa conversación.