

Les limites du CRM statique
La plupart des organisations utilisent leur CRM comme une archive structurée. Il enregistre ce qui s’est passé : un contact a été créé, une affaire a été conclue, un ticket de support a été résolu. Les données sont exactes, les champs sont renseignés, les rapports tournent à échéance. Et cela ne produit presque aucun avantage concurrentiel, car le CRM de chaque concurrent ressemble au vôtre.
Le problème n’est pas le CRM lui-même. Salesforce, HubSpot et Microsoft Dynamics sont des plateformes capables. Le problème est la couche qui devrait se trouver au-dessus d’eux, celle d’intelligence qui transforme les données historiques en prédictions tournées vers l’avenir, et qui, dans la plupart des organisations, n’existe pas. Le CRM est un rétroviseur. Les relations clients d’aujourd’hui demandent plutôt quelque chose qui ressemble à un système de navigation : savoir en temps réel où se trouve le client, où il est susceptible d’aller et quelle action donnera le meilleur résultat au prochain moment de décision.
Construire ce système de navigation relève autant de l’ingénierie que de la data science. Et la plupart des projets CRM le ratent, non parce que la technologie manque, mais parce que l’architecture n’a pas été conçue pour cela dès le départ.
L’architecture de l’hyperpersonnalisation
Passer d’un CRM statique à un système d’intelligence dynamique oblige à repenser l’architecture sur trois couches distinctes. Chacune a ses propres exigences techniques, ses propres modes de défaillance et ses propres conséquences organisationnelles.
- La couche de données (CDP) : une Customer Data Platform agrège les données de comportement et de transaction de chaque point de contact : visites web, sessions d’application mobile, interactions par e-mail, tickets de support, achats en magasin et flux d’enrichissement de données tierces. La CDP résout l’identité entre ces sources (en reliant la session anonyme d’un site web au contact connu du CRM), maintient un profil client unifié en temps réel et met ce profil à disposition de tous les systèmes en aval via une API cohérente. Sans cette couche, la couche d’intelligence travaille avec des données incomplètes et périmées. La qualité du profil unifié plafonne la qualité de tout ce qui est construit par-dessus.
- La couche d’intelligence (IA/ML) : des modèles de machine learning entraînés sur le profil client unifié produisent des prédictions exploitables : propension à l’attrition, disposition à la montée en gamme, recommandation du meilleur produit suivant, canal de communication préféré et moment d’envoi optimal. Ces modèles exigent un réentraînement continu à mesure que le comportement des clients évolue, une surveillance de la dérive et des biais, et des boucles de retour claires entre résultats prédits et résultats réels, afin que la performance puisse être mesurée et améliorée. Ce n’est pas une configuration à faire une fois. C’est une activité de data science permanente.
- La couche d’activation : l’intelligence n’a de valeur que si elle atteint les personnes et les systèmes capables d’agir. En pratique, cela signifie afficher les prédictions dans l’interface du CRM pour les commerciaux et les conseillers du service client, déclencher des séquences automatisées dans la plateforme d’automatisation marketing, mettre à jour en temps réel les règles de personnalisation du site web et alimenter les moteurs de recommandation des surfaces e-commerce. La couche d’activation doit fonctionner avec une latence inférieure à la seconde pour les cas d’usage en temps réel (un conseiller du service client doit voir le score de risque d’attrition au moment où l’appel est connecté, pas 20 secondes plus tard) et avec une livraison par lots fiable pour les cas d’usage planifiés (mises à jour d’audiences de campagne, rapports hebdomadaires sur la santé des comptes).
Le schéma d’architecture de ce système paraît plus complexe que celui d’un projet CRM classique, et c’est le cas. Mais la complexité se situe en grande partie dans la couche d’infrastructure de données, pas dans le CRM lui-même. Le CRM devient la couche de présentation d’une intelligence produite ailleurs.
L’IA générative dans le CRM : deux applications concrètes
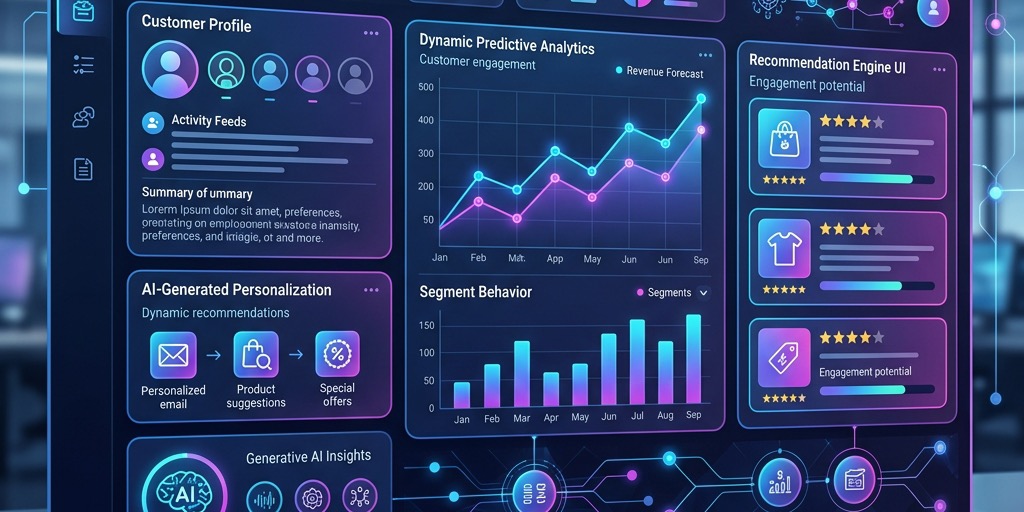
Au-delà des modèles prédictifs, l’IA générative apporte une valeur mesurable dans deux cas d’usage précis du CRM, passés de l’expérimentation à l’exploitation au cours des 18 derniers mois.
Génération de communications personnalisées : au lieu de choisir un modèle de message et de renseigner des champs de fusion, des agents d’IA génèrent de zéro le contenu des e-mails et des messages à partir du profil du client, de ses interactions récentes et du résultat précis que la communication doit obtenir. Un e-mail de rétention destiné à un client à forte valeur et à risque d’attrition n’est pas le même que celui destiné à un client récemment acquis et peu engagé, non seulement dans l’offre, mais aussi dans le ton, l’angle, la longueur et les références produit. À cette échelle, il faut de l’IA générative. Des rédacteurs humains ne peuvent pas produire un contenu individualisé pour 100 000 contacts à chaque cycle de campagne. Les organisations qui adoptent cette approche font état de hausses notables des taux d’ouverture et de conversion par rapport aux approches à base de modèles.
« Dialoguer avec ses données » pour les équipes commerciales : les interfaces d’interrogation en langage naturel permettent aux commerciaux de poser des questions à leurs données CRM sans écrire de SQL ni naviguer dans des interfaces de filtres complexes. « Quels comptes de mon territoire n’ont eu aucune activité depuis 45 jours et ont un renouvellement ouvert dans les 90 prochains jours ? » obtient une réponse immédiate, au lieu d’un exercice de reporting de 20 minutes. Des mises en œuvre plus sophistiquées permettent de poser des questions prédictives : « Parmi mes opportunités ouvertes, laquelle a le plus de chances d’être conclue ce trimestre ? » Le système renvoie non seulement la réponse, mais aussi les éléments qui la fondent : les signaux d’activité, les schémas d’engagement et les comparaisons historiques qui étayent la prédiction.
Construire ou acheter : un cadre de décision
Quand une organisation décide d’investir dans des capacités de CRM dopées à l’IA, la première question est généralement : faut-il acheter une solution d’éditeur (Salesforce Einstein, HubSpot AI, Microsoft Copilot for Sales) ou construire une couche d’intelligence sur mesure ?
La réponse honnête : cela dépend de ce sur quoi vous cherchez à vous différencier.
Les solutions d’IA des éditeurs conviennent pour les capacités communes à tout votre secteur : scoring d’attrition de base, algorithmes de recommandation standard, analyse de sentiment prête à l’emploi pour les tickets de support. Ce sont des problèmes résolus. Payer un éditeur pour les résoudre est généralement moins cher et plus rapide que de partir de zéro, et la charge de maintenance reste chez l’éditeur.
Les couches d’intelligence sur mesure conviennent quand la logique de définition d’un segment de clientèle, de notation d’un compte ou de génération d’une recommandation reflète une connaissance propriétaire de votre marché et de vos clients qu’un modèle générique ne peut pas reproduire. Un cabinet de services financiers qui a mis au point des signaux de risque propriétaires à partir de 15 ans de données de comportement client n’obtiendra pas une précision prédictive équivalente avec un modèle d’éditeur prêt à l’emploi. Une entreprise B2B au cycle de vente très spécifique et à l’univers de comptes potentiels restreint obtiendra une meilleure prédiction de pipeline avec un modèle entraîné sur ses propres données historiques qu’avec un modèle générique entraîné sur l’ensemble des clients de Salesforce.
L’approche pratique est étagée : recourir aux solutions d’éditeurs pour les fonctions banalisées et construire des modèles sur mesure pour les capacités réellement différenciantes. GTEMAS est spécialisé dans la conception et la construction de ces couches d’intelligence sur mesure au-dessus des plateformes CRM existantes : l’architecture qui relie la CDP, les modèles de ML et les systèmes d’activation, sans obliger les organisations à remplacer le CRM qu’elles ont mis des années à configurer.
Mesurer le ROI
Les investissements en hyperpersonnalisation sont souvent justifiés par des affirmations vagues sur l’expérience client. Les directeurs financiers veulent des chiffres. Voici les indicateurs qui bougent réellement quand l’architecture fonctionne :
- Réduction de l’attrition : les organisations qui mettent en place un scoring prédictif de l’attrition et des workflows d’intervention précoce automatisés constatent généralement une baisse de 10–20% de l’attrition volontaire au cours de la première année. Pour une société SaaS B2B de 50 M$ d’ARR avec un taux d’attrition annuel de 15%, une réduction de 15% de l’attrition représente 1,1 M$ de revenus préservés, chaque année et de façon récurrente.
- Revenus d’upsell et de cross-sell : les modèles de meilleure offre suivante, correctement entraînés et activés, produisent des hausses mesurables du revenu d’expansion par compte. Le mécanisme est simple : proposer la bonne offre au bon compte au moment où il est le plus réceptif, plutôt que de lancer des campagnes trimestrielles à toute la base clients sans tenir compte de sa disposition.
- Compression du cycle de vente : la gestion de pipeline priorisée par l’IA réduit le temps que les commerciaux passent sur les opportunités peu probables. Quand un commercial commence sa semaine avec une liste de comptes classés selon des signaux de comportement réels plutôt qu’à l’intuition, son taux de conclusion sur les opportunités travaillées s’améliore.
- Déflexion du support et coût de résolution : un tri assisté par l’IA, qui oriente les tickets selon le parcours de résolution prédit et affiche les articles pertinents de la base de connaissances avant toute escalade humaine, réduit à la fois la durée moyenne de traitement et le taux de déflexion.
La couche d’intelligence sur mesure de GTEMAS
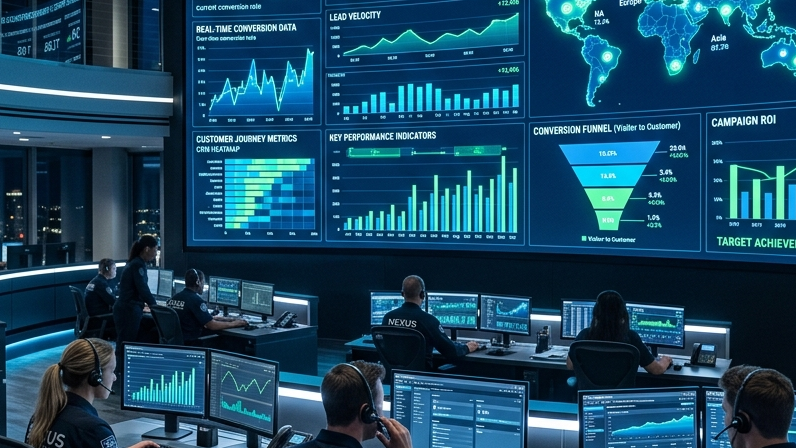
GTEMAS construit l’infrastructure qui se place entre votre CRM existant et les capacités d’IA dont vos équipes en contact avec les clients ont besoin. Il ne s’agit pas de remplacer le CRM, mais de l’augmenter : ajouter le pipeline de données, les modèles de ML et les intégrations d’activation qui transforment votre système d’enregistrement existant en système d’intelligence.
Nos missions commencent généralement par un audit des données et une conception d’architecture : cartographier les sources de données existantes, évaluer leur qualité et concevoir la structure de profil unifié qui alimentera la couche d’intelligence. Ensuite, nous construisons l’infrastructure d’intégration, entraînons les premiers modèles sur les données historiques et déployons des workflows d’activation dans les systèmes que vos équipes utilisent déjà. Les premiers modèles sont en production en 60–90 jours et produisent des prédictions sur des données réelles, pas sur des scénarios de démonstration.
Si vous voulez savoir à quoi ressemblerait une couche d’intelligence sur mesure au-dessus de votre CRM actuel, ce qu’il en coûterait de la construire, quels résultats métier mesurables elle produirait et ce que votre organisation devrait faire pour la maintenir, l’équipe GTEMAS est prête à engager cette conversation.