

Die Grenzen des statischen CRM
Die meisten Organisationen nutzen ihr CRM als strukturiertes Archiv. Es hält fest, was passiert ist: Ein Kontakt wurde angelegt, ein Deal abgeschlossen, ein Support-Ticket gelöst. Die Daten sind korrekt, die Felder gefüllt, die Berichte laufen planmäßig. Und es verschafft kaum einen Wettbewerbsvorteil, weil das CRM jedes Wettbewerbers genauso aussieht.
Das Problem ist nicht das CRM selbst. Salesforce, HubSpot und Microsoft Dynamics sind leistungsfähige Plattformen. Das Problem ist die Schicht, die darüber liegen sollte – die Intelligenzschicht, die historische Datensätze in vorausschauende Prognosen verwandelt –, und bei den meisten Organisationen gibt es diese Schicht nicht. Das CRM ist ein Rückspiegel. Moderne Kundenbeziehungen brauchen eher etwas wie ein Navigationssystem: Echtzeit-Wissen darüber, wo der Kunde steht, wohin er voraussichtlich geht und welche Maßnahme beim nächsten Entscheidungspunkt das beste Ergebnis bringt.
Dieses Navigationssystem zu bauen, ist ein Engineering-Problem ebenso wie ein Data-Science-Problem. Und die meisten CRM-Implementierungen machen es falsch, nicht weil die Technologie fehlt, sondern weil die Architektur von Anfang an nicht dafür ausgelegt war.
Die Architektur der Hyperpersonalisierung
Der Weg vom statischen CRM zum dynamischen Intelligenzsystem verlangt, die Architektur auf drei Schichten neu zu denken. Jede Schicht hat eigene technische Anforderungen, eigene Fehlerbilder und eigene organisatorische Folgen.
- Die Datenschicht (CDP): Eine Customer Data Platform führt Verhaltens- und Transaktionsdaten von jedem Kontaktpunkt zusammen – Website-Besuche, Sitzungen in der Mobile App, E-Mail-Interaktionen, Support-Tickets, Käufe im Geschäft und Feeds zur Datenanreicherung durch Dritte. Die CDP löst Identitäten über diese Quellen hinweg auf (und verbindet die anonyme Website-Sitzung mit dem bekannten CRM-Kontakt), pflegt in Echtzeit ein einheitliches Kundenprofil und stellt dieses Profil über eine einheitliche API jedem nachgelagerten System zur Verfügung. Ohne diese Schicht arbeitet die Intelligenzschicht mit unvollständigen und veralteten Daten. Die Qualität des einheitlichen Profils setzt die Obergrenze für die Qualität von allem, was darauf aufbaut.
- Die Intelligenzschicht (KI/ML): Auf dem einheitlichen Kundenprofil trainierte Machine-Learning-Modelle liefern umsetzbare Prognosen: Abwanderungsneigung, Bereitschaft für Upselling, Empfehlung des nächstbesten Produkts, bevorzugter Kommunikationskanal und optimaler Versandzeitpunkt. Diese Modelle müssen fortlaufend neu trainiert werden, wenn sich das Kundenverhalten ändert, auf Drift und Verzerrungen (Bias) überwacht werden und klare Rückkopplungsschleifen zwischen prognostizierten und tatsächlichen Ergebnissen haben, damit sich die Leistung messen und verbessern lässt. Das ist keine einmalige Konfiguration. Es ist ein laufender Data-Science-Betrieb.
- Die Aktivierungsschicht: Intelligenz ist nur dann wertvoll, wenn sie die Menschen und Systeme erreicht, die danach handeln können. In der Praxis heißt das: Prognosen in der CRM-Oberfläche für Vertriebs- und Servicemitarbeiter anzeigen, automatisierte Abläufe in der Marketing-Automation-Plattform auslösen, die Personalisierungsregeln der Website in Echtzeit aktualisieren und Empfehlungs-Engines in E-Commerce-Oberflächen speisen. Die Aktivierungsschicht muss bei Echtzeit-Anwendungsfällen mit Latenzen im Sekundenbruchteil arbeiten (ein Kundenservice-Mitarbeiter muss den Abwanderungs-Score sehen, wenn das Gespräch verbunden wird, nicht 20 Sekunden später) und bei geplanten Anwendungsfällen (Aktualisierung von Kampagnenzielgruppen, wöchentliche Berichte zur Account-Gesundheit) Daten zuverlässig im Batch ausliefern.
Das Architekturdiagramm dieses Systems sieht komplexer aus als das einer klassischen CRM-Implementierung, weil es das ist. Die Komplexität liegt aber überwiegend in der Dateninfrastruktur und nicht im CRM selbst. Das CRM wird zur Darstellungsschicht für Intelligenz, die anderswo erzeugt wird.
Generative KI im CRM: zwei praktische Anwendungen
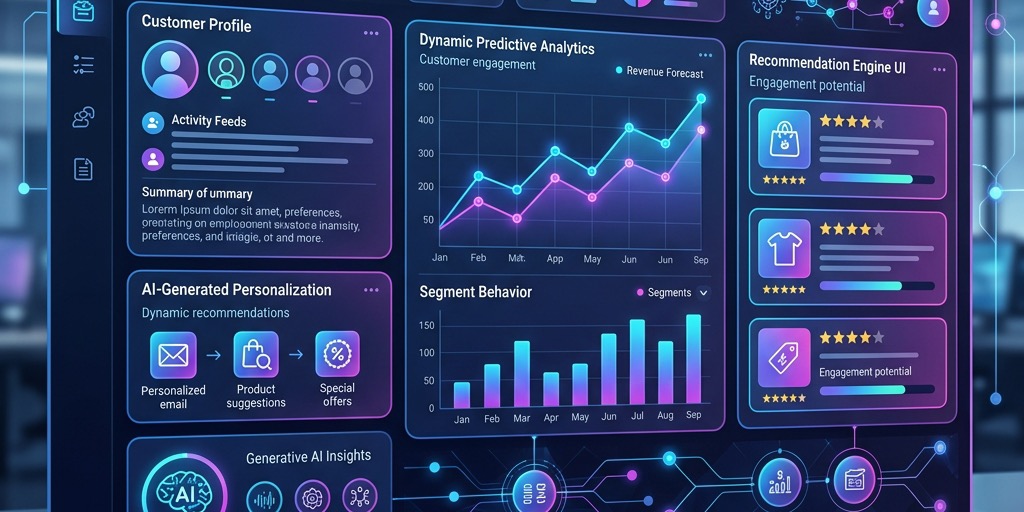
Über prädiktive Modelle hinaus bringt generative KI in zwei konkreten CRM-Anwendungsfällen messbaren Nutzen. Beide sind in den vergangenen 18 Monaten vom Experiment in den Betrieb übergegangen.
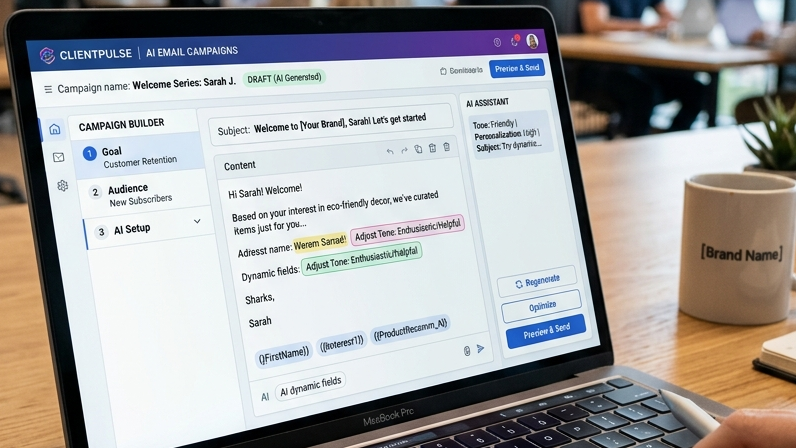
Erzeugung personalisierter Kommunikation: Statt eine Vorlage auszuwählen und Serienbrieffelder zu füllen, erzeugen KI-Agenten E-Mail- und Nachrichteninhalte von Grund auf, auf Basis des Kundenprofils, der jüngsten Interaktionen und des konkreten Ergebnisses, das die Kommunikation bewirken soll. Eine Bindungs-E-Mail für einen wertvollen, abwanderungsgefährdeten Kunden unterscheidet sich von der für einen kürzlich gewonnenen Kunden mit geringer Interaktion – nicht nur im Angebot, sondern in Tonfall, Rahmung, Länge und konkreten Produktbezügen. Im großen Maßstab braucht das generative KI. Menschliche Texter können pro Kampagnenzyklus keine individuellen Inhalte für 100.000 Kontakte erstellen. Organisationen, die diesen Ansatz umsetzen, berichten von spürbar höheren Öffnungs- und Konversionsraten im Vergleich zu vorlagenbasierten Ansätzen.
„Chat mit Ihren Daten“ für Vertriebsteams: Abfrageoberflächen in natürlicher Sprache erlauben es Vertriebsmitarbeitern, Fragen an ihre CRM-Daten zu stellen, ohne SQL zu schreiben oder sich durch komplexe Filteroberflächen zu klicken. „Welche Accounts in meinem Gebiet hatten seit 45 Tagen keine Aktivität und haben in den nächsten 90 eine offene Verlängerung?“ wird zu einer sofortigen Antwort statt zu einer 20-minütigen Auswertung. Ausgereiftere Umsetzungen lassen Mitarbeiter auch prädiktive Fragen stellen: „Welche meiner offenen Opportunities wird in diesem Quartal am wahrscheinlichsten abgeschlossen?“ Das System liefert nicht nur die Antwort, sondern auch die Belege: die Aktivitätssignale, die Interaktionsmuster und die historischen Vergleiche, die die Prognose stützen.
Entscheidungsrahmen: selbst bauen oder kaufen
Wenn eine Organisation in KI-gestützte CRM-Funktionen investieren will, lautet die erste Frage meist: Sollen wir eine Lösung eines Anbieters kaufen (Salesforce Einstein, HubSpot AI, Microsoft Copilot for Sales) oder eine eigene Intelligenzschicht bauen?
Die ehrliche Antwort: Es kommt darauf an, worin Sie sich unterscheiden wollen.
KI-Lösungen von Anbietern eignen sich für Funktionen, die in Ihrer Branche allgemein sind: einfaches Churn-Scoring, Standard-Empfehlungsalgorithmen, Stimmungsanalyse für Support-Tickets in der Standardkonfiguration. Das sind gelöste Probleme. Einen Anbieter dafür zu bezahlen, ist meist günstiger und schneller als ein Neubau, und der Wartungsaufwand bleibt beim Anbieter.
Individuell gebaute Intelligenzschichten eignen sich, wenn die Logik, nach der Sie ein Kundensegment definieren, einen Account bewerten oder eine Empfehlung erzeugen, proprietäres Wissen über Ihren Markt und Ihre Kunden widerspiegelt, das ein generisches Modell nicht nachbilden kann. Ein Finanzdienstleister, der aus 15 Jahren Kundenverhaltensdaten eigene Risikosignale entwickelt hat, erreicht mit einem Standardmodell eines Anbieters nicht dieselbe Vorhersagegenauigkeit. Ein B2B-Unternehmen mit einem sehr spezifischen Vertriebszyklus und einem engen Kreis möglicher Accounts erhält eine bessere Pipeline-Prognose von einem Modell, das auf den eigenen historischen Daten trainiert wurde, als von einem generischen Modell, das über alle Salesforce-Kunden hinweg trainiert wurde.
Der praktische Ansatz ist ein geschichteter: Anbieterlösungen für Standardfunktionen nutzen und eigene Modelle für die Fähigkeiten bauen, die sich wirklich abheben. GTEMAS ist darauf spezialisiert, solche individuellen Intelligenzschichten auf bestehenden CRM-Plattformen zu entwerfen und zu bauen – die Architektur, die CDP, ML-Modelle und Aktivierungssysteme verbindet, ohne dass Organisationen das CRM ersetzen müssen, das sie über Jahre konfiguriert haben.
Den ROI messen
Investitionen in Hyperpersonalisierung werden oft mit vagen Aussagen zur Customer Experience begründet. CFOs wollen Zahlen. Diese Kennzahlen bewegen sich tatsächlich, wenn die Architektur funktioniert:
- Geringere Abwanderungsrate: Organisationen, die prädiktives Churn-Scoring und automatisierte Frühinterventions-Workflows einführen, sehen typischerweise im ersten Jahr 10–20 % weniger freiwillige Abwanderung. Bei einem B2B-SaaS-Unternehmen mit 50 Mio. $ ARR und 15 % jährlicher Abwanderung entsprechen 15 % weniger Abwanderung 1,1 Mio. $ gesichertem Umsatz – jährlich und wiederkehrend.
- Umsatz aus Upselling und Cross-Selling: Modelle für das nächstbeste Angebot liefern, wenn sie richtig trainiert und aktiviert sind, messbar mehr Erweiterungsumsatz pro Account. Der Mechanismus ist einfach: das richtige Angebot dem richtigen Account in dem Moment zeigen, in dem er am ehesten aufnahmebereit ist, statt vierteljährliche Kampagnen an den gesamten Kundenstamm zu schicken, unabhängig von dessen Bereitschaft.
- Kürzerer Vertriebszyklus: Eine KI-priorisierte Pipeline-Steuerung verringert die Zeit, die Vertriebsmitarbeiter auf Opportunities mit geringer Erfolgswahrscheinlichkeit verwenden. Beginnt ein Mitarbeiter seine Woche mit einer Rangliste von Accounts auf Basis tatsächlicher Verhaltenssignale statt nach Bauchgefühl, verbessert sich seine Abschlussquote bei den bearbeiteten Opportunities.
- Weniger Supportfälle und geringere Lösungskosten: KI-gestützte Triage, die Tickets nach dem prognostizierten Lösungsweg weiterleitet und passende Wissensdatenbank-Artikel vor der Eskalation an Menschen anzeigt, senkt gleichzeitig die durchschnittliche Bearbeitungszeit und die Zahl der Fälle, die an Mitarbeiter gelangen.
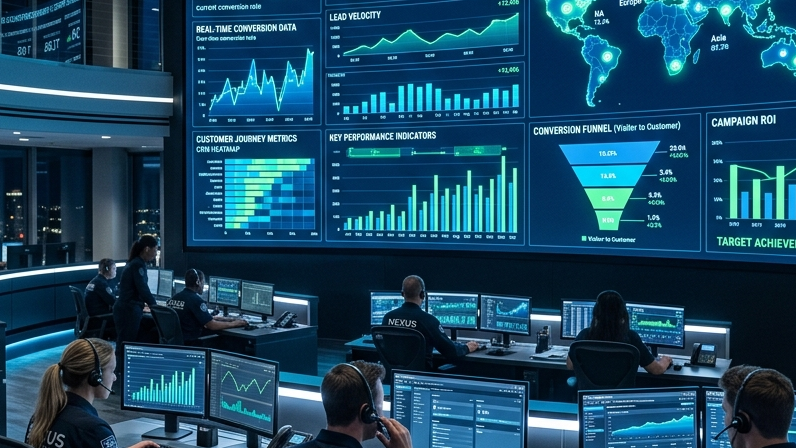
Die individuelle Intelligenzschicht von GTEMAS
GTEMAS baut die Infrastruktur, die zwischen Ihrem bestehenden CRM und den KI-Fähigkeiten liegt, die Ihre kundennahen Teams brauchen. Das ist kein CRM-Ersatz. Es ist CRM-Erweiterung – mit Datenpipeline, ML-Modellen und Aktivierungs-Integrationen, die Ihr bestehendes System of Record zu einem System of Intelligence machen.
Unsere Engagements beginnen typischerweise mit einem Daten-Audit und dem Architekturentwurf: Wir erfassen die vorhandenen Datenquellen, bewerten die Datenqualität und entwerfen die Struktur des einheitlichen Profils, die die Intelligenzschicht antreibt. Danach bauen wir die Integrationsinfrastruktur, trainieren erste Modelle auf historischen Daten und setzen Aktivierungs-Workflows in den Systemen ein, die Ihre Teams bereits nutzen. Die ersten Modelle laufen innerhalb von 60–90 Tagen in der Produktion und liefern Prognosen auf echten Daten statt in Demo-Szenarien.
Wenn Sie wissen möchten, wie eine individuelle Intelligenzschicht auf Ihrem aktuellen CRM aussähe – was der Aufbau kosten würde, welche messbaren Geschäftsergebnisse sie brächte und was Ihre Organisation für den Betrieb leisten müsste –, ist das GTEMAS-Team bereit für dieses Gespräch.