

Giới hạn của CRM tĩnh
Đa số tổ chức dùng CRM như một kho lưu trữ có cấu trúc. Nó ghi lại những gì đã xảy ra: một liên hệ được tạo, một thương vụ được chốt, một ticket hỗ trợ được xử lý. Dữ liệu chính xác, các trường được điền đủ, báo cáo chạy đúng lịch. Và nó gần như không tạo ra lợi thế cạnh tranh nào, vì CRM của đối thủ nào cũng trông giống hệt.
Vấn đề không nằm ở bản thân CRM. Salesforce, HubSpot và Microsoft Dynamics đều là các nền tảng đủ năng lực. Vấn đề là lớp lẽ ra phải nằm bên trên chúng: lớp phân tích biến dữ liệu lịch sử thành dự đoán hướng về phía trước. Với đa số tổ chức, lớp đó không tồn tại. CRM chỉ là chiếc gương chiếu hậu. Quan hệ khách hàng hiện đại cần thứ gần với một hệ thống dẫn đường hơn: biết theo thời gian thực khách hàng đang ở đâu, nhiều khả năng sẽ đi đâu, và can thiệp thế nào sẽ cho kết quả tốt nhất ở điểm quyết định kế tiếp.
Xây hệ thống dẫn đường đó là bài toán kỹ thuật không kém gì bài toán data science. Và đa số dự án triển khai CRM làm sai ở đây, không phải vì thiếu công nghệ mà vì kiến trúc không được thiết kế cho việc này ngay từ đầu.
Kiến trúc của siêu cá nhân hóa
Chuyển từ CRM tĩnh sang hệ thống phân tích động đòi hỏi nghĩ lại kiến trúc ở ba lớp riêng biệt. Mỗi lớp có yêu cầu kỹ thuật riêng, kiểu lỗi riêng và tác động tổ chức riêng.
- Lớp dữ liệu (CDP): Customer Data Platform tổng hợp dữ liệu hành vi và giao dịch từ mọi điểm chạm: lượt truy cập web, phiên dùng ứng dụng di động, tương tác email, ticket hỗ trợ, giao dịch mua tại cửa hàng và các nguồn dữ liệu bổ sung từ bên thứ ba. CDP xác định danh tính xuyên suốt các nguồn này (nối phiên truy cập website ẩn danh với liên hệ đã biết trong CRM), duy trì hồ sơ khách hàng thống nhất theo thời gian thực và cung cấp hồ sơ đó cho mọi hệ thống phía sau qua một API nhất quán. Thiếu lớp này, lớp phân tích sẽ làm việc với dữ liệu thiếu và đã cũ. Chất lượng của hồ sơ thống nhất đặt ra mức trần cho chất lượng của mọi thứ xây trên nó.
- Lớp phân tích (AI/ML): Các mô hình học máy huấn luyện trên hồ sơ khách hàng thống nhất đưa ra những dự đoán hành động được ngay: khả năng rời bỏ, mức sẵn sàng mua thêm, sản phẩm tiếp theo nên đề xuất, kênh liên lạc ưa thích và thời điểm gửi tối ưu. Các mô hình này cần huấn luyện lại liên tục khi hành vi khách hàng thay đổi, cần theo dõi drift và thiên lệch, và cần vòng phản hồi rõ ràng giữa kết quả dự đoán với kết quả thực tế để đo và cải thiện hiệu quả. Đây không phải cấu hình một lần. Đây là một hoạt động data science liên tục.
- Lớp kích hoạt: Thông tin phân tích chỉ có giá trị khi đến được những người và hệ thống có thể hành động theo nó. Trong thực tế, điều này nghĩa là hiển thị dự đoán trên giao diện CRM cho nhân viên bán hàng và chăm sóc khách hàng, kích hoạt các chuỗi tự động trong nền tảng marketing automation, cập nhật quy tắc cá nhân hóa của website theo thời gian thực, và cấp dữ liệu cho các hệ thống đề xuất trên giao diện thương mại điện tử. Lớp kích hoạt cần độ trễ dưới một giây với use case thời gian thực (nhân viên chăm sóc khách hàng phải thấy điểm rủi ro rời bỏ ngay khi cuộc gọi kết nối, không phải 20 giây sau) và cần giao dữ liệu theo lô đáng tin cậy với use case theo lịch (cập nhật tệp đối tượng chiến dịch, báo cáo sức khỏe tài khoản hằng tuần).
Sơ đồ kiến trúc của hệ thống này trông phức tạp hơn một dự án CRM truyền thống, vì thực sự là như vậy. Nhưng độ phức tạp chủ yếu nằm ở lớp hạ tầng dữ liệu, không nằm ở bản thân CRM. CRM trở thành lớp hiển thị cho phần phân tích được tạo ra ở nơi khác.
AI tạo sinh trong CRM: hai ứng dụng thực tế
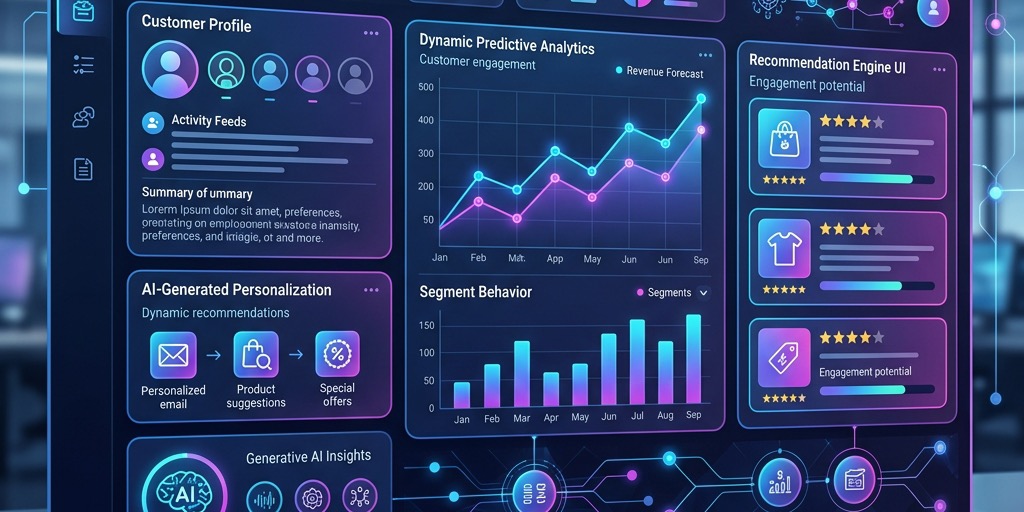
Ngoài các mô hình dự đoán, AI tạo sinh đang tạo ra giá trị đo được ở hai use case CRM cụ thể, vốn đã chuyển từ thử nghiệm sang vận hành trong 18 tháng qua.
Tạo nội dung liên lạc cá nhân hóa: Thay vì chọn một mẫu rồi điền các merge field, AI agent viết nội dung email và tin nhắn từ đầu, dựa trên hồ sơ khách hàng, các tương tác gần đây và kết quả cụ thể mà lần liên lạc đó nhắm tới. Một email giữ chân cho khách giá trị cao có nguy cơ rời bỏ khác với email giữ chân cho khách mới có mức tương tác thấp, không chỉ ở ưu đãi mà cả ở giọng điệu, cách đặt vấn đề, độ dài và các sản phẩm được nhắc đến. Ở quy mô lớn, việc này cần AI tạo sinh. Copywriter không thể viết nội dung riêng cho 100.000 liên hệ trong mỗi chu kỳ chiến dịch. Các tổ chức áp dụng cách này cho biết tỷ lệ mở email và tỷ lệ chuyển đổi tăng đáng kể so với cách dùng mẫu.
"Trò chuyện với dữ liệu" cho đội bán hàng: Giao diện truy vấn bằng ngôn ngữ tự nhiên cho phép nhân viên bán hàng đặt câu hỏi về dữ liệu CRM mà không cần viết SQL hay lần qua các bộ lọc phức tạp. Câu hỏi "Tài khoản nào trong khu vực của tôi đã 45 ngày không có hoạt động và có hợp đồng gia hạn đang mở trong 90 ngày tới?" có câu trả lời ngay, thay vì một bài làm báo cáo mất 20 phút. Các triển khai tinh vi hơn cho phép nhân viên hỏi những câu mang tính dự đoán: "Cơ hội đang mở nào của tôi có khả năng chốt nhất trong quý này?" Hệ thống trả về không chỉ đáp án mà cả bằng chứng: các tín hiệu hoạt động, mẫu tương tác và so sánh lịch sử làm cơ sở cho dự đoán.
Khung quyết định mua hay tự xây
Khi tổ chức quyết định đầu tư vào năng lực CRM dùng AI, câu hỏi đầu tiên thường là: nên mua giải pháp của nhà cung cấp (Salesforce Einstein, HubSpot AI, Microsoft Copilot for Sales) hay tự xây một lớp phân tích riêng?
Câu trả lời thẳng thắn là: tùy bạn muốn tạo khác biệt ở điểm nào.
Giải pháp AI của nhà cung cấp phù hợp với các năng lực chung cho cả ngành của bạn: chấm điểm rời bỏ cơ bản, thuật toán đề xuất tiêu chuẩn, phân tích cảm xúc dùng ngay cho ticket hỗ trợ. Đây là những bài toán đã có lời giải. Trả tiền cho nhà cung cấp giải chúng thường rẻ và nhanh hơn xây từ đầu, và gánh nặng bảo trì thuộc về nhà cung cấp.
Lớp phân tích tự xây phù hợp khi logic bạn dùng để định nghĩa phân khúc khách hàng, chấm điểm một tài khoản hay tạo đề xuất phản ánh hiểu biết riêng về thị trường và khách hàng của bạn mà mô hình chung không sao chép được. Một công ty dịch vụ tài chính đã xây các tín hiệu rủi ro riêng từ 15 năm dữ liệu hành vi khách hàng sẽ không đạt được độ chính xác dự đoán tương đương từ một mô hình dùng ngay của nhà cung cấp. Một công ty B2B có chu kỳ bán hàng rất đặc thù và tập tài khoản tiềm năng hẹp sẽ dự đoán pipeline tốt hơn bằng mô hình huấn luyện trên dữ liệu lịch sử của chính mình so với mô hình chung huấn luyện trên toàn bộ khách hàng của Salesforce.
Cách làm thực tế là xếp lớp: dùng giải pháp của nhà cung cấp cho các chức năng phổ thông, và tự xây mô hình cho những năng lực thực sự tạo khác biệt. GTEMAS chuyên thiết kế và xây các lớp phân tích riêng này trên nền các CRM sẵn có: kiến trúc nối CDP, mô hình ML và các hệ thống kích hoạt mà không buộc tổ chức phải thay CRM đã mất nhiều năm cấu hình.
Đo ROI
Các khoản đầu tư vào siêu cá nhân hóa thường được bảo vệ bằng những lập luận mơ hồ về trải nghiệm khách hàng. CFO muốn có con số. Dưới đây là các chỉ số thực sự thay đổi khi kiến trúc hoạt động tốt:
- Giảm tỷ lệ rời bỏ: Các tổ chức triển khai chấm điểm rời bỏ dự đoán và quy trình can thiệp sớm tự động thường giảm được 10–20% lượng khách chủ động rời đi trong năm đầu. Với một công ty B2B SaaS có $50M ARR và tỷ lệ rời bỏ 15% mỗi năm, giảm 15% tỷ lệ rời bỏ tương ứng $1,1M doanh thu được giữ lại, lặp lại hằng năm.
- Doanh thu bán thêm và bán chéo: Các mô hình ưu đãi tiếp theo phù hợp nhất, khi được huấn luyện và kích hoạt đúng cách, làm tăng doanh thu mở rộng trên mỗi tài khoản ở mức đo được. Cơ chế khá đơn giản: đưa đúng ưu đãi đến đúng tài khoản vào lúc họ dễ đón nhận nhất, thay vì chạy chiến dịch hằng quý cho toàn bộ tệp khách hàng bất kể họ đã sẵn sàng hay chưa.
- Rút ngắn chu kỳ bán hàng: Quản lý pipeline ưu tiên bằng AI giảm thời gian nhân viên bán hàng dành cho các cơ hội có xác suất thấp. Khi nhân viên bắt đầu tuần với danh sách tài khoản xếp hạng theo tín hiệu hành vi thực tế thay vì cảm tính, tỷ lệ chốt trên các cơ hội họ đã làm sẽ cải thiện.
- Deflection hỗ trợ và chi phí xử lý: Phân loại ticket có AI hỗ trợ, định tuyến theo hướng xử lý dự đoán và hiển thị các bài viết cơ sở tri thức liên quan trước khi chuyển lên nhân viên, giúp giảm thời gian xử lý trung bình và đồng thời cải thiện tỷ lệ deflection.
Lớp phân tích riêng của GTEMAS
GTEMAS xây hạ tầng nằm giữa CRM hiện có của bạn và các năng lực AI mà những đội làm việc với khách hàng cần. Đây không phải thay thế CRM. Đây là bổ sung cho CRM: thêm data pipeline, các mô hình ML và các tích hợp kích hoạt để biến hệ thống lưu trữ hiện có của bạn thành hệ thống phân tích.
Các dự án của chúng tôi thường bắt đầu bằng kiểm toán dữ liệu và thiết kế kiến trúc: lập bản đồ các nguồn dữ liệu hiện có, đánh giá chất lượng dữ liệu và thiết kế cấu trúc hồ sơ thống nhất làm nền cho lớp phân tích. Sau đó, chúng tôi xây hạ tầng tích hợp, huấn luyện các mô hình đầu tiên trên dữ liệu lịch sử và triển khai quy trình kích hoạt trong các hệ thống mà đội của bạn đang dùng. Các mô hình đầu tiên chạy production trong 60–90 ngày, đưa ra dự đoán trên dữ liệu thật chứ không phải kịch bản demo.
Nếu bạn muốn biết một lớp phân tích riêng trên nền CRM hiện tại sẽ như thế nào (chi phí xây dựng, kết quả kinh doanh đo được mà nó mang lại, và tổ chức của bạn cần làm gì để duy trì nó), đội GTEMAS sẵn sàng bắt đầu cuộc trao đổi đó.