

静的なCRMの限界
多くの組織は、CRMを構造化されたアーカイブとして使っています。コンタクトが作成された、商談が成立した、サポートチケットが解決された、といった起きたことを記録します。データは正確で、項目は埋まっており、レポートも予定どおりに実行されます。それでも競争優位はほとんど生まれません。どの競合のCRMも、見た目が同じだからです。
問題はCRMそのものではありません。Salesforce、HubSpot、Microsoft Dynamicsは、どれも優れたプラットフォームです。問題は、その上にあるべき層、つまり過去の記録を将来の予測に変えるインテリジェンスの層で、ほとんどの組織にはその層がありません。CRMは、バックミラーのようなものです。現代の顧客との関係に必要なのは、むしろカーナビに近いものです。顧客がいまどこにいるか、どこへ向かいそうか、次の意思決定の場面でどんな働きかけが最良の結果につながるかを、リアルタイムで把握する仕組みです。
このカーナビを作ることは、データサイエンスの問題であると同時に、エンジニアリングの問題でもあります。多くのCRM導入がこれに失敗するのは、技術が手に入らないからではなく、最初からそのためのアーキテクチャで設計されていないからです。
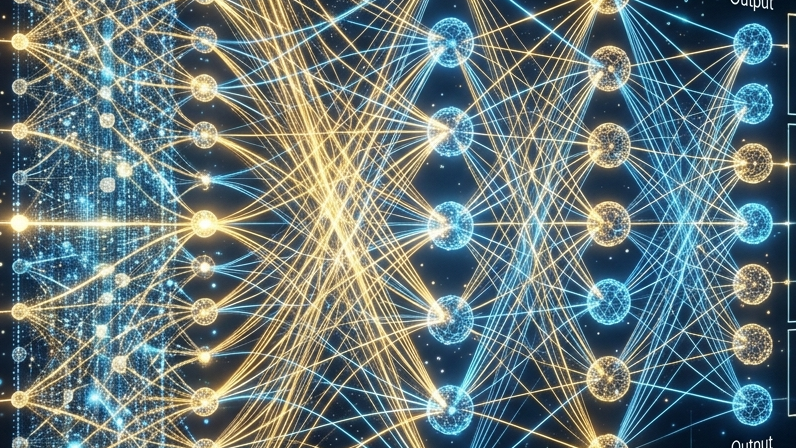
ハイパーパーソナライゼーションのアーキテクチャ
静的なCRMから動的なインテリジェンスのシステムへ移行するには、3つの層でアーキテクチャを見直す必要があります。各層に固有の技術要件、固有の失敗の仕方、固有の組織への影響があります。
- データ層(CDP):カスタマーデータプラットフォームが、あらゆる接点の行動データと取引データを集約します。ウェブ訪問、モバイルアプリのセッション、メールでのやり取り、サポートチケット、店舗での購入、外部データによる補強のフィードなどです。CDPはこれらのソースをまたいで本人を特定し(匿名のウェブセッションを、既知のCRMのコンタクトに結びつけます)、統合された顧客プロフィールをリアルタイムに保ち、そのプロフィールを一貫したAPIで下流のすべてのシステムに提供します。この層がなければ、インテリジェンス層は不完全で古いデータで動くことになります。統合プロフィールの品質が、その上に構築するすべての品質の上限を決めます。
- インテリジェンス層(AI/ML):統合された顧客プロフィールで学習した機械学習モデルが、行動に移せる予測を出します。離脱の傾向、アップセルの準備度、次に勧めるべき商品、好ましい連絡チャネル、最適な送信タイミングなどです。顧客の行動の変化に合わせてモデルを継続的に再学習し、ドリフトやバイアスを監視し、予測した結果と実際の結果の間に明確なフィードバックのループを設けて、性能を測定して改善できるようにする必要があります。これは一度設定すれば終わりではありません。継続的なデータサイエンスの運用です。
- アクティベーション層:インテリジェンスが価値を持つのは、それを活用できる人とシステムに届いたときだけです。具体的には、営業やサービス担当者向けにCRMの画面で予測を表示する、マーケティングオートメーションのプラットフォームで自動シーケンスを起動する、ウェブサイトのパーソナライズのルールをリアルタイムで更新する、ECの画面のレコメンドエンジンにデータを渡す、といったことです。アクティベーション層は、リアルタイムのユースケースではサブ秒のレイテンシで動作する必要があります(カスタマーサービスの担当者は、通話がつながった時点で離脱リスクのスコアを見る必要があり、20秒後では遅すぎます)。スケジュール型のユースケース(キャンペーン対象者の更新、週次のアカウントの健全性レポート)では、確実なバッチ配信が必要です。
このシステムのアーキテクチャ図は、従来のCRM導入より複雑に見えます。実際に複雑だからです。ただし、その複雑さの大半はデータ基盤の層にあり、CRM自体にはありません。CRMは、ほかの場所で生成されたインテリジェンスの表示層になります。
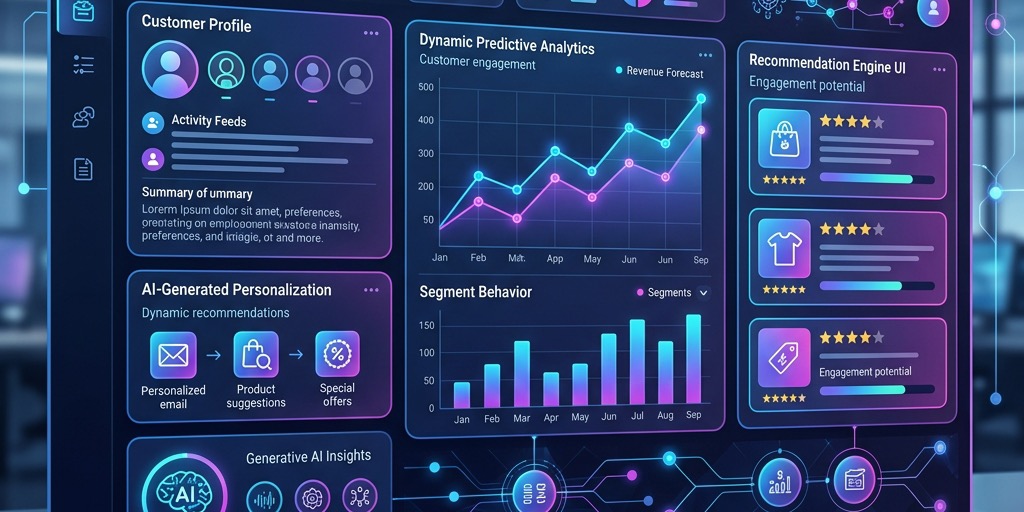
CRMにおける生成AI:2つの実用的な活用
予測モデルに加えて、生成AIはCRMの2つの具体的なユースケースで、測定可能な価値を生み出しています。どちらも、この18か月で実験段階から運用段階に移りました。
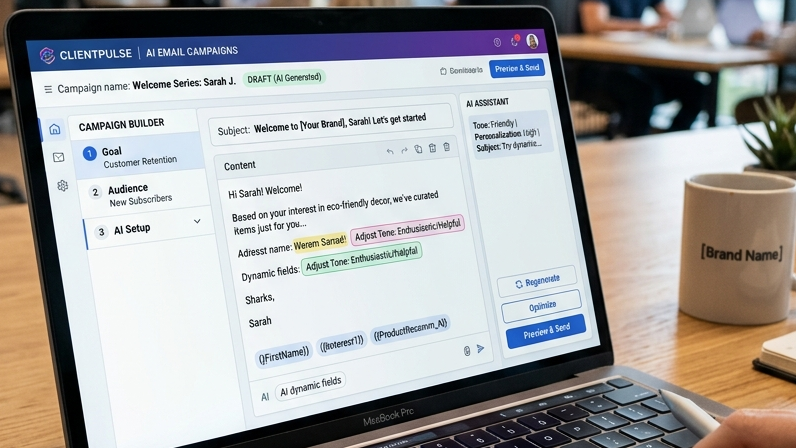
パーソナライズされたコミュニケーションの生成:テンプレートを選んで差し込み項目を埋めるのではなく、AIエージェントが、顧客のプロフィール、直近のやり取り、そのコミュニケーションで実現したい成果をもとに、メールやメッセージの内容をゼロから生成します。離脱リスクのある優良顧客への引き止めのメールは、新規に獲得したばかりでエンゲージメントの低い顧客への引き止めのメールとは違います。オファーだけでなく、トーン、切り口、長さ、具体的な商品への言及も変わります。これを大規模に行うには、生成AIが必要です。人間のコピーライターは、1回のキャンペーンサイクルで100,000件のコンタクトに個別の内容を書くことはできません。この方法を導入した組織は、テンプレート型の方法と比べて、開封率とコンバージョン率が目に見えて向上したと報告しています。
営業チームのための「データとの対話」:自然言語のクエリインターフェースによって、営業担当者はSQLを書いたり複雑なフィルター画面を操作したりせずに、CRMのデータに質問できます。「自分の担当エリアで、45日間活動がなく、今後90日以内に更新の見込みがあるアカウントはどれか」という問いに、20分かけてレポートを作る代わりに、すぐに答えが返ります。より高度な実装では、担当者が予測に関する質問もできます。「自分の進行中の商談のうち、今四半期に成約する可能性が最も高いのはどれか」。システムは答えだけでなく、その根拠も返します。予測を裏づける活動のシグナル、エンゲージメントのパターン、過去との比較です。
作るか買うかの判断の枠組み
AIを活用したCRMの機能に投資すると決めた組織が、最初に挙げる問いは、たいてい次のものです。ベンダーのソリューション(Salesforce Einstein、HubSpot AI、Microsoft Copilot for Sales)を買うべきか、それとも独自のインテリジェンス層を作るべきか。
正直な答えは、何で差別化したいかによる、ということです。
ベンダーのAIソリューションが向いているのは、業界全体で共通の機能です。基本的な離脱スコアリング、標準的なレコメンドのアルゴリズム、サポートチケット向けの標準のセンチメント分析などです。これらは解決済みの問題です。ベンダーに費用を払って解決してもらうほうが、ゼロから作るより安く速いのが普通で、保守の負担もベンダーが持ちます。
独自に作るインテリジェンス層が向いているのは、顧客セグメントの定義、アカウントのスコアリング、レコメンドの生成のロジックが、汎用のモデルでは再現できない、自社の市場と顧客に関する独自の知見を反映している場合です。15年分の顧客行動データから独自のリスクシグナルを作り上げた金融サービス企業は、標準のベンダーモデルでは同等の予測精度を得られません。販売サイクルが非常に特殊で、見込みのあるアカウントの母集団が狭いB2B企業は、すべてのSalesforce顧客で学習した汎用モデルより、自社の過去データで学習したモデルのほうが、パイプラインをより正確に予測できます。
実際には、層で使い分ける方法が現実的です。汎用的な機能にはベンダーのソリューションを使い、本当に差別化できる機能には独自のモデルを作ります。GTEMASは、既存のCRMプラットフォームの上に、こうした独自のインテリジェンス層を設計して構築することを専門としています。CDP、MLモデル、アクティベーションのシステムをつなぐアーキテクチャで、何年もかけて設定してきたCRMを入れ替える必要はありません。
ROIの測り方
ハイパーパーソナライゼーションへの投資は、顧客体験についての曖昧な主張で正当化されることがよくあります。CFOが求めるのは数字です。アーキテクチャが機能しているときに、実際に動く指標は次の通りです。
- 解約率の低下:予測による離脱スコアリングと、自動の早期対応のワークフローを導入した組織では、通常、最初の1年で自発的な解約が10–20%減ります。ARRが$50Mで年間解約率が15%のB2B SaaS企業なら、解約が15%減ると、$1.1Mの収益を守れます。毎年、継続的にです。
- アップセルとクロスセルの収益:次に提案すべきオファーのモデルを適切に学習させて稼働させると、アカウントあたりの拡大収益が測定可能な水準で向上します。仕組みは単純です。準備が整っているかどうかに関係なく、四半期ごとに顧客基盤全体にキャンペーンを行うのではなく、最も受け入れられやすいタイミングで、適切なアカウントに適切なオファーを表示します。
- 営業サイクルの短縮:AIで優先順位づけしたパイプライン管理により、営業担当者が成約の見込みが低い案件に費やす時間が減ります。担当者が週の初めに、勘ではなく実際の行動のシグナルに基づいて順位づけされたアカウントのリストを手にすれば、取り組んだ案件の成約率は上がります。
- サポートの自己解決と解決コスト:予測した解決の経路に応じてチケットを振り分け、担当者にエスカレーションする前に関連するナレッジベースの記事を表示するAI支援のトリアージにより、平均対応時間が短くなり、自己解決の割合も同時に上がります。
GTEMASの独自インテリジェンス層
GTEMASは、既存のCRMと、顧客対応のチームが必要とするAIの機能との間に入る基盤を構築します。CRMの置き換えではなく、CRMの拡張です。データパイプライン、MLモデル、アクティベーションの連携を追加して、既存の記録のシステムを、インテリジェンスのシステムに変えます。
通常、まずデータの監査とアーキテクチャの設計から始めます。既存のデータソースを洗い出し、データの品質を評価し、インテリジェンス層を支える統合プロフィールの構造を設計します。そのうえで、連携の基盤を構築し、過去データで最初のモデルを学習させ、チームがすでに使っているシステムにアクティベーションのワークフローを展開します。最初のモデルは60–90日以内に本番で稼働し、デモのシナリオではなく実際のデータで予測を出します。
現在のCRMの上に独自のインテリジェンス層を載せると何ができるのか、構築にいくらかかるのか、測定可能な事業成果として何が得られるのか、維持するために組織が何をする必要があるのかを知りたい場合は、GTEMASのチームが、その相談に応じます。