

La facture dont personne n’est responsable
Demandez à un VP Engineering qui, dans son organisation, est responsable de la facture AWS, et vous obtiendrez un long silence. « DevOps, probablement ? Ou peut-être la Finance ? » Dans une architecture monolithique, ce flou restait gérable. Une application, une équipe, une facture. On voyait les coûts, on comprenait ce qui les expliquait et on pouvait agir.
Les microservices ont totalement cassé ce modèle. Quand votre plateforme compte 200 services indépendants, chacun avec ses propres coûts de calcul, de stockage, de réseau et de transfert de données, l’image des coûts se fragmente avec l’architecture. Un pic sur votre relevé mensuel peut venir d’un service qui se comporte mal, d’un changement dans les flux de sortie de données, d’un load balancer oublié d’une fonctionnalité abandonnée, ou de l’effet cumulé d’une douzaine de petites inefficacités que nulle équipe n’a remarquées, parce que chacune semblait négligeable isolément.
Ce n’est pas un problème d’outils. AWS Cost Explorer existe. Les alertes Budgets existent. Les politiques de tagging existent. Les organisations qui traitent la maîtrise des coûts du cloud comme un exercice de configuration finissent invariablement par constater que les outils n’ont jamais été la contrainte. La contrainte est culturelle et organisationnelle : qui est responsable, qui a la visibilité et qui a l’autorité pour agir.
Ce qu’est réellement FinOps (et ce qu’il n’est pas)
FinOps, pour Financial Operations appliquées à l’infrastructure cloud, est une pratique et non un produit. La FinOps Foundation le définit comme « une pratique culturelle qui rapproche la technologie, la finance et le métier pour aligner les dépenses et la valeur métier ». Cette définition paraît abstraite jusqu’à ce qu’on voie ce qu’elle signifie en pratique : des équipes d’ingénierie qui comprennent vraiment l’économie unitaire, des équipes financières capables d’interpréter les codes des services AWS et un modèle de responsabilité partagée qui fait de la performance des coûts une préoccupation de premier rang, au même titre que la fiabilité et la sécurité.
Ce que FinOps n’est pas : installer CloudHealth ou Apptio et considérer que c’est terminé. Les outils tiers de visibilité des coûts sont utiles, mais ils alimentent une pratique FinOps, ils ne la constituent pas. Les organisations qui achètent des outils sans les changements de culture et de processus qui vont avec constatent généralement une amélioration à court terme de la visibilité des coûts (réelle et précieuse), suivie d’un plateau : les coûts restent élevés, car personne n’a changé la façon dont les ingénieurs décident de l’allocation des ressources.
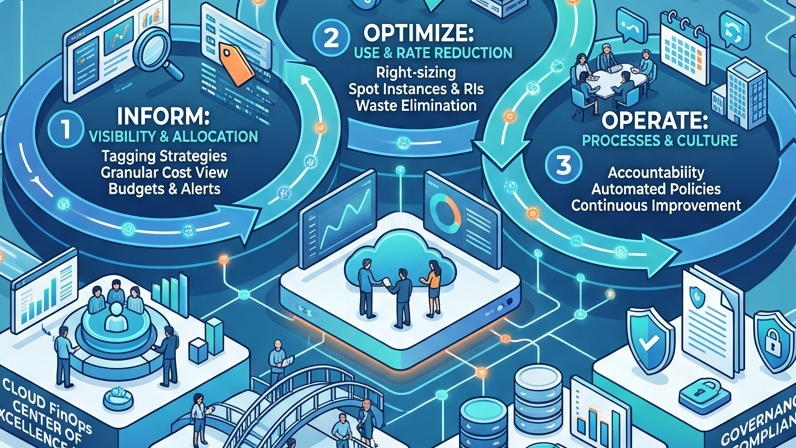
Les trois piliers d’une pratique FinOps mature sont Inform (rendre les coûts visibles et attribuables), Optimize (repérer les inefficacités et agir) et Operate (intégrer la discipline des coûts aux processus de livraison courants). La plupart des organisations atteignent vite Inform. Passer par Optimize puis entrer dans Operate demande un engagement organisationnel durable que la plupart des initiatives de réduction des coûts ne parviennent jamais à installer.
Des stratégies de tagging qui fonctionnent vraiment
Le tagging des ressources est le fondement de la visibilité des coûts dans un environnement de microservices, et c’est aussi là que la plupart des organisations échouent en premier. Le scénario d’échec est prévisible : une politique de tagging, bien intentionnée, est définie, appliquée en partie, puis s’érode peu à peu quand les équipes, sous la pression de la livraison, abandonnent cette discipline. Six mois plus tard, 40% des ressources ne sont pas taguées ou le sont de façon incohérente, et l’attribution des coûts devient un exercice d’estimation plutôt qu’un constat.
Un tagging efficace suppose de traiter les tags comme de l’infrastructure, non comme des métadonnées. Concrètement :
- Une application au moment du provisionnement. Si votre Infrastructure as Code (Terraform, CloudFormation, CDK) n’exige pas certains tags comme entrées obligatoires, les tags resteront facultatifs en pratique, quelle que soit la politique. Utilisez des règles de politique personnalisées, des SCP d’AWS Organizations ou des politiques Sentinel pour rejeter, dès la création, les ressources dépourvues des tags requis.
- Une taxonomie minimale et stable. La tentation est de tout taguer avec un maximum de granularité : environnement, équipe, produit, centre de coûts, projet, client, application et niveau. En pratique, les taxonomies de plus de six à huit tags obligatoires deviennent ingérables. Commencez par :
env,service,team,cost-centeretproduct. N’étendez que lorsque le besoin métier est concret. - Une correction automatisée des dérives. Même avec une application au provisionnement, les ressources héritées, les ressources créées manuellement et celles gérées par AWS (certains snapshots RDS, par exemple) résistent au tagging. Utilisez une correction automatisée du tagging fondée sur Lambda, exécutée selon un calendrier, qui signale ou corrige les écarts.
- Une modélisation de l’héritage des tags. Dans un environnement de microservices, une même application peut avoir du calcul sur EC2 ou ECS, du stockage sur S3 et RDS, du réseau via ALB et NAT gateway, et de l’orchestration via Step Functions ou EventBridge. Le coût du « service de traitement des commandes » s’étend sur tout cela. Des schémas d’héritage des tags dans vos modules d’IaC garantissent que toutes les ressources provisionnées par un même module portent la même attribution de service et d’équipe.
Showback ou chargeback : choisir le bon modèle
Une fois que le tagging permet d’attribuer les coûts, la question organisationnelle suivante est de savoir quoi faire de cette information. Deux modèles dominent : le showback et le chargeback.
Le showback rend les coûts visibles aux équipes sans conséquence financière. Les équipes d’ingénierie voient leurs dépenses cloud mensuelles, comprennent les tendances et peuvent optimiser de leur propre initiative. Ce modèle convient aux organisations où la culture d’ingénierie est déjà attentive aux coûts et où les équipes produit sont réellement propriétaires de leurs services.
Le chargeback va plus loin : les coûts attribués sont effectivement refacturés aux unités métier ou aux lignes de produits, et pèsent sur leur compte de résultat ou leur budget. Cela crée une incitation financière plus forte à optimiser, mais introduit de la complexité. Les équipes se mettent à manipuler l’attribution pour minimiser leurs coûts visibles. Les services d’infrastructure partagés (réseau, observabilité, outils de sécurité) exigent des modèles de répartition. Les équipes financières ont besoin de nouveaux processus pour gérer la facturation interne. Les débats sur la méthode de répartition accaparent un temps de direction d’ingénierie qui pourrait servir à la livraison.
La réponse pratique, pour la plupart des organisations, est une approche par étapes : mettre d’abord en place le showback pour développer la culture des coûts et repérer les opportunités d’optimisation les plus rentables sans créer de dynamique conflictuelle. Après 12–18 mois, quand les équipes comprennent le paysage des coûts et ont montré leur volonté d’agir, introduire un chargeback sélectif pour les centres de coûts les plus importants et les plus facilement attribuables.
Un chiffre concret : une organisation d’ingénierie de 400 personnes qui a mis en place le showback sur sa plateforme de microservices a vu ses dépenses cloud baisser de 23% en huit mois, non pas sous la pression d’un chargeback, mais parce que des ingénieurs qui voyaient leurs coûts pour la première fois ont trouvé et corrigé des inefficacités dont ils ignoraient réellement l’existence.
Optimiser les Reserved Instances et les Savings Plans
La tarification à la demande convient aux charges variables et imprévisibles. Pour la capacité de base des environnements de microservices en production, elle représente un surcoût important, généralement de 40–60% par rapport à une couverture équivalente en Reserved Instances ou en Savings Plans.
La difficulté tient à ce que l’optimisation des RI est nettement plus complexe dans un environnement de microservices que dans un monolithe. Il y a plus de types d’instances, plus de services aux schémas d’utilisation différents et plus d’équipes dont le comportement de montée en charge est indépendant. S’engager sur de la capacité réservée suppose une confiance dans la demande future que beaucoup d’équipes n’ont, on le comprend, pas.
Quelques principes aident à s’y retrouver :
- Des Compute Savings Plans plutôt que des RI par type d’instance. Les Compute Savings Plans offrent 66% de remise par rapport à la tarification à la demande et s’appliquent automatiquement à toute famille d’instances EC2, à ECS et à Lambda, ce qui correspond exactement à la flexibilité nécessaire dans un environnement de microservices où les types d’instances changent à mesure que les services évoluent.
- Couvrir la base, pas le pic. Analysez les données d’utilisation des 90 derniers jours et repérez le plancher de capacité, c’est-à-dire le calcul qui tourne en continu quelle que soit la charge. Couvrez-le avec des Savings Plans ou des RI. Laissez la capacité des pics à la demande. Même une couverture de 60–70% de la base réduit fortement les tarifs moyens pondérés.
- Automatiser le cycle de revue. Les schémas d’utilisation changent à mesure que les services évoluent. Fixez un rendez-vous trimestriel pour revoir la couverture des RI, les dates d’expiration et les taux d’utilisation. Les organisations qui s’en dispensent accumulent des réservations inutilisées et manquent des fenêtres de renouvellement, à un coût non négligeable.
La couche de gouvernance : faire tenir FinOps dans la durée
La mécanique du tagging et de la capacité réservée relève de problèmes d’ingénierie solubles. Le défi le plus difficile est la gouvernance : intégrer la discipline des coûts aux processus de livraison pour que les optimisations se cumulent dans le temps au lieu de se dégrader quand l’attention se porte ailleurs.
La gouvernance, dans un contexte FinOps, consiste à établir des droits de décision clairs (qui peut approuver des types de ressources au-delà de certains seuils de coût), des rythmes de responsabilité (revues de coûts hebdomadaires ou mensuelles au niveau des équipes et de la plateforme) et des garde-fous de coûts dans le processus de livraison (points de validation d’architecture incluant une modélisation des coûts pour toute infrastructure nouvelle importante).
Des mécanismes de gouvernance concrets qui fonctionnent de façon constante :
- Une détection des anomalies de coûts avec des circuits d’escalade : alertes automatiques lorsque les dépenses d’un service tagué dépassent de plus d’un pourcentage défini la référence, adressées à l’équipe responsable et à son responsable d’ingénierie
- Des critères de comité d’architecture qui incluent une évaluation de l’efficacité des coûts pour tout nouveau service ou changement d’infrastructure important au-delà d’un seuil de dépense mensuelle défini
- Des champions FinOps intégrés à chaque équipe produit : généralement un ingénieur senior sensible aux enjeux techniques comme commerciaux, qui participe aux groupes de travail FinOps inter-équipes
- Des points mensuels sur les coûts entre responsables d’ingénierie et finance, centrés sur l’analyse des tendances plutôt que sur la recherche de responsables
L’approche de GTEMAS en matière de gouvernance des coûts du cloud
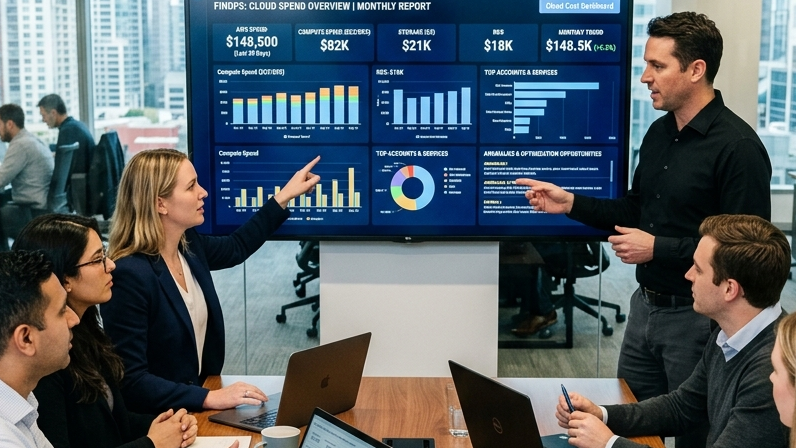
Quand GTEMAS rejoint une mission d’ingénierie de plateforme, la gouvernance des coûts du cloud n’est pas un chantier séparé : elle est intégrée au modèle de livraison dès le premier jour, dans le cadre de FastDX, notre chaîne de livraison AI-native. Nous intégrons l’application du tagging à chaque module d’IaC auquel nous contribuons. Nous mettons en place des tableaux de bord de showback dans le cadre de l’observabilité, avec une détection d’anomalies assistée par l’IA qui signale les pics de coûts avant qu’ils n’apparaissent sur la facture du mois suivant. Nous menons des revues FinOps dans le cadre de la documentation des décisions d’architecture.
Résultat : la visibilité sur les coûts et la capacité d’optimisation croissent avec la plateforme, au lieu d’être ajoutées plus tard dans la douleur. Les clients constatent généralement des baisses de coûts notables au cours des deux premiers trimestres de la mission, non par des changements d’architecture spectaculaires, mais par l’effet cumulé de dizaines de petites optimisations qui deviennent visibles dès que l’attribution fonctionne correctement.
Les factures cloud ne sont pas la conséquence inévitable de la complexité de l’architecture. Elles relèvent de l’ingénierie et, comme la plupart des problèmes d’ingénierie, elles répondent à une attention systématique. Si votre organisation fait face à une visibilité fragmentée des coûts dans un environnement de microservices, nous serions heureux d’examiner avec vous comment une approche FinOps structurée pourrait s’appliquer à votre situation.