

La factura que nadie tiene a su cargo
Pregunte a un VP de ingeniería típico quién es responsable de la factura de AWS en su organización y obtendrá una larga pausa. "¿DevOps, probablemente? ¿O tal vez Finanzas?". En una arquitectura monolítica, esa ambigüedad era manejable. Una aplicación, un equipo, una factura. Se podían ver los costos, entender sus causas y actuar sobre ellas.
Los microservicios rompieron por completo ese modelo. Cuando su plataforma tiene 200 servicios independientes, cada uno con sus propios costos de cómputo, almacenamiento, red y transferencia de datos, el panorama de costos se fragmenta junto con la arquitectura. Un pico en el estado de cuenta mensual puede deberse a un servicio que se comporta mal, a un cambio en los patrones de salida de datos, a un balanceador de carga olvidado de una funcionalidad obsoleta o al efecto acumulado de una docena de pequeñas ineficiencias que ningún equipo notó porque cada una parecía irrelevante por separado.
No es un problema de herramientas. AWS Cost Explorer existe. Las alertas de Budgets existen. Las políticas de etiquetado existen. Las organizaciones que tratan el control de costos de la nube como un ejercicio de configuración descubren invariablemente que las herramientas nunca fueron la limitación. La limitación es cultural y organizativa: quién es responsable, quién tiene la visibilidad y quién tiene la autoridad para actuar.
Qué es realmente FinOps (y qué no es)
FinOps, es decir, las operaciones financieras de la infraestructura en la nube, es una práctica, no un producto. La FinOps Foundation lo define como "una práctica cultural que reúne a tecnología, finanzas y negocio para alinear el gasto con el valor del negocio". Esa definición suena abstracta hasta que se ve lo que significa en la práctica: equipos de ingeniería que entienden de verdad la economía unitaria, equipos de finanzas capaces de interpretar los códigos de servicio de AWS y un modelo de responsabilidad compartida que convierte el desempeño en costos en una prioridad de primer nivel, junto con la fiabilidad y la seguridad.
Lo que FinOps no es: instalar CloudHealth o Apptio y dar el tema por cerrado. Las herramientas externas de visibilidad de costos son útiles, pero son insumos de una práctica FinOps, no la práctica en sí. Las organizaciones que compran herramientas sin los cambios culturales y de procesos de fondo suelen ver una mejora de corto plazo en la visibilidad de costos (que es real y valiosa) y luego un estancamiento: los costos siguen altos porque nadie ha cambiado la forma en que los ingenieros toman decisiones sobre la asignación de recursos.
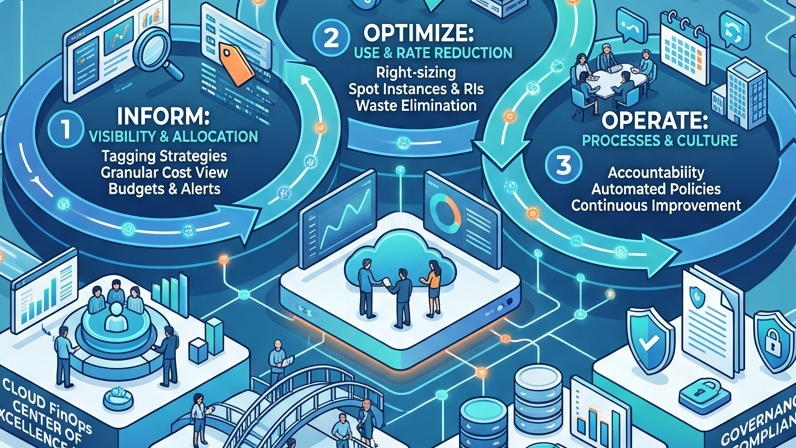
Los tres pilares de una práctica FinOps madura son Inform (hacer visibles y atribuibles los costos), Optimize (identificar las ineficiencias y actuar sobre ellas) y Operate (incorporar la disciplina de costos en los procesos de entrega diarios). La mayoría de las organizaciones llega rápido a Inform. Avanzar por Optimize hasta Operate exige un compromiso organizativo sostenido que la mayoría de las iniciativas de recorte de costos nunca desarrolla.
Estrategias de etiquetado que sí funcionan
El etiquetado de recursos es la base de la visibilidad de costos en un entorno de microservicios y es también donde la mayoría de las organizaciones falla primero. El patrón de fallo es previsible: se define una política de etiquetado con buena intención, se aplica a medias y luego se va erosionando a medida que los equipos, bajo presión de entrega, abandonan la disciplina. Seis meses después, el 40% de los recursos no tiene etiquetas o las tiene de forma inconsistente, y la atribución de costos pasa a ser un ejercicio de estimación y no de hechos.
Un etiquetado eficaz exige tratar las etiquetas como infraestructura, no como metadatos. Eso significa:
- Control obligatorio al aprovisionar. Si su Infrastructure as Code (Terraform, CloudFormation, CDK) no exige etiquetas específicas como entradas obligatorias, las etiquetas serán opcionales en la práctica, diga lo que diga la política. Use reglas de políticas personalizadas, SCP de AWS Organizations o políticas de Sentinel para rechazar los recursos sin las etiquetas requeridas en el momento de su creación.
- Una taxonomía mínima y estable. La tentación es etiquetarlo todo con la máxima granularidad: entorno, equipo, producto, centro de costos, proyecto, cliente, aplicación y nivel. En la práctica, las taxonomías de más de seis a ocho etiquetas obligatorias se vuelven inmanejables. Empiece con:
env,service,team,cost-centeryproduct. Amplíe solo cuando el caso de negocio sea concreto. - Corrección automática de desviaciones. Incluso con control obligatorio al aprovisionar, los recursos heredados, los creados a mano y los gestionados por AWS (ciertas instantáneas de RDS, por ejemplo) se resisten al etiquetado. Use una corrección automática de etiquetado basada en Lambda, que se ejecute de forma programada y señale o corrija las desviaciones.
- Modelado de herencia de etiquetas. En un entorno de microservicios, una sola aplicación puede tener cómputo en EC2 o ECS, almacenamiento en S3 y RDS, red mediante ALB y NAT gateway, y orquestación mediante Step Functions o EventBridge. El costo del "servicio de procesamiento de pedidos" abarca todos ellos. Los patrones de herencia de etiquetas en sus módulos de IaC garantizan que todos los recursos aprovisionados por un mismo módulo lleven la misma atribución de servicio y de equipo.
Showback frente a Chargeback: cómo elegir el modelo adecuado
Una vez que el etiquetado permite atribuir los costos, la siguiente pregunta organizativa es qué hacer con esa información. Existen dos modelos dominantes: showback y chargeback.
Showback hace visibles los costos a los equipos sin consecuencias financieras. Los equipos de ingeniería ven su gasto mensual en la nube, entienden las tendencias y pueden optimizar de forma voluntaria. Este modelo funciona bien en organizaciones donde la cultura de ingeniería ya es consciente de los costos y donde los equipos de producto son realmente dueños de sus servicios.
Chargeback va más allá: los costos atribuidos se facturan efectivamente a las unidades de negocio o a las líneas de producto y afectan su estado de resultados o su presupuesto. Esto crea incentivos financieros más fuertes para optimizar, pero introduce complejidad. Los equipos empiezan a manipular la atribución para minimizar sus costos visibles. Los servicios compartidos de infraestructura (red, observabilidad, herramientas de seguridad) necesitan modelos de asignación. Los equipos de finanzas necesitan nuevos procesos para gestionar la facturación interna. Las discusiones sobre la metodología de asignación consumen tiempo de la dirección de ingeniería que podría dedicarse a la entrega.
La respuesta práctica para la mayoría de las organizaciones es un enfoque por fases: implementar primero showback para generar conocimiento e identificar las oportunidades de optimización de mayor impacto sin crear dinámicas de confrontación. Después de 12-18 meses, cuando los equipos entienden el panorama de costos y han demostrado disposición a actuar, introducir un chargeback selectivo en los centros de costos más grandes y más fáciles de atribuir.
Un dato concreto: una organización de ingeniería de 400 personas que implementó showback en su plataforma de microservicios redujo en 23% su gasto en la nube en ocho meses, no por la presión del chargeback, sino porque los ingenieros, al ver sus costos por primera vez, encontraron y corrigieron ineficiencias cuya existencia realmente desconocían.
Optimización de Reserved Instances y Savings Plans
El precio bajo demanda es adecuado para cargas de trabajo variables e impredecibles. Para la capacidad base en entornos de microservicios de producción, supone un sobrepago significativo: normalmente un 40-60% más que una cobertura equivalente con Reserved Instances o Savings Plans.
La dificultad es que optimizar las RI en un entorno de microservicios es bastante más complejo que en uno monolítico. Hay más tipos de instancia, más servicios con patrones de uso distintos y más equipos con comportamientos de escalado independientes. Comprometerse con capacidad reservada exige confianza en la demanda futura, y es comprensible que muchos equipos no la tengan.
Algunos principios que ayudan a resolverlo bien:
- Compute Savings Plans en lugar de RI por tipo de instancia. Los Compute Savings Plans ofrecen un 66% de descuento frente al precio bajo demanda y se aplican automáticamente a cualquier familia de instancias EC2, a ECS y a Lambda, justo la flexibilidad que se necesita en un entorno de microservicios donde los tipos de instancia cambian a medida que los servicios evolucionan.
- Cubra la base, no el pico. Analice los datos de uso de los últimos 90 días e identifique el piso de capacidad: el cómputo que funciona de forma continua sin importar la carga. Cúbralo con Savings Plans o RI. Mantenga la capacidad para picos bajo demanda. Incluso cubrir un 60-70% de la base reduce de forma notable las tarifas combinadas.
- Automatice el ciclo de revisión. Los patrones de uso cambian a medida que los servicios evolucionan. Fije un compromiso trimestral en el calendario para revisar la cobertura de RI, las fechas de vencimiento y las tasas de uso. Las organizaciones que lo omiten acumulan reservas sin usar y pierden las ventanas de renovación, con un costo importante.
La capa de gobernanza: cómo lograr que FinOps se sostenga
La mecánica del etiquetado y de la capacidad reservada son problemas de ingeniería con solución. El desafío más difícil es la gobernanza: incorporar la disciplina de costos en los procesos de entrega para que las optimizaciones se acumulen con el tiempo y no se deterioren cuando la atención se desplaza a otro lado.
En el contexto de FinOps, la gobernanza significa establecer derechos de decisión claros (quién puede aprobar tipos de recursos por encima de ciertos umbrales de costo), ritmos de rendición de cuentas (revisiones semanales o mensuales de costos a nivel de equipo y de plataforma) y límites de costo en el proceso de entrega (puntos de revisión de arquitectura que incluyan modelado de costos para toda infraestructura nueva importante).
Mecanismos de gobernanza prácticos que funcionan de forma consistente:
- Detección de anomalías de costo con rutas de escalamiento: alertas automáticas cuando el gasto de cualquier servicio etiquetado supera en un porcentaje definido su línea base, dirigidas al equipo responsable y a su líder de ingeniería
- Criterios del Architecture Review Board que incluyan una evaluación de eficiencia de costos para todo servicio nuevo o cambio importante de infraestructura que supere un umbral de gasto mensual definido
- FinOps champions integrados en cada equipo de producto: normalmente un ingeniero senior con conciencia tanto técnica como comercial, que participa en los grupos de trabajo de FinOps entre equipos
- Stand-ups mensuales de costos entre los líderes de ingeniería y finanzas, centrados en el análisis de tendencias y no en buscar culpables
Cómo aborda GTEMAS la gobernanza de costos de la nube
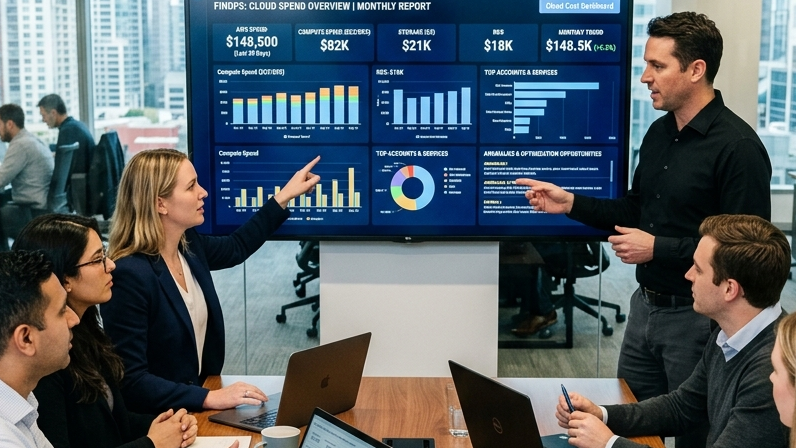
Cuando GTEMAS se incorpora a un proyecto de ingeniería de plataforma, la gobernanza de costos de la nube no es una línea de trabajo aparte: está integrada en el modelo de entrega desde el primer día, como parte de FastDX, nuestro pipeline de entrega AI-native. Integramos el control obligatorio de etiquetas en cada módulo de IaC que aportamos. Instrumentamos paneles de showback como parte de la configuración de observabilidad, con detección de anomalías asistida por IA que señala los picos de costo antes de que aparezcan en la factura del mes siguiente. Realizamos revisiones de FinOps como parte de la documentación de las decisiones de arquitectura.
El resultado es que la visibilidad de costos y la capacidad de optimización crecen junto con la plataforma, en lugar de añadirse después con una fricción considerable. Los clientes suelen ver reducciones de costos significativas en los dos primeros trimestres del proyecto, no por cambios arquitectónicos drásticos, sino por el efecto acumulado de decenas de pequeñas optimizaciones que se hacen visibles una vez que la atribución funciona bien.
Las facturas de la nube no tienen por qué ser la consecuencia inevitable de la complejidad de la arquitectura. Son un problema de ingeniería y, como la mayoría de los problemas de ingeniería, responden a una atención sistemática. Si su organización enfrenta una visibilidad de costos fragmentada en un entorno de microservicios, con gusto conversaremos sobre cómo un enfoque estructurado de FinOps podría aplicarse a su situación.