

Die Rechnung, für die niemand zuständig ist
Fragen Sie einen typischen Engineering-VP, wer in seiner Organisation für die AWS-Rechnung zuständig ist, und es folgt eine lange Pause. „DevOps, vermutlich? Oder vielleicht das Finanzwesen?“ In einer monolithischen Architektur war diese Unklarheit beherrschbar. Eine Anwendung, ein Team, eine Rechnung. Man konnte die Kosten sehen, die Treiber verstehen und handeln.
Microservices haben dieses Modell vollständig aufgebrochen. Wenn Ihre Plattform aus 200 unabhängigen Services besteht – jeder mit eigenen Kosten für Rechenleistung, Speicher, Netzwerk und Datentransfer –, zersplittert das Kostenbild zusammen mit der Architektur. Ein Ausschlag in der Monatsabrechnung kann ein Service sein, der sich falsch verhält, eine Änderung der Datenabflussmuster, ein vergessener Load Balancer einer abgekündigten Funktion oder die kumulierte Wirkung von einem Dutzend kleiner Ineffizienzen, die kein einzelnes Team bemerkte, weil jede für sich unbedeutend aussah.
Das ist kein Werkzeugproblem. AWS Cost Explorer gibt es. Budget-Alarme gibt es. Tagging-Richtlinien gibt es. Organisationen, die Cloud-Kostenkontrolle als Konfigurationsübung behandeln, stellen unweigerlich fest, dass die Werkzeuge nie der begrenzende Faktor waren. Der begrenzende Faktor ist kultureller und organisatorischer Art: Wer ist verantwortlich, wer hat die Transparenz, und wer hat die Befugnis zu handeln.
Was FinOps tatsächlich ist (und was nicht)
FinOps – Financial Operations für Cloud-Infrastruktur – ist eine Praxis, kein Produkt. Die FinOps Foundation definiert es als „eine kulturelle Praxis, die Technologie, Finanzen und Geschäft zusammenbringt, um Ausgaben und Geschäftswert in Einklang zu bringen“. Diese Definition klingt abstrakt, bis man sieht, was sie in der Praxis bedeutet: Engineering-Teams, die die Stückkosten wirklich verstehen, Finanzteams, die AWS-Servicecodes lesen können, und ein gemeinsames Verantwortungsmodell, das die Kostenleistung gleichrangig neben Zuverlässigkeit und Sicherheit stellt.
Was FinOps nicht ist: CloudHealth oder Apptio zu installieren und das Thema abzuhaken. Kostentransparenz-Tools von Drittanbietern sind nützlich, aber sie sind Eingaben für eine FinOps-Praxis und nicht die Praxis selbst. Organisationen, die Tools ohne die zugrunde liegenden kulturellen und prozessualen Änderungen kaufen, erleben typischerweise kurzfristig eine bessere Kostentransparenz (was real und wertvoll ist) und danach ein Plateau – die Kosten bleiben hoch, weil niemand verändert hat, wie Engineers über die Ressourcenzuteilung entscheiden.
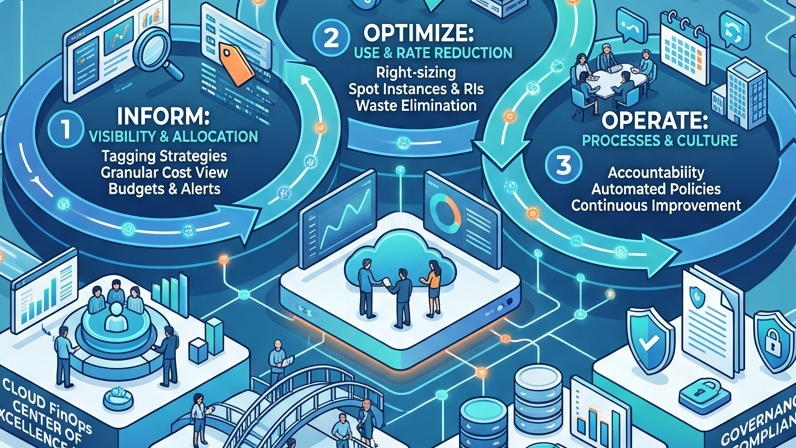
Die drei Säulen einer ausgereiften FinOps-Praxis sind Inform (Kosten sichtbar und zuordenbar machen), Optimize (Ineffizienzen erkennen und beseitigen) und Operate (Kostendisziplin in laufende Lieferprozesse einbetten). Die meisten Organisationen kommen schnell bis Inform. Der Weg durch Optimize bis Operate verlangt ein anhaltendes organisatorisches Engagement, das die meisten Kostensenkungsinitiativen nie entwickeln.
Tagging-Strategien, die wirklich funktionieren
Das Tagging von Ressourcen ist die Grundlage der Kostentransparenz in einer Microservices-Umgebung, und hier scheitern die meisten Organisationen als Erstes. Das Fehlermuster ist vorhersehbar: Eine gut gemeinte Tagging-Richtlinie wird definiert, teilweise durchgesetzt und bröckelt dann allmählich, weil Teams unter Lieferdruck die Disziplin überspringen. Sechs Monate später sind 40 % der Ressourcen ohne oder mit uneinheitlichen Tags versehen, und die Kostenzuordnung wird zur Schätzübung statt zur Tatsache.
Effektives Tagging verlangt, Tags als Infrastruktur zu behandeln, nicht als Metadaten. Das heißt:
- Durchsetzung bei der Bereitstellung. Wenn Ihre Infrastructure as Code (Terraform, CloudFormation, CDK) bestimmte Tags nicht als Pflichteingaben verlangt, sind Tags in der Praxis optional, egal was die Richtlinie sagt. Nutzen Sie eigene Richtlinienregeln, AWS-Organizations-SCPs oder Sentinel-Richtlinien, um Ressourcen ohne erforderliche Tags schon bei der Erstellung abzulehnen.
- Eine minimale, stabile Taxonomie. Die Versuchung ist, alles mit maximaler Granularität zu taggen – Umgebung, Team, Produkt, Kostenstelle, Projekt, Kunde, Anwendung und Tier. In der Praxis werden Taxonomien mit mehr als sechs bis acht Pflicht-Tags unbeherrschbar. Beginnen Sie mit:
env,service,team,cost-centerundproduct. Erweitern Sie erst, wenn der Business Case konkret ist. - Automatisierte Korrektur bei Abweichungen. Auch bei Durchsetzung zur Bereitstellungszeit entziehen sich Altressourcen, manuell erstellte Ressourcen und von AWS verwaltete Ressourcen (etwa bestimmte RDS-Snapshots) dem Tagging. Nutzen Sie Lambda-basierte automatische Tagging-Korrekturen, die nach Zeitplan laufen und Abweichungen melden oder beheben.
- Modellierung der Tag-Vererbung. In einer Microservices-Umgebung kann eine einzelne Anwendung Rechenleistung in EC2 oder ECS, Speicher in S3 und RDS, Netzwerk über ALB und NAT-Gateway sowie Orchestrierung über Step Functions oder EventBridge haben. Die Kosten des „Order-Processing-Service“ erstrecken sich über all das. Muster zur Tag-Vererbung in Ihren IaC-Modulen stellen sicher, dass alle von einem Modul bereitgestellten Ressourcen dieselbe Zuordnung zu Service und Team tragen.
Showback oder Chargeback: das passende Modell wählen
Sobald Tagging die Kostenzuordnung ermöglicht, lautet die nächste organisatorische Frage, was man mit diesen Informationen macht. Es gibt zwei vorherrschende Modelle: Showback und Chargeback.
Showback macht Teams die Kosten sichtbar, ohne finanzielle Folgen. Engineering-Teams sehen ihre monatlichen Cloud-Ausgaben, verstehen Trends und können freiwillig optimieren. Dieses Modell funktioniert gut in Organisationen, in denen die Engineering-Kultur bereits kostenbewusst ist und Produktteams ihre Services wirklich verantworten.
Chargeback geht weiter: Zugeordnete Kosten werden tatsächlich an Geschäftsbereiche oder Produktlinien weiterberechnet und wirken sich auf deren GuV oder Budget aus. Das schafft stärkere finanzielle Anreize zur Optimierung, bringt aber Komplexität mit sich. Teams beginnen, die Zuordnung zu manipulieren, um ihre sichtbaren Kosten zu minimieren. Gemeinsam genutzte Infrastrukturdienste (Netzwerk, Observability, Sicherheits-Tooling) brauchen Umlagemodelle. Finanzteams brauchen neue Prozesse für die interne Verrechnung. Streit über die Umlagemethodik verbraucht Zeit der Engineering-Leitung, die in die Lieferung fließen könnte.
Die praktische Antwort für die meisten Organisationen ist ein gestuftes Vorgehen: zuerst Showback einführen, um Kompetenz aufzubauen und die wirkungsvollsten Optimierungsmöglichkeiten zu finden, ohne ein Gegeneinander der Teams zu erzeugen. Nach 12–18 Monaten, wenn die Teams die Kostenlandschaft verstehen und gezeigt haben, dass sie bereit sind zu handeln, führt man selektives Chargeback für die größten und am besten zuordenbaren Kostenstellen ein.
Ein konkreter Datenpunkt: Eine Engineering-Organisation mit 400 Personen, die Showback in ihrer Microservices-Plattform einführte, senkte die Cloud-Ausgaben innerhalb von acht Monaten um 23 % – nicht wegen des Drucks durch Chargeback, sondern weil Engineers, die ihre Kosten zum ersten Mal sahen, Ineffizienzen fanden und behoben, von deren Existenz sie tatsächlich nichts gewusst hatten.
Optimierung von Reserved Instances und Savings Plans
On-Demand-Preise passen zu variablen, unvorhersehbaren Workloads. Für die Grundlast in produktiven Microservices-Umgebungen bedeuten sie eine deutliche Überzahlung – typischerweise 40–60 % mehr als bei gleichwertiger Abdeckung durch Reserved Instances oder Savings Plans.
Die Schwierigkeit: Die RI-Optimierung ist in einer Microservices-Umgebung wesentlich komplexer als in einer monolithischen. Es gibt mehr Instanztypen, mehr Services mit unterschiedlichen Auslastungsmustern und mehr Teams mit unabhängigem Skalierungsverhalten. Wer reservierte Kapazität bucht, braucht Sicherheit über den künftigen Bedarf, die vielen Teams verständlicherweise fehlt.
Einige Prinzipien, mit denen sich das gut bewältigen lässt:
- Compute Savings Plans statt RIs für bestimmte Instanztypen. Compute Savings Plans bieten 66 % Rabatt gegenüber On-Demand und gelten automatisch für jede EC2-Instanzfamilie, ECS und Lambda – genau die Flexibilität, die eine Microservices-Umgebung braucht, in der sich Instanztypen mit der Entwicklung der Services verschieben.
- Die Grundlast abdecken, nicht die Spitze. Analysieren Sie die Auslastungsdaten der letzten 90 Tage und bestimmen Sie die Kapazitätsuntergrenze – die Rechenleistung, die unabhängig von der Last durchgehend läuft. Decken Sie diese mit Savings Plans oder RIs ab. Spitzenkapazität bleibt On-Demand. Schon eine Abdeckung von 60–70 % der Grundlast senkt den Mischsatz erheblich.
- Den Prüfzyklus automatisieren. Auslastungsmuster ändern sich, wenn sich Services weiterentwickeln. Legen Sie einen festen Quartalstermin fest, um RI-Abdeckung, Ablaufdaten und Auslastungsraten zu prüfen. Organisationen, die das auslassen, sammeln ungenutzte Reservierungen an und verpassen Verlängerungsfenster, was spürbar Geld kostet.
Die Governance-Schicht: FinOps dauerhaft verankern
Die technische Umsetzung von Tagging und reservierter Kapazität ist ein lösbares Engineering-Problem. Die größere Herausforderung ist die Governance: Kostendisziplin so in die Lieferprozesse einzubetten, dass sich Optimierungen über die Zeit aufsummieren, statt zu verfallen, sobald die Aufmerksamkeit woandershin wandert.
Governance im FinOps-Kontext heißt: klare Entscheidungsrechte festlegen (wer darf Ressourcentypen oberhalb bestimmter Kostenschwellen freigeben), feste Abläufe für die Verantwortung (wöchentliche oder monatliche Kostenreviews auf Team- und Plattformebene) und Kostenleitplanken im Lieferprozess (Architektur-Review-Gates, die bei bedeutender neuer Infrastruktur eine Kostenmodellierung enthalten).
Praktische Governance-Mechanismen, die sich durchgehend bewähren:
- Erkennung von Kostenanomalien mit Eskalationswegen – automatische Alarme, wenn die Ausgaben eines getaggten Services einen definierten Prozentsatz über dem Basiswert liegen, geleitet an das verantwortliche Team und dessen Engineering Lead
- Kriterien des Architecture Review Board, die eine Bewertung der Kosteneffizienz für jeden neuen Service oder jede wesentliche Infrastrukturänderung oberhalb einer definierten monatlichen Ausgabenschwelle enthalten
- FinOps-Champions in jedem Produktteam – typischerweise ein Senior Engineer mit technischem und kaufmännischem Verständnis, der an teamübergreifenden FinOps-Arbeitsgruppen teilnimmt
- Monatliche Kosten-Stand-ups zwischen Engineering Leads und Finanzwesen, mit Fokus auf Trendanalyse statt auf Schuldzuweisung
Wie GTEMAS Cloud-Kosten-Governance angeht
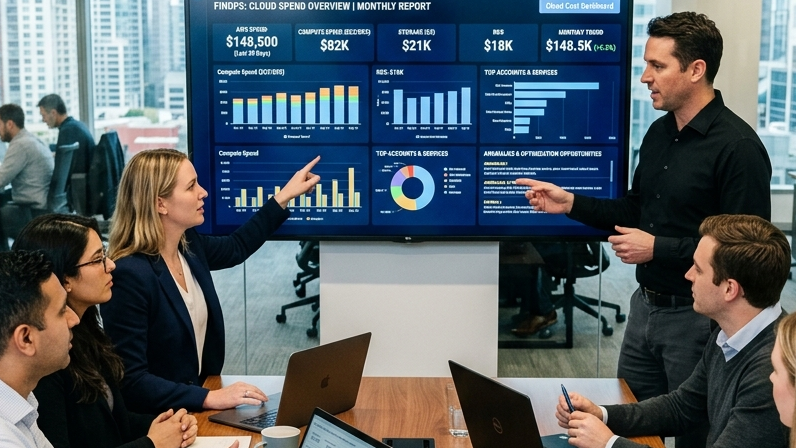
Wenn GTEMAS in ein Plattform-Engineering-Engagement einsteigt, ist die Cloud-Kosten-Governance kein separater Arbeitsstrang – sie ist von Tag eins an im Liefermodell verankert, als Teil von FastDX, unserer AI-nativen Delivery-Pipeline. Wir bauen die Durchsetzung des Taggings in jedes IaC-Modul ein, das wir beisteuern. Wir richten Showback-Dashboards als Teil der Observability-Einrichtung ein, wobei eine KI-gestützte Anomalieerkennung Kostenspitzen meldet, bevor sie in der Rechnung des nächsten Monats auftauchen. Und wir führen FinOps-Reviews als Teil der Dokumentation von Architekturentscheidungen durch.
Das Ergebnis: Kostentransparenz und Optimierungsfähigkeit wachsen mit der Plattform mit, statt später mit erheblicher Reibung nachgerüstet zu werden. Kunden sehen in den ersten zwei Quartalen des Engagements typischerweise spürbare Kostensenkungen – nicht durch dramatische Architekturänderungen, sondern durch die kumulierte Wirkung von Dutzenden kleiner Optimierungen, die sichtbar werden, sobald die Zuordnung richtig funktioniert.
Cloud-Rechnungen müssen nicht die zwangsläufige Folge von Architekturkomplexität sein. Sie sind ein Engineering-Problem, und wie die meisten Engineering-Probleme reagieren sie auf systematische Aufmerksamkeit. Wenn Ihre Organisation in einer Microservices-Umgebung mit zersplitterter Kostentransparenz zu tun hat, besprechen wir gern mit Ihnen, wie ein strukturierter FinOps-Ansatz auf Ihre Situation passen könnte.