

Le paradoxe de l’ingénierie moderne
Pendant des années, le secteur du logiciel a admis une vérité dure : « Bon, rapide, pas cher : choisissez-en deux. » Tous les chefs de projet connaissaient le triangle de fer. Tous les clients devaient choisir. La contrainte paraissait relever de la physique.
L’IA générative a brisé ce triangle – pas par magie, mais en rendant nettement moins coûteux certains types de travail. Écrire du code répétitif, générer des cas de test, rédiger la documentation d’API, échafauder des configurations d’infrastructure : ces tâches absorbaient une part importante de chaque sprint d’ingénierie. Ce n’est plus nécessaire. Résultat : les équipes peuvent livrer des logiciels de meilleure qualité, plus vite et à moindre coût – simultanément – à condition d’avoir repensé la façon dont leur processus de livraison fonctionne réellement.
Cette dernière condition compte. Acheter une licence GitHub Copilot et espérer que les développeurs se débrouilleront n’est pas une stratégie. On en tire des gains marginaux. Les organisations qui constatent des réductions de 30–50% de l’effort de livraison ont fait quelque chose de plus délibéré : elles ont repensé chaque phase de leur cycle de vie logiciel autour de workflows augmentés par l’IA. C’est ce qu’est FastDX, la chaîne d’ingénierie AI-native de GTEMAS, et voici comment elle fonctionne.
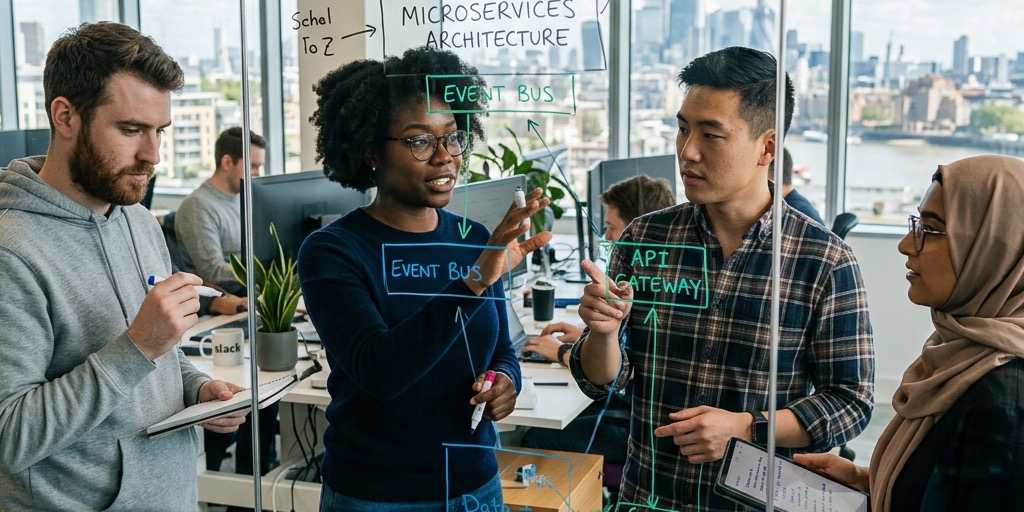
Phase 1 : Exigences et découverte (-30% d’effort)
L’approche traditionnelle : deux à quatre semaines d’ateliers. Des photos de tableau blanc que personne ne sait relire un mois plus tard. Un PRD (Product Requirements Document) que l’équipe de développement interprète autrement que l’équipe produit, laquelle l’interprète autrement que les parties prenantes métier. Le périmètre dérive, non parce que les parties prenantes changent d’avis, mais parce que les exigences n’ont jamais été assez précises pour révéler les lacunes avant que quelqu’un construise la mauvaise chose.
L’approche GTEMAS : nous instrumentons le processus de découverte lui-même. Les entretiens avec les parties prenantes sont transcrits en temps réel. Des agents LLM sur mesure analysent ces transcriptions pour générer automatiquement des user stories structurées au format Jira, avec des critères d’acceptation en syntaxe Gherkin. Les mêmes agents produisent des diagrammes de flux de processus sous forme de code Mermaid.js et réalisent une analyse des cas limites – en posant en somme les questions qu’un ingénieur QA rigoureux poserait à la fin du projet, mais avant qu’une seule ligne de code ne soit écrite.
Le livrable d’une séance de découverte n’est plus un compte rendu de réunion. C’est un ensemble d’exigences validées et structurées, que les développeurs peuvent exploiter dès la semaine même. L’ambiguïté qui serait apparue sous forme de cycle de reprise à la huitième semaine apparaît à la première, quand la corriger coûte une heure de discussion et non un sprint de réingénierie.
Sur l’ensemble de nos projets clients, cette seule phase réduit d’environ 30% les reprises liées aux exigences, et cette estimation est prudente pour les projets à logique métier complexe ou à plusieurs groupes de parties prenantes.
Phase 2 : Architecture et conception (-25% d’effort)
L’approche traditionnelle : des architectes seniors passent des jours à dessiner des schémas et à débattre de patterns. Le résultat est souvent surdimensionné par rapport aux exigences réelles, car les architectes conçoivent pour une montée en charge hypothétique plutôt que pour le système réel.
L’approche GTEMAS : nos architectes utilisent l’IA pour simuler les charges du système et modéliser les arbitrages d’architecture avant de s’engager sur des patterns. Nous alimentons notre Architecture Oracle interne avec les exigences validées – une chaîne d’outils sur mesure qui propose des schémas de base de données optimaux, des définitions d’API au format Swagger/OpenAPI et un échafaudage d’infrastructure as code en Terraform. L’architecte humain passe du rôle de « dessinateur » à celui de « relecteur et décideur », et se concentre sur les arbitrages qui demandent réellement du jugement : frontières de sécurité, souveraineté des données, complexité d’intégration et maintenabilité à long terme.
La part répétitive de l’architecture – celle qui est standard et prévisible – est traitée par l’IA. Les choix de jugement – ceux qui déterminent si le système tiendra en conditions réelles – restent aux ingénieurs expérimentés. Ce n’est pas une baisse de la rigueur architecturale. C’est une réaffectation du temps des architectes vers les décisions qui comptent.
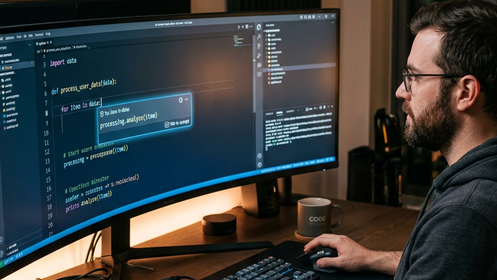
Phase 3 : Codage et implémentation (-50% d’effort)
L’approche traditionnelle : les développeurs passent environ 60% de leur temps sur du travail non créatif : chercher une syntaxe, écrire du code répétitif, déboguer des conflits de dépendances, traduire des exigences en code d’échafaudage que tout ingénieur compétent écrirait de la même façon. Les 40% restants – la résolution de problèmes proprement dite, les décisions d’architecture, la gestion des cas limites – sont là où se trouve la vraie valeur.
L’approche GTEMAS : nous mettons en œuvre des workflows de codage agentiques avec des outils comme Cursor et nos propres extensions d’IDE personnalisées, configurées avec un accès RAG à toute la base de code du projet. Cette connaissance du contexte est déterminante. Un outil de codage IA générique invente des fonctions qui n’existent pas. Notre outillage connaît la base de code, comprend les patterns établis et génère un résultat cohérent avec le système qu’il étend.
- Le code répétitif devient quasi gratuit : API CRUD, flux d’authentification, composants d’interface, scripts de migration de base de données – générés en quelques secondes, relus par un ingénieur en quelques minutes.
- Des builds qui se corrigent : quand un build échoue, l’IA analyse la stack trace et propose une action corrective avant que le développeur ait fini de lire le message d’erreur. Pour la majorité des modes de défaillance courants, les cycles de débogage passent de quelques heures à quelques minutes.
- Un style de code cohérent : le code généré par l’IA suit les patterns établis du projet, ce qui allège la charge cognitive de la revue de code et garde la base de code cohérente à mesure qu’elle grandit.
Au final, les développeurs consacrent leur temps aux 40% du métier qui exigeaient leur expertise à l’origine – et ils le font sans les changements de contexte permanents qu’impose le travail répétitif.
Phase 4 : Assurance qualité (-40% d’effort)
L’approche traditionnelle : la QA est un goulot d’étranglement en fin de sprint. Les cas de test sont écrits à la main, souvent par des ingénieurs qui jonglent déjà entre plusieurs tickets. La couverture est irrégulière, des cas limites sont oubliés, et les tests de non-régression sont un processus manuel que la pression du calendrier fait sauter.
L’approche GTEMAS : nous pratiquons la Test-Driven Generation. L’IA génère les tests unitaires avant que le code ne soit écrit, à partir des exigences acceptées et des signatures de fonctions définies pendant la phase d’architecture. Pour les tests d’intégration et de bout en bout, des agents IA parcourent l’interface, identifient les parcours d’interaction et génèrent automatiquement des scripts de test Playwright et Cypress. Les tests de régression visuelle sont intégrés – une comparaison de captures d’écran à chaque build, et pas seulement sur les versions candidates.
Résultat : nous atteignons par défaut plus de 90% de couverture de tests, et non comme un objectif ambitieux. Plus important encore, cette couverture est maintenue à mesure que la base de code évolue, car la génération de tests est automatisée et tourne en continu au lieu d’être un effort ponctuel lié à la construction initiale.
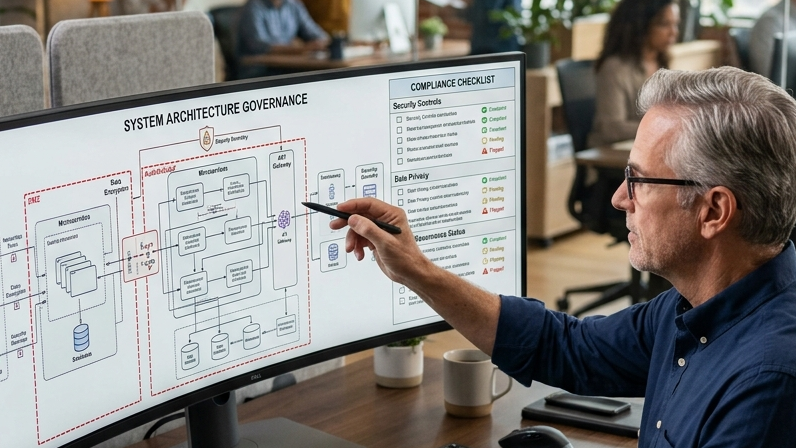
Phase 5 : Documentation et passation (effort supplémentaire quasi nul)
L’approche traditionnelle : la documentation est toujours obsolète. Les ingénieurs l’écrivent à la fin d’un projet, quand ils sont déjà mentalement passés au suivant. On obtient une documentation qui décrit ce que le système devait faire, pas ce qu’il fait réellement. Les séances de passation sont longues et laissent quand même des lacunes de connaissance.
L’approche GTEMAS : la documentation est un sous-produit continu du processus de développement, et non une phase distincte. Des agents IA surveillent les commits git et mettent automatiquement à jour le README, la documentation d’API et les changelogs à mesure que la base de code évolue. Quand la signature d’une fonction change, la documentation le reflète dans le même commit. Quand un nouvel endpoint est ajouté, il apparaît dans la documentation Swagger sans intervention manuelle.
À la passation d’un projet, les clients reçoivent une base de connaissances vivante qui reflète l’état actuel du système – et non un PDF périmé issu de la phase de conception initiale. Cela réduit sensiblement le temps d’onboarding des équipes internes qui reprennent la base de code, ainsi que la charge de support pesant sur GTEMAS pendant la période de transition.
L’impact business : ce que cela donne concrètement
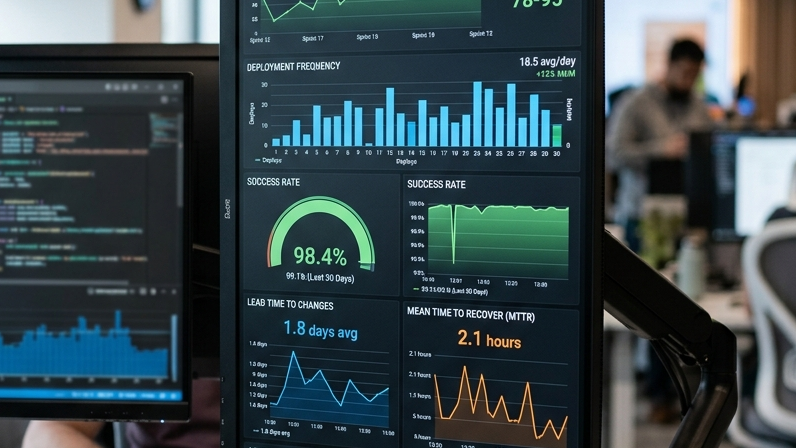
Les gains d’efficacité de chaque phase se cumulent. Une réduction de 30% de l’effort sur les exigences et de 50% sur le codage ne donne pas simplement une réduction moyenne de 40% de la durée totale du projet. Les effets s’enchaînent : des exigences plus nettes signifient moins de cycles de reprise au codage ; des tests automatisés signifient moins de défauts à diagnostiquer en QA ; une documentation continue signifie des passations plus courtes.
Pour les clients, cela se traduit par trois résultats concrets :
- Un time-to-market plus court : des projets qui demandaient auparavant six mois atteignent régulièrement une première mise en production en trois à quatre mois. Des MVP qui demandaient huit semaines peuvent arriver aux tests utilisateurs en deux à trois semaines. La boucle de retours avec de vrais utilisateurs s’accélère, ce qui améliore la qualité du produit final.
- Un coût total de possession plus bas : le code généré par l’IA, qui passe des tests automatisés et qui est produit par des ingénieurs seniors comprenant ce qu’ils relisent, a des taux de défauts démontrablement plus faibles. Moins de dette technique s’accumule. Le système coûte moins cher à maintenir deux ans après la livraison qu’un système construit de façon traditionnelle.
- Une mission d’ingénierie à plus forte valeur : les clients paient pour la réflexion d’architecture, l’expertise du domaine métier et les décisions de jugement qui déterminent si un système tiendra en conditions réelles. Ils ne paient pas pour de la frappe de syntaxe. Le modèle de facturation le reflète : nous cadrons par livrable et par résultat, et non par heures travaillées.
FastDX dans votre organisation
FastDX n’est pas un outil unique. C’est une méthodologie et, comme toute méthodologie, sa valeur vient d’une application cohérente sur tout le cycle de livraison, et non du choix des seules parties faciles à adopter. Les organisations qui mettent en place un outillage IA à la phase de codage sans réformer leurs processus d’exigences et de QA n’obtiennent qu’une fraction des gains possibles.
GTEMAS applique ce cadre dans ses missions clients, en l’adaptant à la stack technologique, à la structure d’équipe et aux exigences de gouvernance de chaque organisation. Pour les clients des secteurs réglementés, cela inclut les pistes d’audit et la documentation de revue que les cadres de conformité exigent. Pour les clients qui exploitent de grandes bases de code existantes, cela inclut l’indexation de la base de code et la configuration RAG qui rendent les résultats de l’IA pertinents et précis plutôt que génériques.
Si votre organisation cherche comment intégrer l’IA à sa pratique de développement – au-delà du niveau « acheter des licences Copilot » – nous pouvons mener une évaluation structurée de votre SDLC actuel et identifier où se trouvent les interventions à plus fort impact. Contactez l’équipe GTEMAS pour engager cette discussion.