

现代工程的悖论
多年来,软件行业接受了一个硬道理:“好、快、省,三选二。”每个项目经理都知道这个铁三角,每个客户都被告知要做选择。这个约束感觉像是物理定律。
生成式 AI 打破了这个三角,不是靠魔法,而是让特定类型的工作变得便宜得多。编写样板代码、生成测试用例、起草 API 文档、搭建基础设施配置的脚手架:这些任务过去占用每个工程 Sprint 的相当一部分时间,现在不必再这样了。结果是,只要重新设计了交付流程的实际运作方式,团队就能同时做到更高质量、更快、更具成本效益地交付软件。
最后这个条件很重要。买一份 GitHub Copilot 许可证,然后指望开发者自己摸索,不是策略,只能带来微小的收益。看到交付工作量减少 30–50% 的组织,做了更有章法的事:围绕 AI 增强的工作流,重新设计了软件生命周期的每个阶段。GTEMAS 的 AI-Native Delivery 流水线 FastDX 做的正是这件事,其运作方式如下。
第 1 阶段:需求与探索(工作量 -30%)
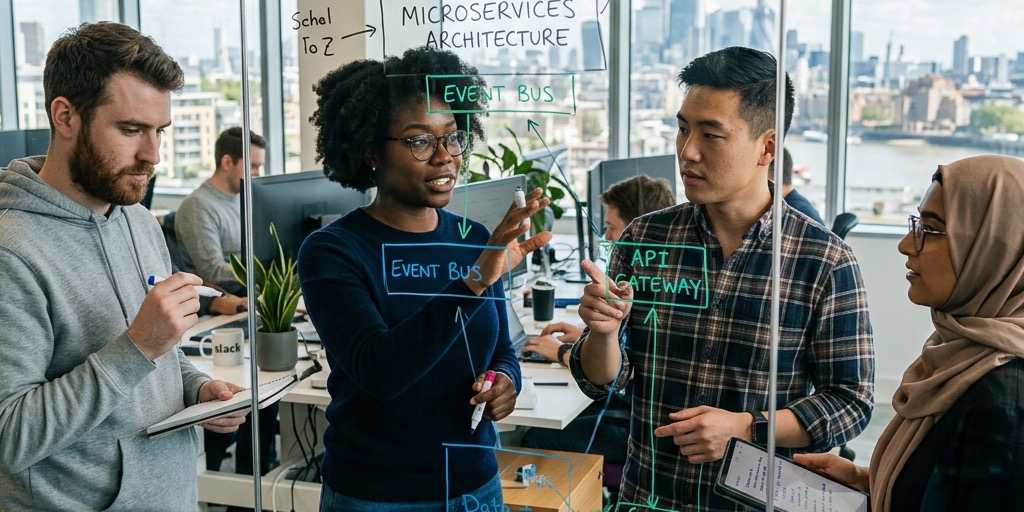
传统做法:两到四周的工作坊。一个月后没人看得清的白板照片。一份 PRD(产品需求文档),开发团队的理解与产品团队不同,产品团队的理解又与业务相关方不同。范围蔓延的出现,不是因为相关方改了主意,而是因为需求从来不够精确,直到有人做错了东西,缺口才暴露出来。
GTEMAS 的做法:我们为探索过程本身配备工具。相关方访谈实时转录。定制的 LLM 智能体解析这些转录稿,自动生成 Jira 格式的结构化用户故事,并附上 Gherkin 语法的验收标准。同样的智能体以 Mermaid.js 代码生成流程图,并做边界情况分析,本质上是提前问出一位细致的 QA 工程师在项目末期才会问的问题,只是在写下第一行代码之前就问了。
探索会议的产出不再是一份会议纪要,而是一套经过验证、结构化的需求,开发者当周就可以据此行动。原本会在第八周以返工周期的形式暴露的含糊之处,改在第一周暴露,此时修正的成本是一小时的交谈,而不是一个 Sprint 的重新设计。
在我们的客户项目中,仅这一阶段就能把与需求相关的返工减少约 30%,对于业务逻辑复杂或有多个相关方群体的项目,这个估计是保守的。
第 2 阶段:架构与设计(工作量 -25%)
传统做法:资深架构师花数天画图、争论模式。产出相对于实际需求往往过度设计,因为架构师是在为假设中的规模设计,而不是为实际的系统设计。
GTEMAS 的做法:我们的架构师在确定模式之前,用 AI 模拟系统负载,并对架构取舍建模。我们把经过验证的需求输入内部的 Architecture Oracle,这是一套定制工具链,可建议最优的数据库模式、Swagger/OpenAPI 格式的 API 定义,以及 Terraform 的基础设施即代码脚手架。人类架构师从“绘图者”转为“评审者和决策者”,专注于真正需要判断的取舍:安全边界、数据主权、集成复杂度和长期可维护性。
架构中的样板部分,即标准且可预测的部分,由 AI 处理。判断性的决定,即决定系统能否在真实条件下站得住的部分,仍由经验丰富的工程师负责。这并不是降低架构的严谨度,而是把架构师的时间重新分配到真正重要的决策上。
第 3 阶段:编码与实现(工作量 -50%)
传统做法:开发者约 60% 的时间花在非创造性的工作上:查语法、写样板代码、调试依赖冲突、把需求翻译成任何称职工程师都会写成同样样子的脚手架代码。剩下的 40%,即真正的问题解决、架构决策和边界情况处理,才是真正价值所在。
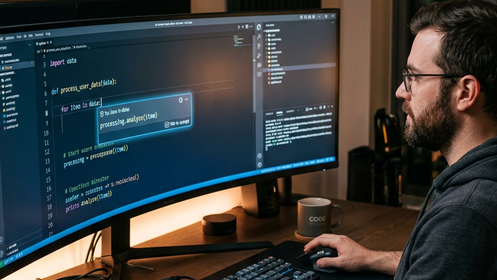
GTEMAS 的做法:我们用 Cursor 和我们自己定制的 IDE 扩展等工具来实施智能体编码工作流,并配置了对项目完整代码库的 RAG 访问。这种对上下文的感知至关重要。通用的 AI 编码工具会虚构出并不存在的函数。我们的工具了解代码库,理解已确立的模式,生成的产出与它所扩展的系统保持一致。
- 样板代码几乎免费:CRUD API、认证流程、UI 组件、数据库迁移脚本,几秒钟生成,工程师几分钟评审完。
- 自我纠正的构建:构建失败时,AI 会分析堆栈跟踪,在开发者读完错误信息之前就建议纠正措施。对大多数常见的失败模式,调试周期从数小时压缩到数分钟。
- 一致的代码风格:AI 生成的代码遵循项目已确立的模式,这减轻了代码评审的认知负担,也让代码库在增长时保持连贯。
净效果是,开发者把时间花在这份工作中原本就需要他们专业能力的那 40% 上,而且不再受样板工作造成的不断切换上下文的干扰。
第 4 阶段:质量保证(工作量 -40%)
传统做法:QA 是 Sprint 末尾的瓶颈。测试用例靠手工编写,往往由已在多张工单之间切换上下文的工程师来写。覆盖率不一致,边界情况被漏掉,回归测试靠手工,在进度压力下被跳过。
GTEMAS 的做法:我们实践测试驱动生成(Test-Driven Generation)。AI 在代码编写之前,依据已接受的需求和架构阶段定义的函数签名生成单元测试。对于集成测试和端到端测试,AI 智能体遍历 UI,识别交互流程,并自动生成 Playwright 和 Cypress 测试脚本。内置视觉回归测试:每次构建都做截图对比,而不只是针对候选发布版本。
结果是,我们默认就能达到 90% 以上的测试覆盖率,而不是作为一个争取的目标。更重要的是,随着代码库的演进,这一覆盖率能够保持,因为测试生成过程是自动化的、持续运行的,而不是与最初构建绑定的一次性工作。
第 5 阶段:文档与交接(增量工作量接近于零)
传统做法:文档总是过时的。工程师在项目结束时才写,此时他们心思已经转到下一个项目。结果是,文档描述的是系统本应做什么,而不是实际做什么。交接会议冗长,仍然留下知识缺口。
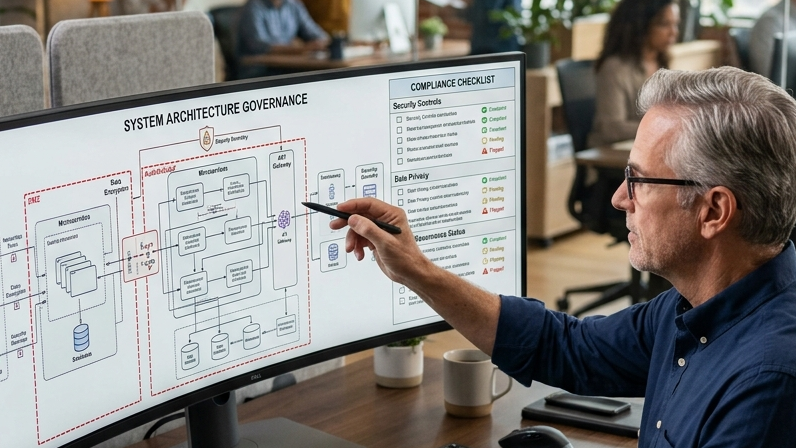
GTEMAS 的做法:文档是开发过程持续产生的副产品,而不是一个单独的阶段。AI 智能体监控 git 提交,并随着代码库的演进自动更新 README、API 文档和变更日志。函数签名变化时,文档在同一次提交中就反映出来。新增端点时,它无需人工干预就出现在 Swagger 文档中。
项目交接时,客户拿到的是一个反映系统当前状态的活的知识库,而不是设计阶段遗留下来的过期 PDF。这实质性地缩短了接手代码库的内部团队的上手时间,也减轻了过渡期间 GTEMAS 的支持负担。
业务影响:这在实践中意味着什么
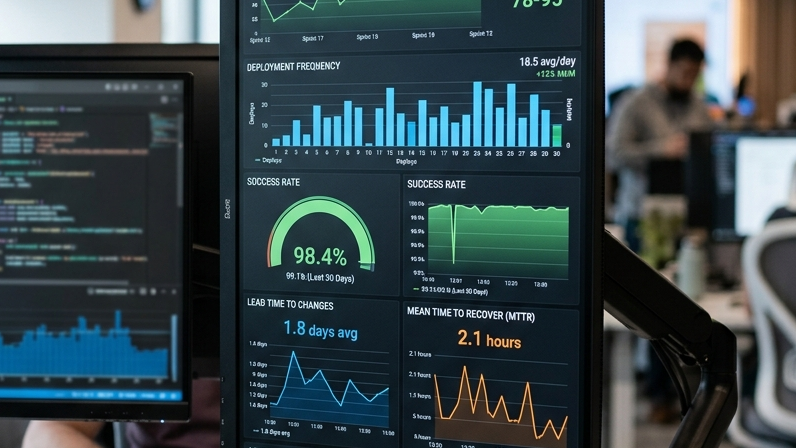
各阶段的效率提升会叠加。需求工作量减少 30%、编码工作量减少 50%,并不会简单地平均成项目总工期减少 40%。它们相互作用:更清晰的需求意味着编码中更少的返工周期;自动化测试意味着 QA 中更少需要诊断的缺陷;持续更新的文档意味着更短的交接。
对客户来说,这转化为三项具体成果:
- 更快上市:过去需要六个月的项目,经常在三到四个月内达到首次投产。过去需要八周的 MVP,可以在两到三周内进入用户测试。与真实用户的反馈循环加快,提高了最终产品的质量。
- 更低的总拥有成本:AI 生成的代码如果通过了自动化测试,又出自理解自己所评审内容的资深工程师之手,其缺陷率已被证明更低。积累的技术债更少。交付两年后,这样的系统比用传统方式构建的系统维护起来更便宜。
- 更高价值的工程合作:客户为架构思维、业务领域专业能力,以及决定系统能否在真实条件下表现良好的判断付费,而不是为敲语法付费。计费模式反映了这一点:我们按交付物和成果来界定范围,而不是按工时。
FastDX 在您的组织中
FastDX 不是单一工具,而是一种方法论。与任何方法论一样,它的价值来自在整个交付生命周期中一致地应用,而不是只挑容易采用的部分。在编码阶段采用 AI 工具、却不改革需求和 QA 流程的组织,只能获得可得收益的一小部分。
GTEMAS 在客户合作中应用这一框架,并根据每个组织具体的技术栈、团队结构和治理要求加以调整。对于受监管行业的客户,这包括合规框架要求的审计轨迹和评审文档。对于运行大型现有代码库的客户,这包括代码库索引和 RAG 配置,使 AI 的产出相关且准确,而不是泛泛而谈。
如果您的组织正在评估如何把 AI 融入开发实践,而不只是停留在“购买 Copilot 许可证”这个层面,我们可以对您当前的 SDLC 做一次结构化评估,找出影响最大的干预点。欢迎联系 GTEMAS 团队,开始这段对话。