

Das Paradox des modernen Engineering
Jahrelang akzeptierte die Softwarebranche eine harte Wahrheit: „Gut, schnell, günstig – wählen Sie zwei.“ Jeder Projektmanager kannte das magische Dreieck. Jedem Kunden wurde gesagt, er müsse wählen. Die Beschränkung fühlte sich an wie ein Naturgesetz.
Generative KI hat dieses Dreieck aufgebrochen, nicht durch Magie, sondern weil bestimmte Arten von Arbeit drastisch günstiger geworden sind. Boilerplate-Code schreiben, Testfälle erzeugen, API-Dokumentation entwerfen, Infrastrukturkonfigurationen aufsetzen: Diese Aufgaben beanspruchten früher einen erheblichen Teil jedes Engineering-Sprints. Das ist nicht mehr nötig. Das Ergebnis ist, dass Teams hochwertigere Software schneller und kostengünstiger liefern können, und zwar gleichzeitig, wenn sie neu gestaltet haben, wie ihr Delivery-Prozess tatsächlich funktioniert.
Diese letzte Bedingung ist wichtig. Eine GitHub-Copilot-Lizenz zu kaufen und zu hoffen, dass die Entwickler es schon herausfinden, ist keine Strategie. Es bringt marginale Gewinne. Die Organisationen, die den Lieferaufwand um 30–50% senken, haben etwas Gezielteres getan: Sie haben jede Phase ihres Softwarelebenszyklus um KI-gestützte Workflows herum neu aufgebaut. Das ist FastDX, die AI-native Delivery-Pipeline von GTEMAS, und so funktioniert sie.
Phase 1: Anforderungen und Discovery (-30% Aufwand)
Der klassische Ansatz: Zwei bis vier Wochen Workshops. Whiteboard-Fotos, die einen Monat später niemand mehr lesen kann. Ein PRD (Product Requirements Document), das das Entwicklungsteam anders auslegt als das Produktteam, das es wiederum anders auslegt als die Fachbereiche. Scope Creep entsteht nicht, weil Stakeholder ihre Meinung ändern, sondern weil die Anforderungen nie präzise genug waren, um die Lücken zu zeigen, bis jemand das Falsche gebaut hat.
Der GTEMAS-Ansatz: Wir instrumentieren den Discovery-Prozess selbst. Stakeholder-Interviews werden in Echtzeit transkribiert. Eigene LLM-Agenten werten diese Transkripte aus und erzeugen automatisch strukturierte User Stories im Jira-Format, samt Akzeptanzkriterien in Gherkin-Syntax. Dieselben Agenten erstellen Prozessdiagramme als Mermaid.js-Code und führen eine Analyse von Sonderfällen durch. Im Kern stellen sie die Fragen, die ein gründlicher QA Engineer am Projektende stellen würde, aber bevor eine einzige Zeile Code geschrieben ist.
Das Ergebnis einer Discovery-Session ist keine Gesprächszusammenfassung mehr. Es ist ein validierter, strukturierter Satz von Anforderungen, mit dem Entwickler noch in derselben Woche arbeiten können. Unklarheiten, die sonst in Woche acht als Nacharbeitszyklus aufgetaucht wären, zeigen sich stattdessen in Woche eins, wenn die Korrektur eine Stunde Gespräch kostet und keinen Sprint Umbau.
Über unsere Kundenprojekte hinweg senkt allein diese Phase die anforderungsbedingte Nacharbeit um etwa 30%, und diese Schätzung ist für Projekte mit komplexer Geschäftslogik oder mehreren Stakeholder-Gruppen konservativ.
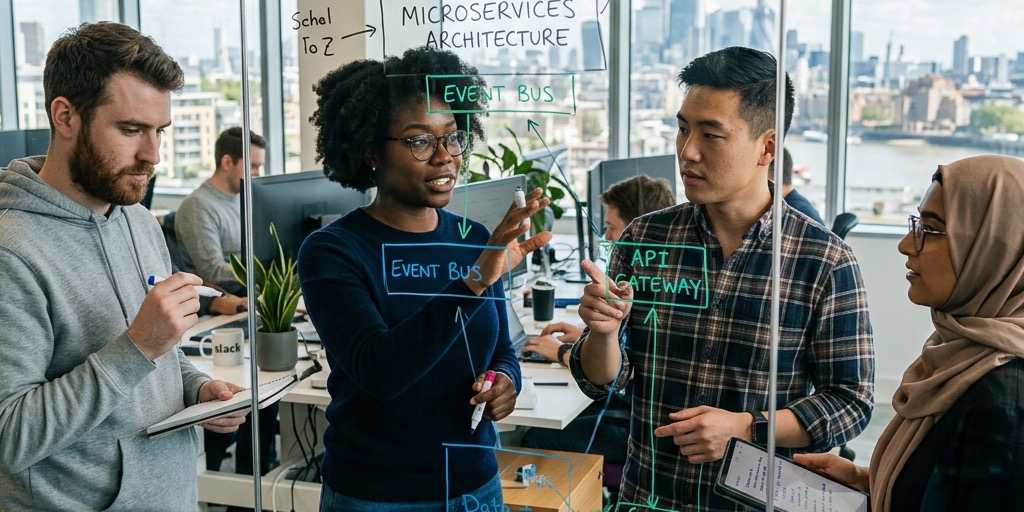
Phase 2: Architektur und Design (-25% Aufwand)
Der klassische Ansatz: Senior-Architekten verbringen Tage damit, Diagramme zu zeichnen und über Muster zu streiten. Das Ergebnis ist im Verhältnis zu den tatsächlichen Anforderungen oft überdimensioniert, weil Architekten für hypothetische Skalierung entwerfen und nicht für das tatsächliche System.
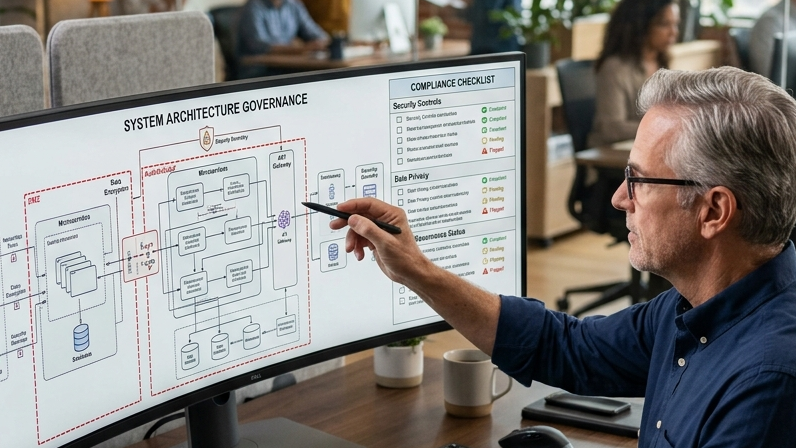
Der GTEMAS-Ansatz: Unsere Architekten nutzen KI, um Systemlasten zu simulieren und architektonische Abwägungen zu modellieren, bevor sie sich auf Muster festlegen. Wir geben validierte Anforderungen in unser internes Architecture Oracle ein, eine eigene Toolchain, die optimale Datenbankschemata, API-Definitionen im Swagger/OpenAPI-Format und Infrastructure-as-Code-Gerüste in Terraform vorschlägt. Der menschliche Architekt wechselt vom „Zeichner“ zum „Prüfer und Entscheider“ und konzentriert sich auf die Abwägungen, die wirklich Urteilsvermögen erfordern: Sicherheitsgrenzen, Datensouveränität, Integrationskomplexität und langfristige Wartbarkeit.
Den Boilerplate-Anteil der Architektur, also den Teil, der standardisiert und vorhersehbar ist, übernimmt die KI. Die Ermessensentscheidungen, also der Teil, der darüber entscheidet, ob das System unter realen Bedingungen standhält, bleiben bei erfahrenen Ingenieuren. Das senkt nicht die architektonische Sorgfalt. Es verlagert die Zeit der Architekten hin zu den Entscheidungen, auf die es ankommt.
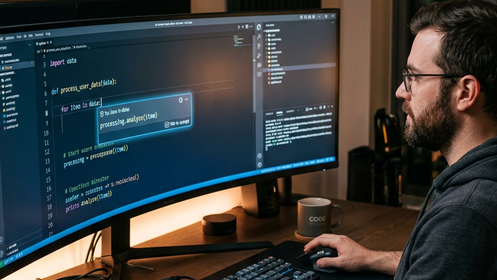
Phase 3: Coding und Implementierung (-50% Aufwand)
Der klassische Ansatz: Entwickler verbringen etwa 60% ihrer Zeit mit nicht kreativer Arbeit: Syntax nachschlagen, Boilerplate schreiben, Konflikte bei Abhängigkeiten debuggen und Anforderungen in Gerüstcode übersetzen, den jeder kompetente Ingenieur genauso schreiben würde. Die verbleibenden 40%, also das eigentliche Problemlösen, die architektonischen Entscheidungen und der Umgang mit Sonderfällen, sind der Teil mit dem eigentlichen Wert.
Der GTEMAS-Ansatz: Wir setzen agentische Coding-Workflows mit Tools wie Cursor und unseren eigenen angepassten IDE-Erweiterungen um, konfiguriert mit RAG-Zugriff auf die gesamte Codebasis des Projekts. Dieses Kontextwissen ist entscheidend. Ein generisches KI-Coding-Tool halluziniert Funktionen, die es nicht gibt. Unser Tooling kennt die Codebasis, versteht die etablierten Muster und erzeugt Ergebnisse, die zum System passen, das es erweitert.
- Boilerplate ist fast kostenlos: CRUD-APIs, Authentifizierungsabläufe, UI-Komponenten, Skripte für Datenbankmigrationen: in Sekunden erzeugt, von einem Ingenieur in Minuten geprüft.
- Selbstkorrigierende Builds: Schlägt ein Build fehl, analysiert die KI den Stack Trace und schlägt eine Korrektur vor, noch bevor der Entwickler die Fehlermeldung zu Ende gelesen hat. Debugging-Zyklen schrumpfen bei den meisten häufigen Fehlerarten von Stunden auf Minuten.
- Einheitlicher Code-Stil: KI-generierter Code folgt den etablierten Mustern des Projekts. Das verringert die kognitive Belastung beim Code-Review und hält die Codebasis beim Wachsen konsistent.
Unterm Strich verbringen Entwickler ihre Zeit mit den 40% der Arbeit, die ihre Expertise ohnehin erforderten, und sie tun das ohne den ständigen Kontextwechsel, den Boilerplate-Arbeit mit sich bringt.
Phase 4: Qualitätssicherung (-40% Aufwand)
Der klassische Ansatz: Die QA ist ein Engpass am Ende des Sprints. Testfälle werden von Hand geschrieben, oft von Ingenieuren, die ohnehin zwischen mehreren Tickets wechseln. Die Abdeckung ist uneinheitlich, Sonderfälle werden übersehen, und Regressionstests sind ein manueller Prozess, der unter Termindruck ausfällt.
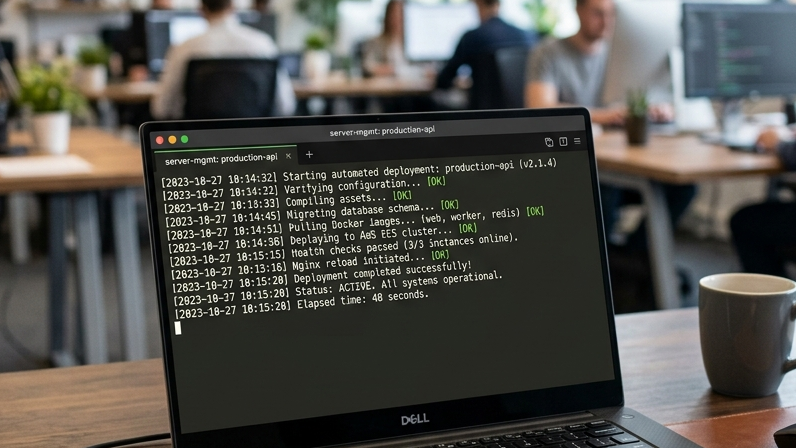
Der GTEMAS-Ansatz: Wir praktizieren Test-Driven Generation. Die KI erzeugt Unit-Tests, bevor der Code geschrieben wird, auf Grundlage der akzeptierten Anforderungen und der in der Architekturphase festgelegten Funktionssignaturen. Für Integrations- und End-to-End-Tests durchsuchen KI-Agenten die Oberfläche, erkennen Interaktionsabläufe und erzeugen automatisch Testskripte für Playwright und Cypress. Visuelle Regressionstests sind eingebaut: ein Screenshot-Vergleich bei jedem Build, nicht nur bei Release Candidates.
So erreichen wir standardmäßig mehr als 90% Testabdeckung, nicht als Ehrgeizziel. Wichtiger noch: Diese Abdeckung bleibt erhalten, während sich die Codebasis weiterentwickelt, weil die Testgenerierung automatisiert ist und laufend arbeitet, statt ein einmaliger Aufwand beim ersten Build zu sein.
Phase 5: Dokumentation und Übergabe (nahezu kein zusätzlicher Aufwand)
Der klassische Ansatz: Dokumentation ist immer veraltet. Ingenieure schreiben sie am Projektende, wenn sie mit den Gedanken schon beim nächsten Projekt sind. Das Ergebnis ist eine Dokumentation, die beschreibt, was das System tun sollte, und nicht, was es tatsächlich tut. Übergabesitzungen sind lang und lassen trotzdem Wissenslücken.
Der GTEMAS-Ansatz: Dokumentation ist ein laufendes Nebenprodukt des Entwicklungsprozesses und keine eigene Phase. KI-Agenten beobachten Git-Commits und aktualisieren README, API-Dokumentation und Changelogs automatisch, während sich die Codebasis weiterentwickelt. Ändert sich eine Funktionssignatur, spiegelt die Dokumentation das im selben Commit wider. Wird ein neuer Endpunkt hinzugefügt, erscheint er ohne manuellen Eingriff in der Swagger-Dokumentation.
Bei der Übergabe eines Projekts erhalten Kunden eine lebende Wissensbasis, die den aktuellen Zustand des Systems abbildet, kein veraltetes PDF aus der ursprünglichen Designphase. Das verkürzt die Einarbeitungszeit interner Teams, die die Codebasis übernehmen, deutlich und senkt den Unterstützungsaufwand für GTEMAS in der Übergangszeit.
Die Wirkung auf das Geschäft: Was das in der Praxis bedeutet
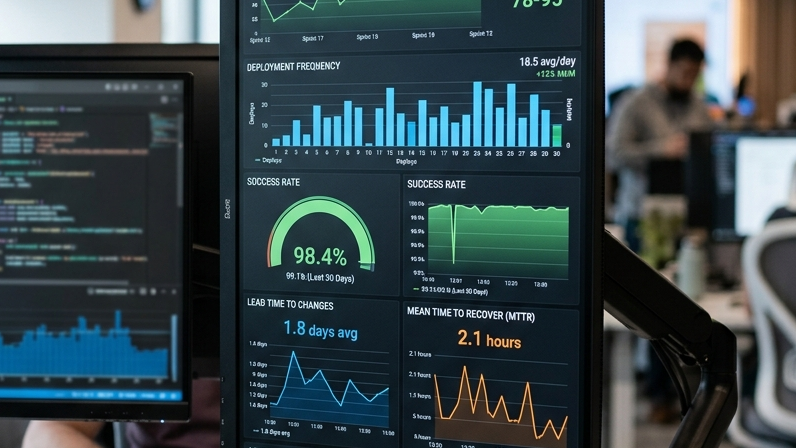
Die Effizienzgewinne der einzelnen Phasen verstärken sich. Eine Senkung des Anforderungsaufwands um 30% und des Coding-Aufwands um 50% ergeben nicht einfach im Mittel eine Verkürzung der gesamten Projektdauer um 40%. Sie wirken zusammen: Sauberere Anforderungen bedeuten weniger Nacharbeitszyklen im Coding, automatisierte Tests bedeuten weniger Fehler, die in der QA zu diagnostizieren sind, und laufende Dokumentation bedeutet kürzere Übergaben.
Für Kunden ergeben sich daraus drei konkrete Ergebnisse:
- Kürzere Time-to-Market: Projekte, die früher sechs Monate brauchten, erreichen regelmäßig in drei bis vier den ersten Produktivbetrieb. MVPs, die früher acht Wochen brauchten, können in zwei bis drei Wochen den Nutzertest erreichen. Die Feedbackschleife mit echten Nutzern wird schneller, was die Qualität des Endprodukts verbessert.
- Niedrigere Gesamtbetriebskosten: KI-generierter Code, der automatisierte Tests besteht und von Senior Engineers erstellt wird, die verstehen, was sie prüfen, hat nachweislich niedrigere Fehlerraten. Es sammelt sich weniger technische Schuld an. Das System ist zwei Jahre nach der Lieferung günstiger zu warten als ein auf klassische Weise gebautes.
- Hochwertigere Engineering-Zusammenarbeit: Kunden bezahlen für architektonisches Denken, Fachexpertise und die Ermessensentscheidungen, die darüber bestimmen, ob ein System unter realen Bedingungen besteht. Sie bezahlen nicht für das Tippen von Syntax. Das Abrechnungsmodell spiegelt das wider: Wir kalkulieren nach Liefergegenstand und Ergebnis, nicht nach geleisteten Stunden.
FastDX in Ihrer Organisation
FastDX ist kein einzelnes Tool. Es ist eine Methodik, und wie jede Methodik entfaltet sie ihren Wert durch konsequente Anwendung über den gesamten Delivery-Lebenszyklus und nicht dadurch, dass man sich die leicht einführbaren Teile herauspickt. Organisationen, die KI-Tooling in der Coding-Phase einführen, ohne ihre Anforderungs- und QA-Prozesse zu reformieren, holen nur einen Bruchteil der möglichen Gewinne heraus.
GTEMAS wendet dieses Framework in allen Kundenprojekten an und passt es an Technologie-Stack, Teamstruktur und Governance-Anforderungen der jeweiligen Organisation an. Für Kunden in regulierten Branchen gehören dazu die Audit-Trails und Prüfdokumentation, die Compliance-Rahmenwerke verlangen. Für Kunden mit großen bestehenden Codebasen gehören dazu die Indexierung der Codebasis und die RAG-Konfiguration, die KI-Ergebnisse relevant und präzise statt generisch machen.
Wenn Ihre Organisation prüft, wie sie KI in ihre Entwicklungspraxis integrieren kann, über die Stufe „Copilot-Lizenzen kaufen“ hinaus, können wir eine strukturierte Bewertung Ihres aktuellen SDLC durchführen und feststellen, wo die wirksamsten Eingriffe liegen. Wenden Sie sich an das GTEMAS-Team, um dieses Gespräch zu beginnen.