

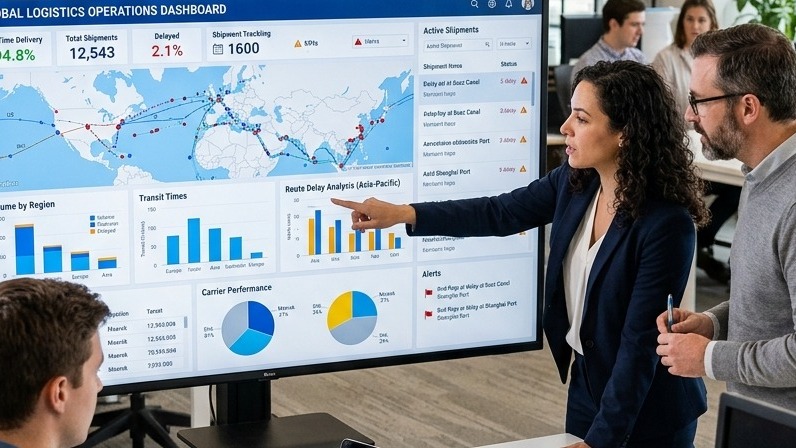
Des tableaux de bord ne donnent pas de visibilité
La plupart des équipes d’exploitation de la supply chain disposent de tableaux de bord. Ils montrent les niveaux de stock, l’état des expéditions, le débit des entrepôts et les taux d’exécution des commandes. Les plus élaborés ajoutent des alertes quand des indicateurs franchissent des seuils. Cette infrastructure est utile, mais elle décrit ce qui s’est déjà produit. C’est un rétroviseur muni d’étiquettes de données.
Un jumeau numérique est fondamentalement autre chose : un modèle de calcul vivant de la supply chain physique, qui reflète l’état actuel et peut être interrogé sur des états futurs. La distinction compte plus qu’il n’y paraît. Un tableau de bord vous indique que votre centre de distribution de Singapour a 12 jours de stock pour le produit SKU-4471. Un jumeau numérique vous permet de demander : « Si le porte-conteneurs en provenance de Guangzhou a 8 jours de retard et que la demande augmente de 15% à cause de la promotion à venir, quand arrivons-nous à la rupture de stock, quelles options d’acheminement alternatives l’évitent, et à quel coût ? »
C’est le passage d’une exploitation réactive à une exploitation prédictive. Et ce n’est pas une aspiration théorique : les organisations qui ont construit de véritables capacités de jumeau numérique pour leur supply chain font état de réductions notables des coûts de détention des stocks (voir les chiffres d’optimisation des stocks plus bas), d’une amélioration des performances de livraison dans les délais et de temps de réaction considérablement plus courts lorsque surviennent des perturbations. La technologie nécessaire existe désormais à l’échelle de l’entreprise, et les schémas d’intégration de l’IoT et de l’ERP sont assez mûrs pour être reproductibles.
L’architecture de capteurs IoT qui rend tout cela réel
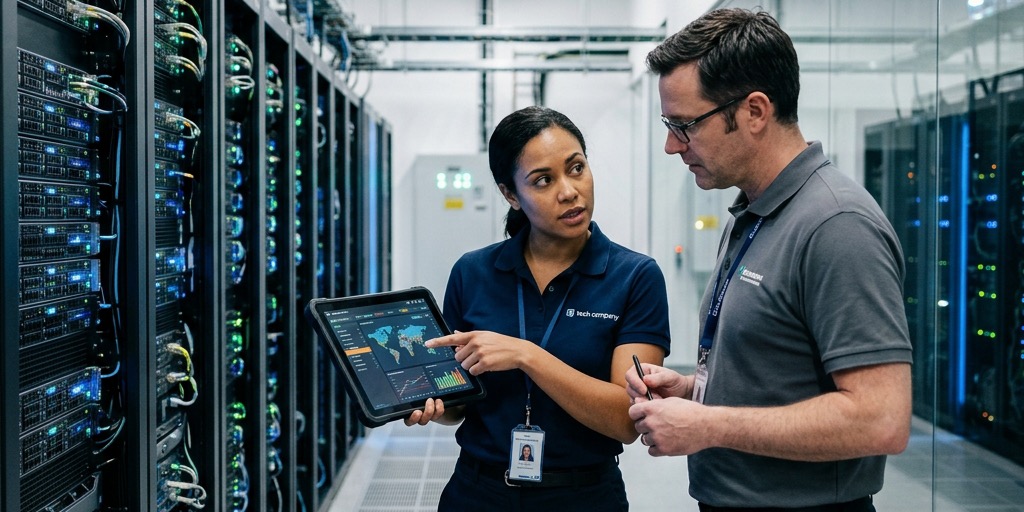
Un jumeau numérique n’est précis que si ses flux de données le sont. Pour les applications de supply chain, les principales sources de données sont les capteurs IoT déployés dans le réseau logistique physique : capteurs au sol dans les entrepôts qui suivent l’emplacement et les mouvements des stocks, capteurs de température et d’humidité pour la logistique de la chaîne du froid, traceurs GPS sur les véhicules et les conteneurs, capteurs de poids sur les quais de chargement et lecteurs RFID aux entrées et sorties des sites.
Le défi d’ingénierie ne vient pas des capteurs eux-mêmes : le matériel IoT courant est relativement bon marché et fiable. Le défi, c’est le pipeline de données entre le capteur et le modèle. Une opération de supply chain de taille moyenne peut générer de 500 000 à 2 millions d’événements de capteurs par jour. Ces données doivent être ingérées en quasi temps réel, normalisées à partir des formats variés qu’utilisent les différents fabricants de capteurs, contrôlées en qualité (des capteurs tombent en panne, des connexions sont coupées, des anomalies de données apparaissent) et injectées dans le modèle assez vite pour que son état reflète réellement la réalité physique.
L’architecture qui traite cela à grande échelle comprend généralement :
- Un traitement en périphérie (edge). Filtrer et agréger les données brutes des capteurs au niveau du site, avant qu’elles n’atteignent les systèmes centraux, réduit le volume de données de 70–80% et évite que des problèmes de connectivité sur un site isolé se propagent dans le modèle central sous forme de trous dans les données.
- Une infrastructure de streaming d’événements. Apache Kafka ou AWS Kinesis pour gérer le volume et la vitesse des événements de capteurs normalisés, avec les garanties de durabilité qu’exigent les systèmes opérationnels.
- Une couche de gestion d’état. Une base de données de séries temporelles (InfluxDB, TimescaleDB ou AWS Timestream) conserve l’état actuel et l’historique de chaque entité de la supply chain (unités de stock, véhicules, sites, expéditions), que le modèle de jumeau numérique interroge.
- Un pont d’intégration avec l’ERP. Une intégration bidirectionnelle avec le système ERP (SAP, Oracle ou équivalent) qui maintient les enregistrements transactionnels (commandes d’achat, écritures de stock, contrats logistiques) synchronisés avec l’état opérationnel que remontent les capteurs IoT.
L’intégration ERP : la partie la plus difficile
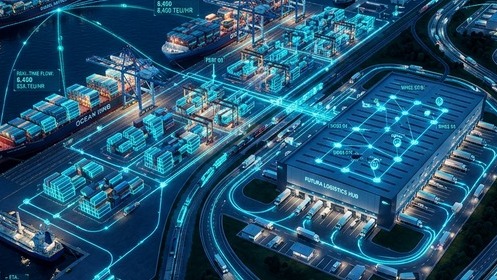
L’architecture IoT, bien que complexe, relève largement d’un terrain vierge : vous construisez de nouveaux systèmes sur une infrastructure moderne. L’intégration ERP est l’endroit où la plupart des projets de jumeau numérique rencontrent leurs frictions les plus sérieuses, car les systèmes ERP ont été conçus pour l’exactitude transactionnelle, pas pour la visibilité opérationnelle en temps réel.
SAP ECC, par exemple, traite les transactions par mises à jour par lots et tient ses enregistrements à un niveau d’abstraction qui ne correspond pas directement aux événements physiques. Un ajustement de stock dans SAP est une écriture comptable, pas nécessairement un mouvement physique en temps réel. L’écart entre ce que dit l’ERP et ce que remontent les capteurs IoT n’est pas un bug : c’est la différence inhérente entre un système transactionnel et un système opérationnel.
Combler cet écart demande une couche de rapprochement qui comprend les deux modèles : la vérité transactionnelle de l’ERP et la vérité opérationnelle du réseau de capteurs. En pratique, cela signifie :
- Définir des règles de rapprochement explicites pour les cas d’écart courants (par exemple, des marchandises reçues à l’entrepôt avant que la commande d’achat soit confirmée dans l’ERP)
- Intégrer un score de confiance dans la représentation de l’état par le modèle, pour distinguer les niveaux de stock confirmés à la fois par les enregistrements de l’ERP et par les données des capteurs de ceux confirmés par une seule source
- Créer des boucles de retour pour que les écarts détectés par les capteurs déclenchent des workflows d’exception dans l’ERP, plutôt que d’être ignorés en silence ou de se substituer aux enregistrements de l’ERP sans relecture humaine
Simulation et modélisation prédictive des perturbations
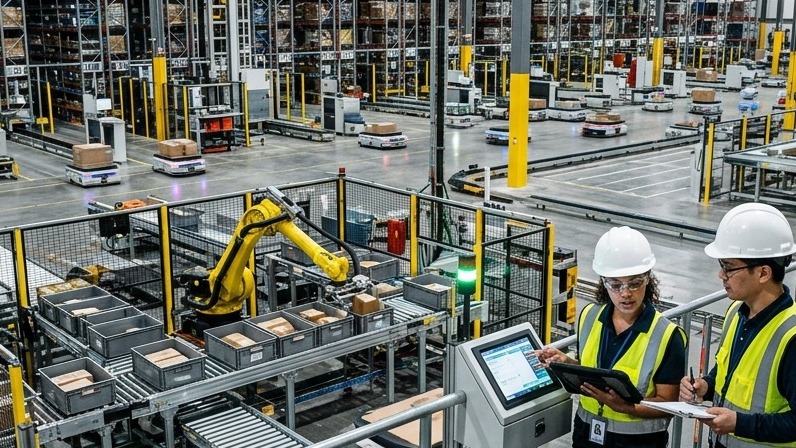
Une fois que le modèle en direct est stable et fiable, la capacité à forte valeur devient la simulation : exécuter des scénarios « et si » sur l’état actuel pour évaluer les options avant de s’y engager.
Prenons un scénario réaliste : un fournisseur majeur annonce un arrêt de production de 10 jours à cause d’un incendie d’usine. Une équipe de supply chain sans capacité de simulation doit évaluer à la main quels produits sont touchés, estimer le rythme d’épuisement à partir des stocks actuels, identifier d’autres sources d’approvisionnement et chiffrer le coût de chaque réponse. Ce processus prend généralement des jours, et la fenêtre d’une réponse optimale est souvent déjà fermée.
Avec une couche de simulation de jumeau numérique, le même scénario peut être modélisé en quelques heures. Le système identifie automatiquement toutes les références touchées (parce qu’il connaît les relations fournisseur-produit grâce à l’intégration ERP), applique les rythmes de consommation actuels issus des données des capteurs pour projeter les dates de rupture de stock par site, génère des options d’acheminement alternatives à partir de la capacité logistique sous contrat et présente à la direction des achats un ensemble de décisions classées par coût.
Des mises en œuvre plus avancées intègrent une modélisation probabiliste des perturbations : à partir des schémas historiques de perturbation, des scores de risque fournisseur, d’indicateurs géopolitiques et de données météorologiques, elles produisent des évaluations de risque proactives. Le modèle signale les concentrations de risque en formation avant qu’elles ne deviennent des urgences, par exemple une probabilité de 60% de congestion dans un port clé de l’acheminement, repérée trois semaines à l’avance plutôt que découverte quand les conteneurs commencent à s’entasser.
Dans un scénario illustratif, un fabricant qui a mis en place cette capacité a ramené le temps moyen de réaction aux perturbations de plusieurs jours à moins d’une journée, et a nettement réduit ses coûts de fret d’urgence (le fret aérien coûteux qui devient nécessaire quand les perturbations au sol sont découvertes trop tard).
Construire l’argumentaire économique
Les projets de jumeau numérique sont gourmands en capital. Une mise en œuvre complète, qui couvre l’infrastructure IoT, l’intégration ERP, la couche de modélisation et les capacités de simulation, représente généralement un programme de 18–24 mois et un investissement technologique important. L’argumentaire économique doit être solide.
Les leviers de ROI sont bien établis d’une mise en œuvre à l’autre :
- Optimisation des stocks. Une meilleure visibilité permet de calibrer plus finement les stocks de sécurité. Une amélioration typique de 15–20% de réduction des stocks, avec un niveau de service maintenu ou amélioré, libère un fonds de roulement important pour les entreprises qui comptent beaucoup de références et une forte valeur de stock.
- Réduction des coûts logistiques. L’acheminement prédictif et la réponse proactive aux perturbations réduisent les coûts de fret d’urgence, qui représentent généralement 3–5 fois le coût d’une logistique planifiée. Les organisations qui font passer le fret d’urgence de 8% à 3% des dépenses logistiques totales réalisent des économies notables à grande échelle.
- Réduction du gaspillage dans les supply chains de produits périssables. Pour les chaînes de l’alimentaire, du pharmaceutique et des cosmétiques, une meilleure visibilité de la chaîne du froid et une modélisation prédictive de la durée de conservation apportent de façon constante des réductions de 10–15% du gaspillage de produits, une catégorie de coûts qui s’ajoute aux économies sur les stocks et la logistique.
- Amélioration de l’expérience client. Une prévision de livraison exacte (rendue possible par des données opérationnelles réelles plutôt que par des estimations statiques de délais) réduit de 20–30% le volume de demandes au service client dans les mises en œuvre que nous avons vues, avec les économies de coûts de service correspondantes et un meilleur NPS.
L’approche de GTEMAS pour la mise en œuvre d’un jumeau numérique
GTEMAS construit des jumeaux numériques de supply chain par étapes, en apportant de la valeur opérationnelle à chacune, plutôt que d’exiger que le programme entier soit construit avant de réaliser de la valeur. La première phase porte sur le déploiement des capteurs IoT et le pipeline de données vers une couche centrale de gestion d’état ; cette phase seule améliore la visibilité opérationnelle en 90 jours. La deuxième phase intègre le pont ERP et met en place la couche de rapprochement. La troisième introduit les capacités de simulation, une fois que le modèle en direct a gagné la confiance après plusieurs mois d’exploitation.
Le modèle par étapes a une utilité pratique au-delà de la gestion du risque financier : il laisse aux équipes d’exploitation le temps de développer les capacités organisationnelles nécessaires pour exploiter les analyses prédictives. La technologie n’est qu’une partie de la valeur. Les organisations ont aussi besoin de protocoles de décision pour agir sur les résultats des simulations, de processus de gouvernance pour la maintenance du modèle et d’une formation opérationnelle pour les équipes qui travailleront quotidiennement avec le système.
En 2025, la visibilité de la supply chain ne consiste pas à avoir de meilleurs tableaux de bord. Elle consiste à construire un modèle de calcul qui permet à vos équipes d’exploitation de prendre de meilleures décisions, plus vite que vos concurrents. Si votre organisation évalue des capacités de jumeau numérique pour sa supply chain, nous serions heureux d’échanger sur ce que pourrait être une mise en œuvre par étapes dans votre environnement précis.