

Dashboards sind keine Transparenz
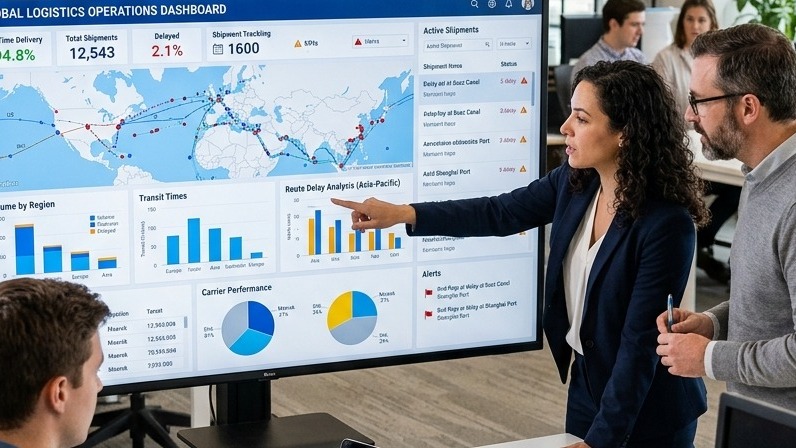
Die meisten Operations-Teams der Lieferkette haben Dashboards. Sie zeigen Lagerbestände, Sendungsstatus, Durchsatz der Lager und Erfüllungsquoten von Aufträgen. Ausgefeilte Varianten ergänzen Alarme, wenn Kennzahlen Schwellenwerte überschreiten. Diese Infrastruktur ist nützlich, beschreibt aber, was bereits geschehen ist. Sie ist ein Rückspiegel mit Datenbeschriftung.
Ein digitaler Zwilling ist grundlegend etwas anderes: ein in Echtzeit aktualisiertes, rechnerisches Modell der physischen Lieferkette, das den aktuellen Zustand abbildet und zu künftigen Zuständen befragt werden kann. Der Unterschied ist wichtiger, als er scheint. Ein Dashboard sagt Ihnen, dass Ihr Distributionszentrum in Singapur für das Produkt SKU-4471 Bestand für 12 Tage hat. Ein digitaler Zwilling lässt Sie fragen: „Wenn sich das Containerschiff aus Guangzhou um 8 Tage verspätet und die Nachfrage wegen der anstehenden Werbeaktion um 15 % steigt, wann kommt es zum Fehlbestand, und welche alternativen Transportrouten verhindern ihn zu welchen Kosten?“
Das ist der Wandel vom reaktiven zum vorausschauenden Betrieb. Und es ist kein theoretischer Anspruch – Organisationen, die echte Digital-Twin-Fähigkeiten für ihre Lieferketten aufgebaut haben, berichten von spürbar geringeren Kapitalbindungskosten im Lager (siehe die Zahlen zur Bestandsoptimierung weiter unten), besserer Termintreue und deutlich schnelleren Reaktionszeiten bei Störungen. Die Technologie dafür gibt es inzwischen im Enterprise-Maßstab, und die Integrationsmuster für IoT und ERP sind ausgereift genug, um wiederholbar zu sein.
Die IoT-Sensorarchitektur, die es real macht
Ein digitaler Zwilling ist nur so genau wie seine Datenquellen. Bei Anwendungen in der Lieferkette sind die wichtigsten Datenquellen IoT-Sensoren im physischen Logistiknetz: Sensoren im Lager, die Standort und Bewegung von Beständen verfolgen, Temperatur- und Feuchtesensoren für die Kühlkettenlogistik, GPS-Tracker an Fahrzeugen und Containern, Gewichtssensoren an Laderampen und RFID-Leser an den Ein- und Ausgängen der Standorte.
Die Engineering-Herausforderung sind nicht die Sensoren selbst – IoT-Standardhardware ist vergleichsweise günstig und zuverlässig. Die Herausforderung ist die Datenpipeline vom Sensor zum Modell. Ein mittelgroßer Lieferkettenbetrieb kann 500.000 bis 2 Millionen Sensorereignisse pro Tag erzeugen. Diese Daten müssen nahezu in Echtzeit aufgenommen, aus den unterschiedlichen Formaten der Sensorhersteller normalisiert, auf Qualität geprüft (Sensoren fallen aus, Verbindungen brechen ab, Datenanomalien treten auf) und so schnell ins Modell eingespeist werden, dass dessen Zustand die physische Realität sinnvoll widerspiegelt.
Die Architektur, die das im großen Maßstab bewältigt, umfasst typischerweise:
- Edge-Verarbeitung. Das Filtern und Aggregieren der Rohdaten der Sensoren auf Standortebene, bevor sie die zentralen Systeme erreichen, senkt das Datenvolumen um 70–80 % und stellt sicher, dass Verbindungsprobleme an einem einzelnen Standort sich nicht als Datenlücken ins zentrale Modell fortpflanzen.
- Infrastruktur für Event Streaming. Apache Kafka oder AWS Kinesis bewältigen Menge und Geschwindigkeit der normalisierten Sensorereignisse mit den Durability-Garantien, die operative Systeme verlangen.
- Schicht für das Zustandsmanagement. Eine Zeitreihendatenbank (InfluxDB, TimescaleDB oder AWS Timestream) hält den aktuellen und historischen Zustand jeder Entität der Lieferkette – Bestandseinheiten, Fahrzeuge, Standorte, Sendungen –, die das Digital-Twin-Modell abfragt.
- ERP-Integrationsbrücke. Eine bidirektionale Integration mit dem ERP-System (SAP, Oracle oder vergleichbar), die Transaktionsdaten – Bestellungen, Bestandsbuchungen, Logistikverträge – mit dem operativen Zustand synchron hält, den die IoT-Sensoren melden.
ERP-Integration: der schwierigste Teil
Die IoT-Architektur ist bei aller Komplexität weitgehend ein Neubau – Sie bauen neue Systeme auf moderner Infrastruktur. Bei der ERP-Integration stoßen die meisten Digital-Twin-Projekte auf die größte Reibung, weil ERP-Systeme für Transaktionsgenauigkeit entworfen wurden und nicht für operative Echtzeit-Transparenz.
SAP ECC etwa verarbeitet Transaktionen in Batch-Updates und führt Datensätze auf einer Abstraktionsebene, die sich nicht unmittelbar auf physische Ereignisse abbilden lässt. Eine Bestandskorrektur in SAP ist eine Buchung, nicht zwingend eine physische Bewegung in Echtzeit. Die Lücke zwischen dem, was das ERP sagt, und dem, was die IoT-Sensoren melden, ist kein Fehler – sie ist der grundsätzliche Unterschied zwischen einem Transaktionssystem und einem operativen System.
Diese Lücke zu überbrücken, verlangt eine Abgleichsschicht, die beide Modelle versteht: die transaktionale Wahrheit des ERP und die operative Wahrheit des Sensornetzes. In der Praxis heißt das:
- Ausdrückliche Abgleichsregeln für häufige Abweichungsmuster festlegen (etwa Ware, die im Lager eingeht, bevor die ERP-Bestellung bestätigt ist)
- Einen Konfidenzwert in die Zustandsdarstellung des Modells einbauen – zur Unterscheidung zwischen Bestandspositionen, die sowohl durch ERP-Datensätze als auch durch Sensordaten bestätigt sind, und solchen, die nur eine Quelle bestätigt
- Rückkopplungsschleifen schaffen, damit von Sensoren erkannte Abweichungen ERP-Ausnahme-Workflows auslösen, statt stillschweigend ignoriert zu werden oder ERP-Datensätze ohne menschliche Prüfung zu überschreiben
Simulation und vorausschauende Modellierung von Störungen
Sobald das Live-Modell stabil läuft und Vertrauen genießt, wird die Simulation zur wertvollsten Fähigkeit: Was-wäre-wenn-Szenarien gegen den aktuellen Zustand laufen zu lassen, um Optionen zu bewerten, bevor man sich auf sie festlegt.
Ein realistisches Szenario: Ein wichtiger Lieferant meldet wegen eines Fabrikbrands einen Produktionsstopp von 10 Tagen. Ein Lieferketten-Team ohne Simulationsfähigkeit muss manuell prüfen, welche Produkte betroffen sind, die Verbrauchsraten aus dem aktuellen Bestand abschätzen, alternative Bezugsquellen finden und die Kosten jeder Reaktion durchrechnen. Das dauert typischerweise Tage, und bis dahin ist das Zeitfenster für eine optimale Reaktion oft vorbei.
Mit einer Simulationsschicht des digitalen Zwillings lässt sich dasselbe Szenario in Stunden modellieren. Das System erkennt alle betroffenen SKUs automatisch (weil es die Beziehungen zwischen Lieferanten und Produkten aus der ERP-Integration kennt), wendet die aktuellen Verbrauchsraten aus den Sensordaten an, um den Zeitpunkt des Fehlbestands je Standort vorherzusagen, erzeugt alternative Transportrouten auf Basis vertraglich vereinbarter Logistikkapazität und legt der Einkaufsleitung eine nach Kosten gereihte Entscheidungsvorlage vor.
Fortgeschrittenere Umsetzungen beziehen probabilistische Störungsmodelle ein: Sie nutzen historische Störungsmuster, Lieferantenrisikowerte, geopolitische Indikatoren und Wetterdaten, um vorausschauende Risikobewertungen zu erzeugen. Das Modell meldet sich entwickelnde Risikokonzentrationen, bevor sie zu Notfällen werden – etwa eine Wahrscheinlichkeit von 60 % für Hafenstau an einem wichtigen Knotenpunkt, drei Wochen im Voraus erkannt statt erst, wenn sich die Container stauen.
In einem Beispielszenario senkte ein Hersteller, der diese Fähigkeit einführte, die durchschnittliche Reaktionszeit bei Störungen von mehreren Tagen auf unter einen Tag und verringerte die Kosten für Notfallfracht deutlich (die teure Luftfracht, die nötig wird, wenn Störungen am Boden zu spät erkannt werden).
Den Business Case aufbauen
Digital-Twin-Projekte sind kapitalintensiv. Eine umfassende Umsetzung mit IoT-Infrastruktur, ERP-Integration, Modellierungsschicht und Simulationsfähigkeit ist typischerweise ein Programm von 18–24 Monaten und eine erhebliche Technologieinvestition. Der Business Case muss belastbar sein.
Die ROI-Treiber sind über Umsetzungen hinweg gut belegt:
- Bestandsoptimierung. Bessere Transparenz ermöglicht eine engere Kalibrierung der Sicherheitsbestände. Eine typische Bestandsreduktion von 15–20 % bei gleichbleibendem oder besserem Servicegrad setzt in Unternehmen mit vielen SKUs und hohem Lagerwert erhebliches Working Capital frei.
- Geringere Logistikkosten. Vorausschauende Routenplanung und proaktive Reaktion auf Störungen senken die Kosten für Notfallfracht, die typischerweise das 3- bis 5-Fache geplanter Logistik betragen. Organisationen, die Notfallfracht von 8 % auf 3 % der gesamten Logistikausgaben senken, erzielen im großen Maßstab spürbare Einsparungen.
- Weniger Ausschuss in verderblichen Lieferketten. In den Lieferketten für Lebensmittel, Pharma und Kosmetik bringen bessere Transparenz der Kühlkette und vorausschauende Modellierung der Haltbarkeit durchgehend 10–15 % weniger Produktausschuss – eine Kostenkategorie, die die Einsparungen bei Beständen und Logistik verstärkt.
- Bessere Customer Experience. Eine genaue Lieferprognose (auf Basis echter Betriebsdaten statt statischer Lieferzeitschätzungen) senkt in den Umsetzungen, die wir gesehen haben, das Aufkommen an Kundenserviceanfragen um 20–30 %, mit entsprechenden Einsparungen bei den Servicekosten und einem besseren NPS.
Der GTEMAS-Ansatz bei der Umsetzung digitaler Zwillinge
GTEMAS baut digitale Zwillinge der Lieferkette in Phasen auf, die in jeder Stufe operativen Nutzen liefern, statt zu verlangen, dass das gesamte Programm fertig ist, bevor sich ein Nutzen zeigt. Phase eins konzentriert sich auf den Einsatz der IoT-Sensoren und die Datenpipeline zu einer zentralen Schicht für das Zustandsmanagement – allein das verbessert die operative Transparenz innerhalb von 90 Tagen. Phase zwei integriert die ERP-Brücke und richtet die Abgleichsschicht ein. Phase drei führt die Simulationsfähigkeit ein, sobald das Live-Modell über mehrere Monate im Betrieb Vertrauen aufgebaut hat.
Das Phasenmodell dient über das finanzielle Risikomanagement hinaus einem praktischen Zweck: Es gibt den Operations-Teams Zeit, die organisatorischen Fähigkeiten für den Umgang mit vorausschauenden Erkenntnissen aufzubauen. Die Technologie ist nur ein Teil des Nutzens. Organisationen brauchen außerdem Entscheidungsregeln, um nach den Ergebnissen der Simulation zu handeln, Governance-Prozesse für die Pflege des Modells und operative Schulungen für die Teams, die täglich mit dem System arbeiten werden.
Transparenz in der Lieferkette im Jahr 2025 bedeutet nicht bessere Dashboards. Sie bedeutet, ein rechnerisches Modell zu bauen, mit dem Ihr Operations-Team bessere Entscheidungen schneller treffen kann als Ihre Wettbewerber. Wenn Ihre Organisation digitale Zwillinge für Ihre Lieferkette prüft, sprechen wir gern darüber, wie eine phasenweise Umsetzung in Ihrer konkreten Umgebung aussehen könnte.