

Quelque chose a changé, et la plupart des entreprises ne l’ont pas vu
Une question mérite qu’on s’y arrête : quand votre équipe d’ingénierie a-t-elle passé un sprint entier à écrire du code à partir de zéro ?
Pas à configurer un outil. Pas à intégrer une API construite par quelqu’un d’autre. Pas à résoudre un conflit de dépendances. À écrire réellement de la logique métier nouvelle, ligne après ligne, dans un fichier vide.
Pour la plupart des équipes en entreprise, la réponse honnête est « rarement ». Et c’était déjà vrai avant l’arrivée des outils d’IA. Le quotidien d’un ingénieur logiciel moderne était déjà dominé par la lecture de code existant, la navigation dans des systèmes complexes, les réunions pour s’accorder sur les besoins et les batailles avec les pipelines de déploiement. La part « écriture de code » représentait peut-être 30% du métier.
L’IA a désormais fortement comprimé ces 30%. Des outils comme GitHub Copilot, Cursor et Claude produisent des implémentations fonctionnelles en quelques secondes. Une fonction qui demandait 45 minutes à écrire, tester et affiner ? Faite en 3 minutes avec un prompt bien formulé. Un script de migration de base de données ? Généré avant la fin de votre café.
Cela ressemble à une excellente nouvelle, et c’en est une. Mais cela pose aussi un problème que la plupart des organisations n’ont pas encore examiné : si écrire du code n’est plus le goulot d’étranglement, alors quel est-il ? Et si tout votre modèle de livraison (vos cadres d’estimation, vos structures d’équipe, vos contrats avec les prestataires) a été bâti sur l’idée qu’écrire du code est lent et coûteux, que se passe-t-il quand cette idée ne tient plus ?
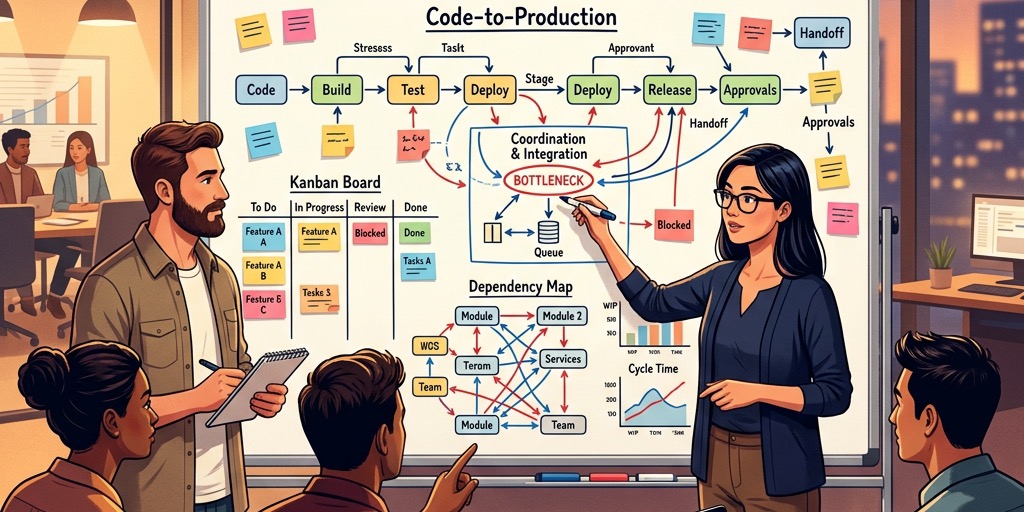
Le vrai goulot d’étranglement n’a jamais été le code
Voyons ce qui ralentit réellement les projets logiciels en entreprise. Si vous êtes dans le secteur depuis assez longtemps, vous connaissez déjà la réponse. Ce n’est pas la vitesse de frappe. Ce n’est même pas la complexité technique, la plupart du temps.
C’est l’alignement.
Faire dire aux parties prenantes ce qu’elles veulent vraiment. Traduire un besoin métier comme « nous avons besoin de mieux fidéliser nos clients » en un ensemble précis de fonctionnalités, de flux de données et de parcours utilisateur. Gérer l’écart entre ce que le product owner a décrit en réunion et ce que le développeur a compris trois jours plus tard, en se mettant enfin au ticket.
Les études du secteur sur les échecs de projets logiciels, les études CHAOS du Standish Group en tête, désignent depuis longtemps la même cause racine : la majorité des échecs remontent à de mauvaises exigences, pas à une mauvaise ingénierie. Le code était correct. L’équipe a construit la mauvaise chose, ou la bonne chose dans le mauvais ordre, ou n’a découvert une contrainte critique qu’au quatrième mois d’un projet de six mois.
C’est là que l’effet de l’IA devient intéressant. Elle ne se contente pas de faire des développeurs des dactylos plus rapides. Elle écrase la boucle de retour entre « je crois avoir compris ce que vous voulez » et « voici un prototype fonctionnel que vous pouvez réellement parcourir ». Quand cette boucle passe de semaines à quelques heures, tout ce qui vient ensuite change.
Ce que cela donne en pratique
Prenons un exemple concret, tiré d’un projet que nous avons mené l’an dernier.
Un client des services financiers avait besoin d’un module de reporting de conformité. Dans l’ancien monde, une telle fonctionnalité aurait commencé par trois semaines de recueil des exigences, abouti à une spécification de 40 pages que personne n’aurait lue en entier, puis demandé six semaines de développement de plus, avec au moins deux cycles de corrections du type « ce n’est pas ce que nous voulions dire ».
Notre équipe a fait autrement. Lors d’une seule séance de travail avec le responsable conformité du client, nous avons enregistré la conversation, confié la transcription à un système d’IA et obtenu en moins d’une heure un ensemble structuré de user stories avec leurs critères d’acceptation. Mais l’essentiel est ailleurs : nous avons aussi produit le jour même un prototype cliquable. Pas un produit abouti, mais une maquette brute et fonctionnelle avec laquelle le responsable conformité pouvait interagir.
Elle l’a parcouru, a repéré aussitôt trois hypothèses que nous avions mal posées et a dit : « Ce champ doit afficher l’historique de la piste d’audit, pas seulement le statut actuel. » Cette seule correction, relevée dès le premier jour, aurait coûté deux semaines de reprise si elle avait été découverte pendant les tests QA. Nous avons ajusté le prototype en temps réel. À la fin de la semaine, nous disposions d’une conception validée sur laquelle tout le monde s’accordait.
Le temps total de développement du module final ? Trois semaines, tests et déploiement compris. L’estimation de l’ancien calendrier pour le même périmètre ? Dix à douze semaines.
Le code a-t-il été écrit plus vite ? Oui, un peu. Mais le vrai gain de temps vient de la suppression de la boucle d’ambiguïté : ces allers-retours d’incompréhension qui absorbent l’essentiel du calendrier des projets en entreprise.
La vérité qui dérange sur l’estimation
Si vous gérez des budgets d’ingénierie, cette section est pour vous.
La plupart des contrats de logiciel en entreprise sont encore facturés à l’effort : heures travaillées, story points consommés, sprints terminés. L’hypothèse implicite est que plus d’effort signifie plus de valeur. Vous achetez du temps, et le temps coûte cher parce que les développeurs qualifiés coûtent cher.
L’IA met ce modèle en difficulté. Si un développeur senior accomplit désormais en deux heures ce qui en demandait douze, le client doit-il en payer deux ou douze ? Si le prestataire en facture douze et livre en deux, empoche-t-il dix heures de marge ? S’il en facture deux, sous-estime-t-il la réflexion d’architecture qui a rendu ces deux heures productives ?
Cette tension se manifeste partout dans le secteur. Certains prestataires utilisent discrètement des outils d’IA en interne tout en facturant aux anciens tarifs. D’autres se livrent à une course au moins-disant, baissent leurs devis de 50% et comptent sur le volume pour compenser. Aucune des deux approches n’est tenable.
Il faut reconnaître que l’unité de valeur doit changer. Au lieu d’acheter des heures, les clients en entreprise devraient acheter des résultats : un module de conformité qui fonctionne, un pipeline de données migré, un tunnel de paiement repensé. Le rôle du prestataire est de livrer ce résultat de façon fiable et rapide. Peu importe, pour l’acheteur, que chaque ligne soit écrite à la main ou que l’IA produise 80% du code boilerplate. Ce qui compte, c’est la qualité, la fiabilité et la vitesse.
Chez GTEMAS, nous évoluons vers des modèles d’engagement fondés sur les résultats pour cette raison précise : c’est la logique commerciale de FastDX, notre chaîne de livraison AI-native. Nous cadrons le travail par livrables et jalons, pas par effectifs et par heures. C’est un modèle plus difficile à vendre, car les clients ont l’habitude de compter les personnes, mais il aligne correctement les intérêts. Nous sommes récompensés pour notre efficacité, pas pour notre lenteur.
Ce qui change pour les équipes d’ingénierie
Un point est trop peu discuté : les outils d’IA ne réduisent pas le besoin d’ingénieurs seniors. Ils l’augmentent.
Cela paraît contre-intuitif, alors expliquons. Quand l’IA génère du code rapidement, le volume de code produit chaque jour augmente fortement. Quelqu’un doit relire ce code. Quelqu’un doit décider si les choix d’architecture de l’IA ont du sens dans le contexte du système global. Quelqu’un doit repérer les bugs subtils que l’IA introduit : ceux où le code compile et passe les tests de base, mais contient une condition de concurrence (race condition) qui n’apparaît que sous la charge de la production.
Les développeurs juniors savent bien solliciter l’IA pour des tâches isolées. Mais juger si le résultat est correct dans un système plus large ? Cela demande une expérience approfondie. Il faut savoir à quoi ressemble le « bon » pour reconnaître quand l’IA fournit quelque chose de simplement « fonctionnel ».
Nous avons restructuré nos équipes autour de cette réalité. Au lieu de la pyramide traditionnelle, avec quelques seniors qui supervisent de nombreux juniors, nous constituons désormais des équipes plus plates où chaque ingénieur doit opérer au niveau de l’architecture. L’IA prend en charge ce que faisaient les développeurs juniors : écrire du code boilerplate, générer les squelettes de tests, traiter les migrations courantes. Les humains se concentrent sur la conception du système, la revue de sécurité, l’optimisation des performances et les décisions de jugement que l’IA ne peut tout simplement pas prendre de façon fiable.
Cela a des conséquences concrètes sur le recrutement. Nous cherchons désormais autre chose. Il y a cinq ans, un entretien technique pouvait tester si un candidat savait implémenter de mémoire un arbre binaire de recherche. Aujourd’hui, nous voulons surtout savoir s’il sait examiner une base de code générée et repérer ce qui manque : la gestion d’erreurs que l’IA a sautée, le cas limite qu’elle n’a pas envisagé, la faille de sécurité cachée dans une dépendance qu’elle a choisie.
« Le code le plus dangereux est celui qui fonctionne parfaitement en test et échoue en silence en production. L’IA écrit très bien du code qui passe les tests. Savoir quand s’en méfier est une compétence humaine. »
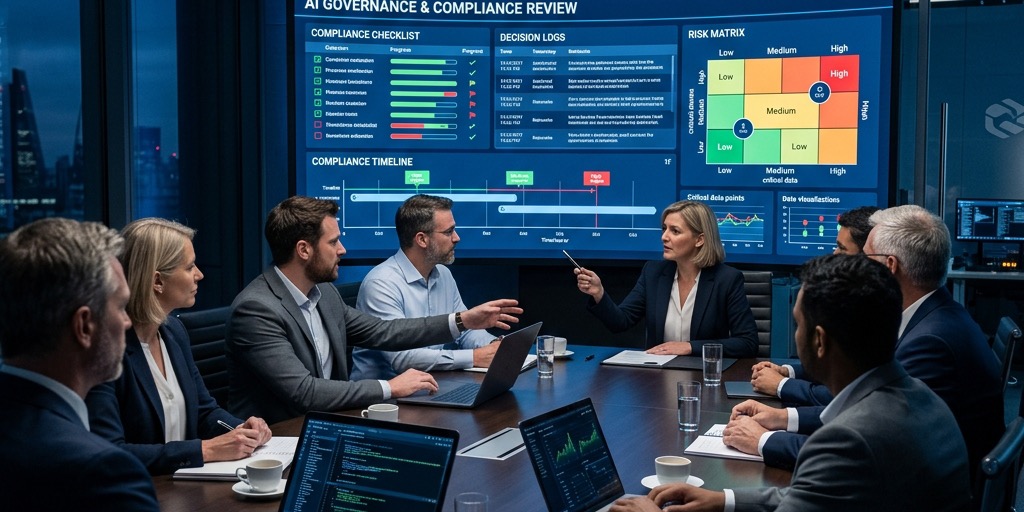
Le problème de gouvernance dont personne ne veut parler
Tout cela a un revers que le secteur ignore en grande partie.
Quand l’IA génère du code, qui en est responsable ? Si une fonction générée par l’IA introduit une faille de sécurité qui entraîne une fuite de données, la responsabilité revient-elle au développeur qui a accepté la suggestion, au chef d’équipe qui a approuvé la pull request ou au prestataire qui a déployé l’outil ?
La plupart des cadres juridiques d’entreprise n’ont pas encore rattrapé cette question. Dans les secteurs réglementés (santé, finance, secteur public), ce n’est pas une préoccupation abstraite. Les auditeurs veulent savoir qui a écrit le code et s’il a été relu par un humain qualifié. « Une IA l’a écrit et un développeur a cliqué sur approuver » ne satisfera pas un auditeur SOC 2.
Nous prenons ce sujet au sérieux, car nos clients évoluent précisément dans ces environnements. Chaque morceau de code généré par l’IA qui entre dans notre chaîne de livraison suit le même processus de revue que le code écrit par des humains : revue par les pairs, analyse de sécurité automatisée et validation explicite par un ingénieur senior. Nous conservons une traçabilité complète : on voit exactement quelles parties de la base de code ont été assistées par l’IA et qui les a relues.
Ce n’est pas de la bureaucratie pour elle-même. C’est le fondement de la confiance. Si vous ne pouvez pas auditer votre code assisté par l’IA avec la même rigueur que le code écrit par des humains, vous ne devriez pas utiliser l’IA en production.
Où tout cela mène
Nous sommes encore au début. Les outils d’IA disponibles aujourd’hui, aussi impressionnants soient-ils, constituent la première génération. Ils vont s’améliorer. Les modèles tiendront mieux compte du contexte, comprendront mieux les grandes bases de code et seront plus fiables dans leurs suggestions d’architecture. L’écart entre développement « assisté par l’IA » et « AI-First » va se réduire.
Mais les fondamentaux ne changeront pas. La livraison de logiciels a toujours été, au fond, un problème de communication. Le plus difficile est de comprendre ce que veulent les humains et de le traduire en quelque chose qu’une machine peut exécuter. L’IA rend l’exécution moins chère, mais la compréhension reste coûteuse, et humaine.
Ce qui va changer, c’est la forme des partenariats de livraison qui réussissent. Les prestataires qui prospéreront seront ceux qui ont réellement intégré l’IA à leurs méthodes de travail, non comme un argument marketing, mais comme un avantage structurel qui leur permet de livrer plus de valeur pour chaque dollar. Ils factureront aux résultats, constitueront des équipes à forte dominante senior et maintiendront les cadres de gouvernance qu’exigent les clients en entreprise.
Ceux qui perdront seront les prestataires qui continuent de vendre des effectifs et de compter les heures, en espérant que leurs clients ne remarqueront pas qu’une équipe de cinq personnes équipée d’outils d’IA peut surpasser une équipe de quinze qui en est dépourvue.
Chez GTEMAS, nous avons fait notre choix. Nous bâtissons notre organisation de livraison, portée par FastDX, sur l’hypothèse que l’IA est un élément durable du paysage de l’ingénierie, et non une tendance qui pourrait s’éteindre. Nos équipes, nos processus, nos modèles commerciaux : tout est conçu pour un monde où le jugement humain et les capacités des machines travaillent ensemble. Non parce que cela sonne bien dans une présentation commerciale, mais parce que c’est le seul modèle qui fonctionne vraiment quand on s’assoit pour faire les comptes.
Les entreprises qui comprendront cela les premières auront un avantage significatif. Pas seulement en vitesse, même si elles iront plus vite. En qualité, en prévisibilité et en capacité à s’adapter quand les exigences changent inévitablement en cours de projet. Car elles changeront. Elles le font toujours. La question est de savoir si votre modèle de livraison est conçu pour l’absorber sans heurt, ou s’il casse chaque fois que quelqu’un dit : « En fait, il faudrait que ça fonctionne un peu autrement. »
Voilà la vraie promesse de l’IA dans la livraison en entreprise. Pas une frappe plus rapide. Une meilleure réflexion.