

Etwas hat sich verändert, und die meisten Unternehmen haben es verpasst
Eine Frage, über die es sich nachzudenken lohnt: Wann hat Ihr Engineering-Team zuletzt einen ganzen Sprint damit verbracht, Code von Grund auf neu zu schreiben?
Nicht etwas zu konfigurieren. Nicht eine API einzubinden, die jemand anderes gebaut hat. Nicht einen Konflikt zwischen Abhängigkeiten zu debuggen. Sondern neue Geschäftslogik zu schreiben, Zeile für Zeile, in einer leeren Datei.
Für die meisten Enterprise-Teams lautet die ehrliche Antwort „selten“. Und das galt schon vor dem Einzug von KI-Tools. Der Alltag eines modernen Softwareentwicklers bestand ohnehin überwiegend darin, bestehenden Code zu lesen, sich in komplexen Systemen zurechtzufinden, in Meetings Anforderungen abzustimmen und sich mit Deployment-Pipelines herumzuschlagen. Das eigentliche „Code schreiben“ machte vielleicht 30 % der Arbeit aus.
Diese 30 % hat KI nun stark verkürzt. Tools wie GitHub Copilot, Cursor und Claude erzeugen lauffähige Implementierungen in Sekunden. Eine Funktion, für die man früher 45 Minuten zum Schreiben, Testen und Verfeinern brauchte? Mit einem gut formulierten Prompt in 3 Minuten erledigt. Ein Skript für eine Datenbankmigration? Fertig, bevor der Kaffee ausgetrunken ist.
Das klingt nach einer guten Nachricht. Und das ist es auch. Es schafft aber ein Problem, mit dem sich die meisten Organisationen noch nicht befasst haben: Wenn das Schreiben von Code nicht mehr der Engpass ist, was ist es dann? Und wenn Ihr gesamtes Delivery-Modell – Schätzverfahren, Teamstrukturen, Lieferantenverträge – auf der Annahme beruht, dass Code langsam und teuer zu schreiben ist, was passiert, wenn diese Annahme wegfällt?
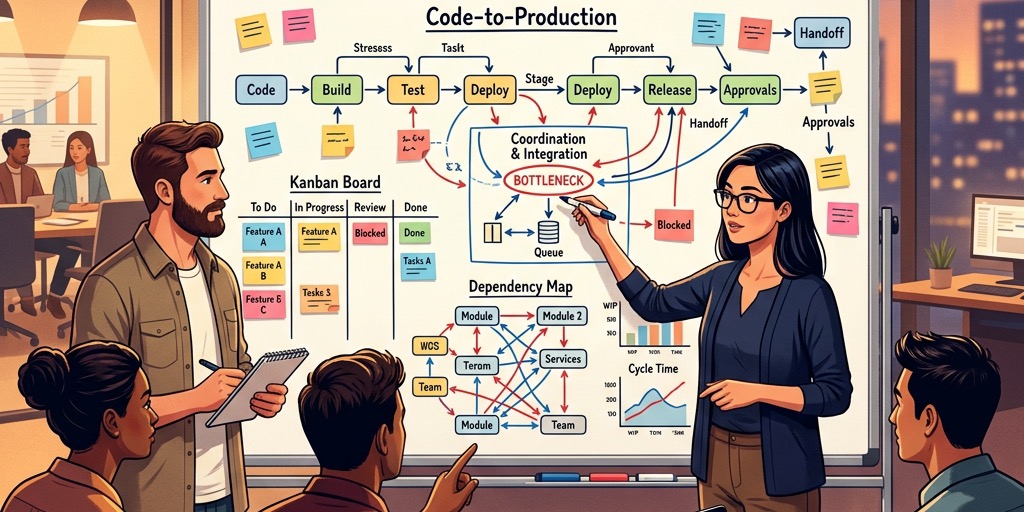
Der eigentliche Engpass war nie der Code
Sprechen wir darüber, was Enterprise-Softwareprojekte tatsächlich ausbremst. Wer lange genug in der Branche ist, kennt die Antwort. Es ist nicht die Tippgeschwindigkeit. Meistens ist es nicht einmal die technische Komplexität.
Es ist die Abstimmung.
Stakeholder müssen sich darauf einigen, was sie tatsächlich wollen. Eine fachliche Anforderung wie „wir brauchen eine bessere Kundenbindung“ muss in konkrete Funktionen, Datenflüsse und Nutzererlebnisse übersetzt werden. Und die Lücke zwischen dem, was der Product Owner im Meeting beschrieben hat, und dem, was der Entwickler drei Tage später verstanden hat, als er endlich mit dem Ticket anfing, muss geschlossen werden.
Branchenstudien zum Scheitern von Softwareprojekten – allen voran die CHAOS-Studien der Standish Group – nennen seit Langem dieselbe Ursache: Die Mehrheit der Fehlschläge geht auf schlechte Anforderungen zurück, nicht auf schlechtes Engineering. Der Code war in Ordnung. Das Team hat das Falsche gebaut, oder das Richtige in der falschen Reihenfolge, oder es hat eine kritische Randbedingung erst im vierten Monat eines sechsmonatigen Projekts entdeckt.
Genau hier wird die Wirkung von KI interessant. Sie macht Entwickler nicht nur zu schnelleren Tippern. Sie verkürzt die Rückkopplungsschleife zwischen „ich glaube, ich habe verstanden, was Sie wollen“ und „hier ist ein funktionierender Prototyp, den Sie anklicken können“. Wenn diese Schleife von Wochen auf Stunden schrumpft, verändert sich alles, was danach kommt.
Wie das in der Praxis aussieht
Ein konkretes Beispiel aus einem Projekt des vergangenen Jahres.
Ein Kunde aus dem Finanzsektor brauchte ein Modul für das Compliance-Reporting – ein Feature, das in der alten Welt mit drei Wochen Anforderungsaufnahme begonnen hätte, ein 40-seitiges Spezifikationsdokument hervorgebracht hätte, das niemand vollständig liest, und dann weitere sechs Wochen Bauzeit gebraucht hätte, mit mindestens zwei Runden „so war das nicht gemeint“ unterwegs.
Unser Team ging anders vor. In einer einzigen Arbeitssitzung mit dem Compliance Officer des Kunden zeichneten wir das Gespräch auf, gaben das Transkript in ein KI-System und hatten innerhalb einer Stunde einen strukturierten Satz User Stories mit Akzeptanzkriterien. Entscheidend war aber etwas anderes: Am selben Tag erzeugten wir auch einen anklickbaren Prototyp. Kein ausgereiftes Produkt, sondern ein grober, funktionsfähiger Entwurf, mit dem der Compliance Officer arbeiten konnte.
Sie klickte sich durch, erkannte sofort drei falsche Annahmen unsererseits und sagte: „Dieses Feld muss die historische Audit-Spur zeigen, nicht nur den aktuellen Status.“ Diese eine Korrektur, am ersten Tag erkannt, hätte bei einer Entdeckung im QA-Test zwei Wochen Nacharbeit bedeutet. Wir passten den Prototyp in Echtzeit an. Bis zum Ende der Woche lag ein validiertes Design vor, auf das sich alle geeinigt hatten.
Die gesamte Bauzeit für das fertige Modul? Drei Wochen, einschließlich Test und Deployment. Die alte Zeitschätzung für denselben Umfang? Zehn bis zwölf Wochen.
Wurde der Code schneller geschrieben? Ja, etwas. Die eigentliche Zeitersparnis kam aber daher, dass die Schleife der Unklarheit wegfiel – das Hin und Her aus Missverständnissen, das den größten Teil der Zeitpläne von Enterprise-Projekten verschlingt.
Die unbequeme Wahrheit über Schätzungen
Wer Engineering-Budgets verantwortet, für den ist dieser Abschnitt.
Die meisten Enterprise-Softwareverträge werden noch immer nach Aufwand bepreist: geleistete Stunden, verbrauchte Story Points, abgeschlossene Sprints. Dahinter steht die stille Annahme, mehr Aufwand bedeute mehr Wert. Sie kaufen Zeit, und Zeit ist teuer, weil qualifizierte Entwickler teuer sind.
KI stellt dieses Modell auf unbequeme Weise infrage. Wenn ein Senior-Entwickler heute in zwei Stunden schafft, wofür er früher zwölf brauchte, soll der Kunde dann für zwei Stunden zahlen oder für zwölf? Wenn der Anbieter zwölf anbietet und in zwei liefert, steckt er dann zehn Stunden Marge ein? Wenn er zwei anbietet, unterbewertet er dann das architektonische Denken, das diese zwei Stunden erst produktiv gemacht hat?
Diese Spannung beobachten wir branchenweit. Manche Anbieter setzen intern still KI-Tools ein und rechnen weiter zu den alten Sätzen ab. Andere liefern sich einen Preiskampf nach unten, kürzen Angebote um 50 % und hoffen, dass das Volumen den Unterschied ausgleicht. Beides ist nicht tragfähig.
Die ehrliche Antwort: Die Einheit, in der Wert bemessen wird, muss sich ändern. Statt Stunden sollten Enterprise-Kunden Ergebnisse kaufen: ein funktionierendes Compliance-Modul, eine migrierte Datenpipeline, einen neu gestalteten Checkout-Ablauf. Die Aufgabe des Anbieters ist es, dieses Ergebnis zuverlässig und schnell zu liefern. Wie er das tut – ob ein Mensch jede Zeile von Hand schreibt oder eine KI 80 % des Boilerplate-Codes erzeugt –, sollte für den Käufer keine Rolle spielen. Es zählen Qualität, Zuverlässigkeit und Geschwindigkeit.
Bei GTEMAS bewegen wir uns genau aus diesem Grund hin zu ergebnisbasierten Zusammenarbeitsmodellen – es ist die kommerzielle Logik hinter FastDX, unserer AI-nativen Delivery-Pipeline. Wir bemessen Arbeit nach Liefergegenständen und Meilensteinen, nicht nach Köpfen und Stunden. Das ist schwerer zu verkaufen, weil Kunden gewohnt sind, Personen zu zählen, richtet die Anreize aber richtig aus: Wir werden dafür belohnt, effizient zu sein, nicht dafür, langsam zu sein.
Was sich für Engineering-Teams ändert
Ein Punkt, der zu selten besprochen wird: KI-Tools verringern den Bedarf an Senior Engineers nicht. Sie erhöhen ihn.
Das klingt widersprüchlich, daher die Erklärung. Wenn KI Code schnell erzeugen kann, steigt die Menge des täglich produzierten Codes stark an. Jemand muss diesen Code prüfen. Jemand muss entscheiden, ob die Architekturentscheidungen der KI im Kontext des Gesamtsystems sinnvoll sind. Jemand muss die subtilen Fehler finden, die KI einbaut – etwa Code, der kompiliert und einfache Tests besteht, aber eine Race Condition enthält, die erst unter Produktionslast auftritt.
Junior-Entwickler können KI für isolierte Aufgaben wirksam einsetzen. Aber zu beurteilen, ob das Ergebnis im größeren Systemzusammenhang korrekt ist, verlangt tiefe Erfahrung. Man muss wissen, wie „gut“ aussieht, um zu erkennen, wann die KI etwas liefert, das lediglich „funktioniert“.
Wir haben unsere Teams auf diese Realität ausgerichtet. Statt der klassischen Pyramide – wenige Seniors beaufsichtigen viele Juniors – arbeiten wir jetzt in flacheren Teams, in denen von jedem Engineer erwartet wird, auf Architekturebene zu arbeiten. Die KI übernimmt, was früher Junior-Entwickler taten: Boilerplate schreiben, Test-Gerüste erzeugen, Routinemigrationen durchführen. Die Menschen konzentrieren sich auf Systemdesign, Sicherheitsprüfung, Performance-Optimierung und die Abwägungen, die KI schlicht nicht verlässlich treffen kann.
Das hat spürbare Folgen für das Recruiting. Wir suchen heute nach anderen Dingen. Vor fünf Jahren hätte ein Coding-Interview vielleicht geprüft, ob ein Kandidat einen binären Suchbaum aus dem Kopf implementieren kann. Heute interessiert uns mehr, ob er eine generierte Codebasis ansehen und erkennen kann, was fehlt: die Fehlerbehandlung, die die KI ausgelassen hat, den Sonderfall, den sie nicht bedacht hat, die Sicherheitslücke in einer Abhängigkeit, die sie ausgewählt hat.
„Der gefährlichste Code ist Code, der im Test einwandfrei läuft und in der Produktion unbemerkt versagt. KI ist sehr gut darin, Code zu schreiben, der Tests besteht. Zu wissen, wann man dem misstrauen sollte, ist eine menschliche Fähigkeit.“
Das Governance-Problem, über das niemand reden will
Das alles hat eine dunklere Seite, die die Branche weitgehend ausblendet.
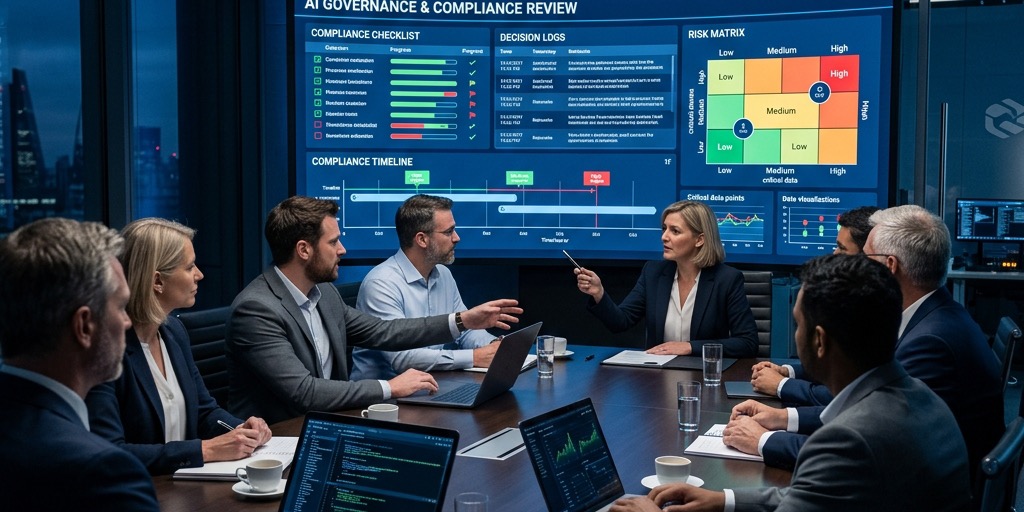
Wenn KI Code erzeugt, wer ist dafür verantwortlich? Wenn eine KI-generierte Funktion eine Sicherheitslücke einführt, die zu einem Datenleck führt, liegt die Haftung dann beim Entwickler, der den Vorschlag übernommen hat, beim Team Lead, der den Pull Request freigegeben hat, oder beim Anbieter, der das Tool eingesetzt hat?
Die meisten rechtlichen Rahmen in Unternehmen haben mit dieser Frage noch nicht Schritt gehalten. In regulierten Branchen – Gesundheitswesen, Finanzen, öffentliche Hand – ist das kein abstraktes Thema. Auditoren wollen wissen, wer den Code geschrieben hat und ob ihn ein qualifizierter Mensch geprüft hat. „Eine KI hat es geschrieben, und ein Entwickler hat auf Freigeben geklickt“ wird einen SOC-2-Auditor nicht zufriedenstellen.
Wir nehmen das ernst, weil unsere Kunden genau in solchen Umfeldern arbeiten. Jeder KI-generierte Code, der in unsere Delivery-Pipeline gelangt, durchläuft denselben Review-Prozess wie von Menschen geschriebener Code: Peer Review, automatisierte Sicherheitsscans und ausdrückliche Freigabe durch einen Senior Engineer. Wir pflegen eine vollständige Nachverfolgbarkeit – Sie sehen genau, welche Teile der Codebasis KI-unterstützt entstanden sind und wer sie geprüft hat.
Das ist keine Bürokratie um ihrer selbst willen. Es ist die Grundlage von Vertrauen. Wenn Sie KI-unterstützten Code nicht mit derselben Strenge auditieren können wie von Menschen geschriebenen, sollten Sie KI nicht in der Produktion einsetzen.
Wohin das alles führt
Wir stehen noch am Anfang. Die heute verfügbaren KI-Tools sind bei aller Leistungsfähigkeit die erste Generation. Sie werden besser. Die Modelle werden den Kontext besser erfassen, große Codebasen besser verstehen und in ihren Architekturvorschlägen verlässlicher werden. Der Abstand zwischen „KI-unterstützter“ und „AI-First“-Entwicklung wird kleiner.
Die Grundlagen aber bleiben. Softwarelieferung war im Kern immer ein Kommunikationsproblem. Das Schwierige ist, zu verstehen, was Menschen wollen, und das in etwas zu übersetzen, das eine Maschine ausführen kann. KI macht die Ausführung günstiger, doch das Verstehen bleibt teuer – und menschlich.
Was sich ändern wird, ist die Form erfolgreicher Delivery-Partnerschaften. Erfolgreich sein werden die Anbieter, die KI tatsächlich in ihre Arbeitsabläufe integriert haben – nicht als Marketing-Spielerei, sondern als struktureller Vorteil, der pro Dollar mehr Wert liefert. Sie werden nach Ergebnissen abrechnen, mit Senior-lastigen Teams arbeiten und die Governance-Rahmen pflegen, die Enterprise-Kunden verlangen.
Verlieren werden die Anbieter, die weiter Personal verkaufen und Stunden zählen und hoffen, dass ihre Kunden nicht merken, dass ein Team aus fünf Personen mit KI-Tools ein Team aus fünfzehn ohne sie übertreffen kann.
Bei GTEMAS haben wir unsere Entscheidung getroffen. Wir bauen unsere Delivery-Organisation, angetrieben von FastDX, auf der Annahme auf, dass KI ein dauerhafter Teil der Engineering-Landschaft ist und kein Trend, der wieder verschwinden könnte. Unsere Teams, unsere Prozesse, unsere kommerziellen Modelle – alle sind für eine Welt ausgelegt, in der menschliches Urteilsvermögen und Maschinenleistung zusammenarbeiten. Nicht, weil es im Pitch Deck gut klingt, sondern weil es das einzige Modell ist, das auch dann funktioniert, wenn man sich hinsetzt und nachrechnet.
Die Unternehmen, die das zuerst begreifen, werden einen spürbaren Vorteil haben. Nicht nur bei der Geschwindigkeit, obwohl sie schneller sein werden. Sondern bei Qualität, Planbarkeit und der Fähigkeit, sich anzupassen, wenn sich Anforderungen mitten im Projekt unweigerlich ändern. Denn das tun sie. Sie tun es immer. Die Frage ist, ob Ihr Delivery-Modell das gelassen verkraftet oder jedes Mal zerbricht, wenn jemand sagt: „Eigentlich muss es ein wenig anders funktionieren.“
Das ist das eigentliche Versprechen von KI in der Enterprise-Lieferung. Nicht schneller tippen. Besser denken.